コールセンターの応対品質評価をAIで全件化すると何が変わるのか

国内のコンタクトセンターで、応対品質を評価できている割合はどれくらいか。PKSHAのCXジャーナルは「コンタクトセンター応対品質マネジメント白書2026」の調査結果として、品質評価できている応対が「10%以下」と回答した組織が6割以上にのぼると紹介している。つまり大半のセンターでは、9割の応対が誰にも評価されないまま流れている。生成AIと音声認識の組み合わせで、この評価を全件に広げられる環境が技術的には整った。では、サンプル評価を全件評価に置き換えると、現場では何が変わるのか。本稿の立場を先に言えば、全件化の本当の効果は「評価件数が増えること」ではなく、評価基準の言語化とスコアの用途設計を組織に強制することにあると見ている。
1. サンプル評価はどれくらい「見えていない」のか
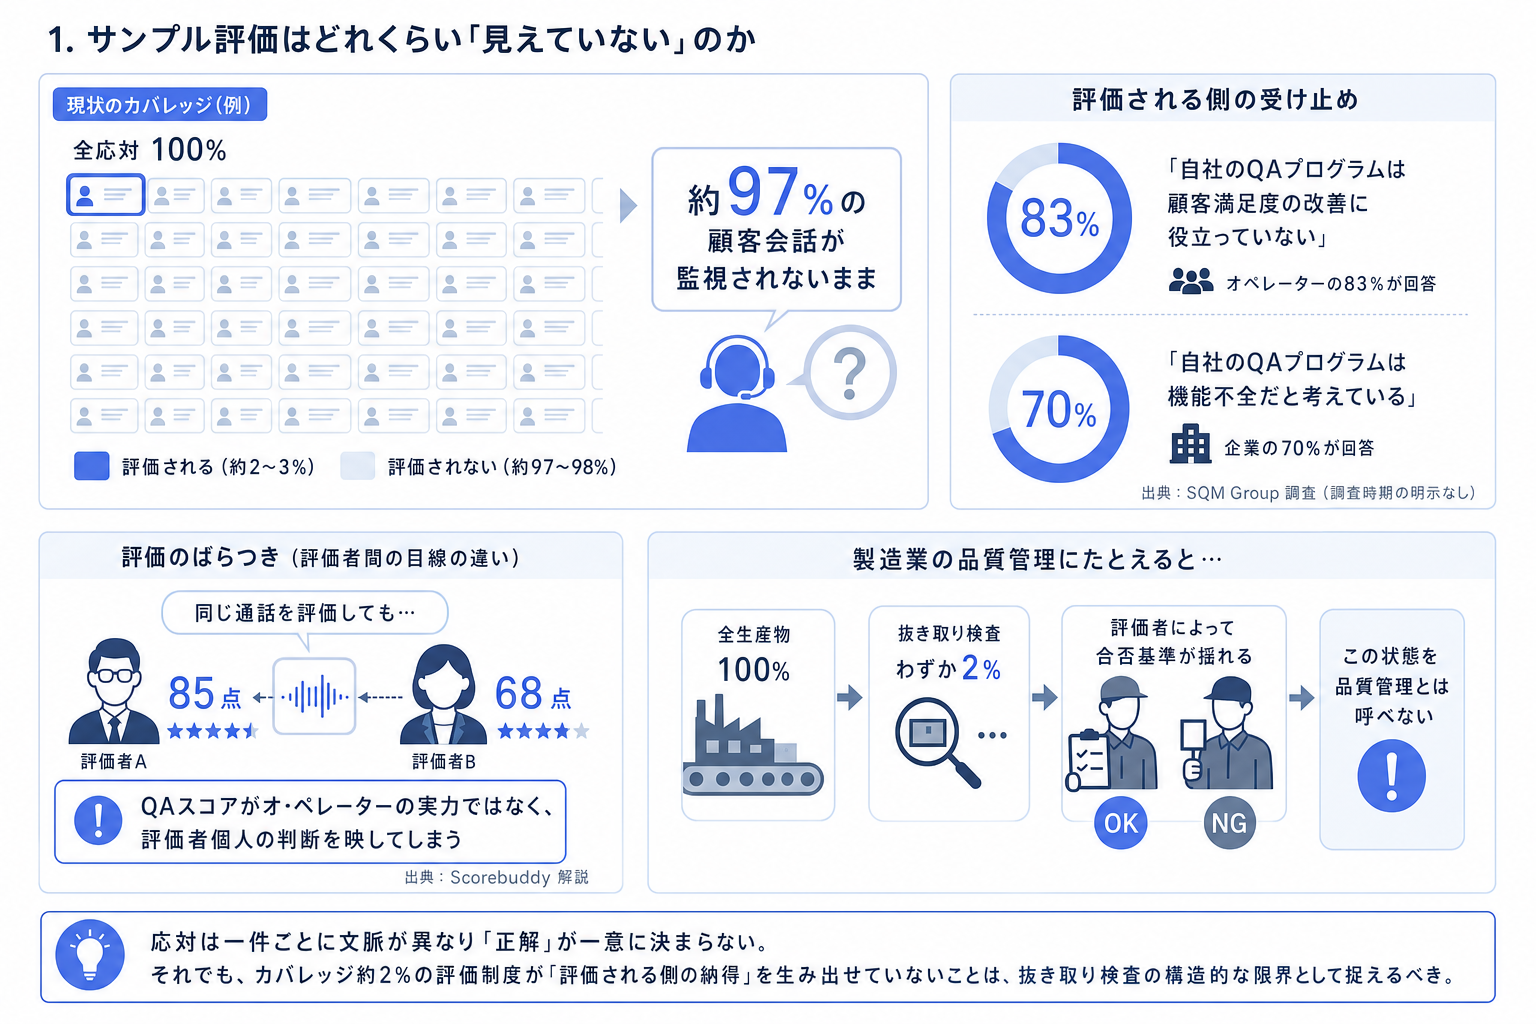
まず現状の規模感を確認する。海外でも構図は同じで、自動品質監視を提供するAI QMSの解説は、従来型のQA(品質保証)プログラムが評価するのは全応対のごく数%で、約97%の顧客会話が監視されないまま残ると指摘する(ベンダー解説・自社サービスの訴求を含む)。国内の白書2026の「1割以下が6割超」という数字と、桁感はきれいに一致する。
評価される側の受け止めも良くない。QA専業のSQM Groupの調査では、オペレーターの83%が「自社のQAプログラムは顧客満足度の改善に役立っていない」と答え、7割の企業が自社のQAプログラムは機能不全だと考えている(同社調査・調査時期の明示なし)。評価のばらつきも構造的な問題で、Scorebuddyの解説は、キャリブレーション(評価者間の目線合わせ)を欠くと、同じ通話がある評価者では85点、別の評価者では68点になり得るとし、QAスコアがオペレーターの実力ではなく評価者個人の判断を映してしまうと指摘する(同社解説)。
製造業と比べるとわかりやすい。製造ラインの品質管理で「全生産物の2%だけ抜き取り検査し、評価者によって合否基準が揺れる」状態なら、品質管理とは呼ばれない。もちろん、応対は工業製品と違って一件ごとに文脈が異なり、「正解」が一意に決まらない。だから単純比較はできないが、カバレッジ2%の評価制度が「評価される側の納得」を作れていないという調査結果は、抜き取り検査の構造的な限界として読める。
2. なぜ今、全件化できるのか
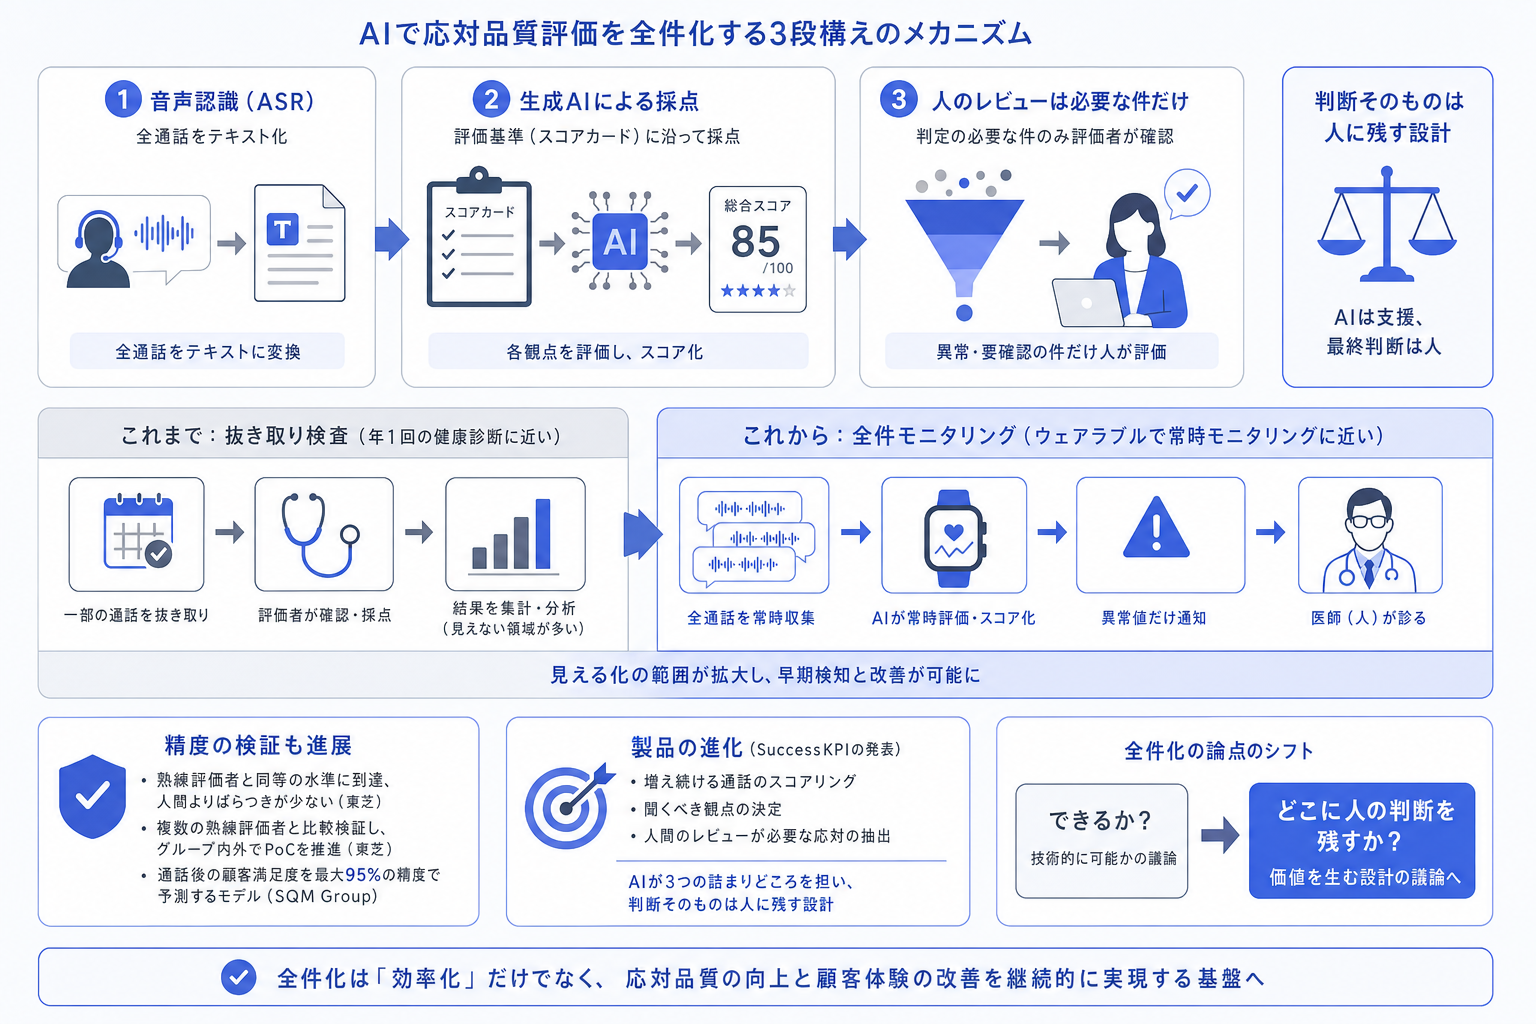
技術的なメカニズムは3段構えである。第一に音声認識で全通話をテキスト化し、第二に生成AIが評価基準(スコアカード)に沿って各応対を採点し、第三に人間の評価者が判定の必要な件だけを見る。健康診断にたとえるなら、年1回の抜き取り検査から、常時装着のウェアラブルで全データを取り、異常値だけ医師が診る方式への移行に近い。
精度の検証も進んでいる。東芝の技術カタログは、熟練評価者の評価基準をパラメータとして取り込むことで、生成AIによる応対品質評価が熟練評価者と同等の水準に達し、人間より評価のばらつきが少ないとする。同社は実証実験レポートで複数の熟練評価者とAIの評価結果を比較検証しており、グループ内外でPoC(概念実証)を重ねている段階だ(同社発表・本番導入の成果数値は未公表)。SQM Groupも、AIと機械学習で通話後の顧客満足度を最大95%の精度で予測するモデルを訴求している(同社発表・自己申告)。
製品側の動きは今週も続いた。SuccessKPIの2026年9月3日の発表は、増え続ける通話のスコアリング、聞くべき観点の決定、人間のレビューが必要な応対の抽出という3つの詰まりどころをAIに担わせ、判断そのものは人に残す設計を明確に打ち出した。全件化の論点が「できるか」から「人の判断をどこに残すか」へ移っていることを示す発表だと読んでいる。
3. 全件化で起きる3つの変化
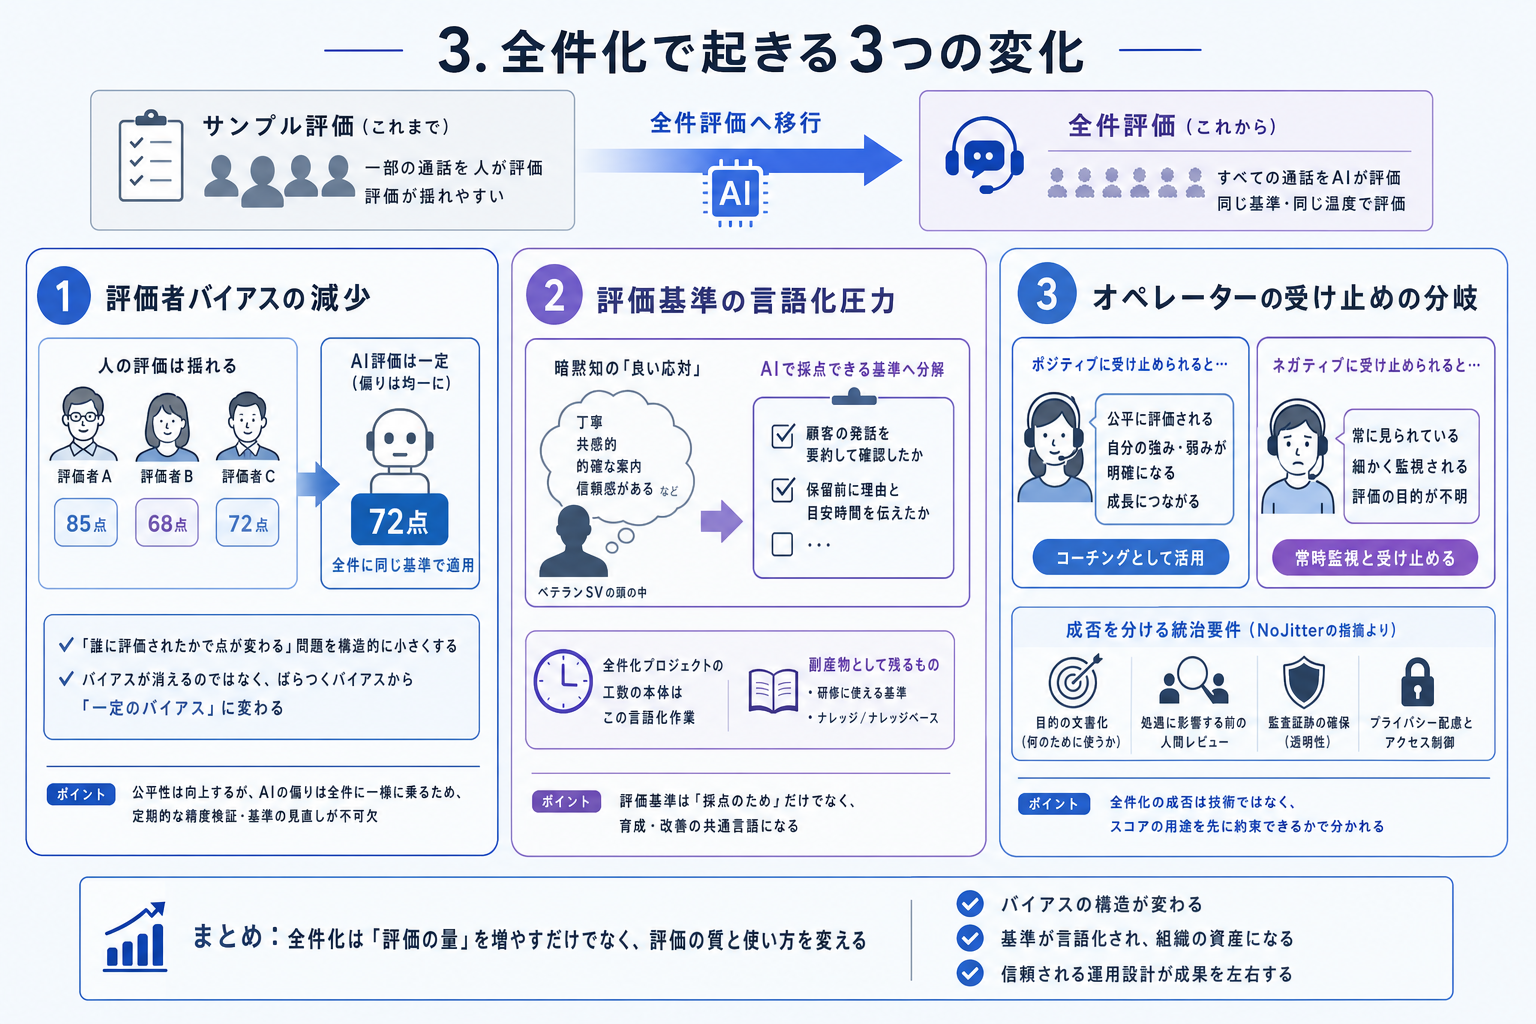
サンプル評価から全件評価への移行で、実際に変わるのは次の3点である。
第一に、評価者バイアスの減少。 人間の評価は、評価者の疲労・慣れ・オペレーターとの関係性で揺れる。東芝の実証が示すように、AIは同じ基準を全件に同じ温度で当てるため、同じ通話が85点にも68点にもなる「誰に評価されたかで点が変わる」問題は構造的に小さくなる。ただし、AIの評価が偏っていた場合はその偏りも全件に一様に乗る。バイアスが消えるのではなく、ばらつくバイアスから一定のバイアスに変わる、と言う方が正確だろう。
第二に、評価基準の言語化圧力。 これが最も見落とされやすい。ベテランSVの頭の中にある「良い応対」をAIに採点させるには、暗黙知をスコアカードの文言に落とすしかない。「共感的な応対」では採点できず、「顧客の発話を要約して確認したか」「保留前に理由と目安時間を伝えたか」まで分解する必要がある。全件化プロジェクトの工数の本体は、AIの設定ではなくこの言語化作業であり、副産物として研修・ナレッジにも使える評価基準が残る。
第三に、オペレーターの受け止めの分岐。 全件評価は「公平になった」とも「常時監視されている」とも受け取られ得る。NoJitterの2026年8月末の論考は、リアルタイムAIコーチングと常時監視が同じ技術の裏表であり、目的の文書化・処遇に影響する前の人間レビュー・監査証跡という統治要件を欠くと「コーチングの衣装を着た監視」になると警告する。全件化の成否は技術ではなく、スコアの用途を先に約束できるかで分かれる。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。