Zendeskのリアルタイム音声翻訳は「言語別キュー」をなくすのか ー 翻訳より先に変わるのはルーティングと要員計画

2026年9月10日、Zendeskはコンタクトセンター製品「Zendesk Contact Center」に、通話をその場で双方向に訳す「Real-Time Voice Translation」を加えると発表しました。同社の発表によると、顧客とオペレーターはそれぞれ自分の話しやすい言語で話し、AIが通話中に訳します。提供は10月から、Zendesk Contact Center Nativeを使う対象顧客に向けたクローズドの早期アクセスプログラム(closed EAP)です。
発表文が狙いとして挙げたのは、翻訳そのものより窓口の組み方でした。通訳、言語別のキュー、メールやSMSへの誘導に頼らずに音声の窓口を広げられるとし、言語別キューへ自動で転送しなくても、用件とオペレーターの専門性にもとづいて通話を振り分けられる、と書いています。
時系列も押さえておきます。同社は2月12日、電話の自動応答を担うvoice AI agentsの早期アクセスを開きました。この時点の対象は同社の電話機能(Zendesk voice、Talk)で、Contact Centerへの対応は後の段階とされていました。6月9日には、Contact Centerを担当者の作業画面(Agent Workspace)に組み込んだネイティブ版の一般提供を告知しています。入口のAI、オペレーターの作業画面、そして今回の通話翻訳と、音声の部品を順に発表してきた流れの上に今回の発表があります(voice AI agentsのContact Center対応が始まったかは、公開情報では確認できていません)。
問いは一つです。翻訳が実用になったとき、日本語窓口と英語窓口を分ける「言語別キュー」は要るのか。私の答えは、すぐには消えない。ただし言語は「最初に分ける軸」から「振り分けの条件の一つ」へ下がり始める。そして今回の早期アクセスの制限を読む限り、その変化が最初に効くのは、少量で需要の読めない言語の、一対一で完結する用件です。
この記事の要点
①発表は一般提供ではなく、10月からのclosed EAP。対応言語はヘルプ記事の列挙どおりで、翻訳を有効にした通話は、転送や、SVのモニタリング・割り込み(バージ)に対応しない。品質と遅延は言語や音声条件で変わると同社自身が書いている
②言語別キューは、アーラン式で見ると「小さな行列」を別に抱える設計で、少量の言語ほど席を空けておく必要がある。翻訳はその薄い行列を太い行列へ合流させる手段になりうる。ただし翻訳通話の処理時間が延びれば、効果は相殺される
③遅延・誤訳・固有名詞・本人確認・録音の扱いは、翻訳の外側で設計する必要がある。多言語人材は減らす対象ではなく、高リスク会話と品質管理へ配置を変える対象として考えたい
1. 発表を分解する。何が決まり、何がまだ決まっていないか
発表文とヘルプ記事の記述を、提供段階と留保に分けて並べます。
項目 | 原文の記述(要旨) | 現時点の確度・留保 |
|---|---|---|
提供段階 | 10月から、Zendesk Contact Center Nativeを使う対象顧客にclosed EAPで提供 | 一般提供ではない。ヘルプ記事は「開発中で変更の可能性がある」としている。ヘルプ記事のプラン表示はContact Centerのアドオン。料金は公開情報に無い |
対応言語 | 中国語、英語、フランス語、ドイツ語、ヒンディー語、インドネシア語、イタリア語、日本語、韓国語、ポルトガル語、ロシア語、スペイン語、ベトナム語 | EAP期間中の列挙。発表文ではなくヘルプ記事の記載。どの言語の組み合わせで訳せるかは書かれていない |
仕組み | 各参加者が自分の言語で話し、相手の発話のAI生成翻訳を聞く | 相手の発話の翻訳を音声で聞く方式(画面表示の有無は記載なし) |
言語の決め方 | 接続前にコンタクトフローやvoice AI agent等で決める。または通話中にオペレーターがオン・オフする | 接続前に決めた場合、オペレーターは応答前に翻訳通話であることを通知される |
録音 | 原音声、翻訳音声、その両方のどれを残すかを管理者が選べる | どれを記録の正本にするかは導入側が決める |
非対応 | 多者通話、転送された通話、モニタリング・バージ、ビデオ通話 | EAP期間中、翻訳を有効にした通話での制限 |
品質 | 言語、音声品質、訛り、ネットワーク状況で品質と遅延が変わりうる | 誤訳率や遅延の数値、参加企業の事例は公開情報に無い |
参加条件 | 構造化されたフィードバックと定期的なセッションへの参加。利用前にオペレーター研修と試験通話 | 利用量にはEAPの上限がある |
ヘルプ記事は、この機能で言語別キューや多言語要員、通訳への依存を減らせるとし、通話を言語の流暢さ「だけ」ではなく顧客の必要とオペレーターの専門性で振り分けられる、と書いています。「だけ」の一語は読み落とさない方がよいでしょう。本文は、言語を振り分けの条件から外すとまでは書いていません。
発表文は同社の調査として、音声がコンタクトセンターの対応量の40%を占めるとしています。CX Todayの解説記事は、急ぎ・感情的・複雑・金銭が絡む用件では顧客が電話を選ぶことが多い点を挙げています。
先行する動きを、形式の違いで並べます。
提供者(発表日) | 何をするか | 段階 |
|---|---|---|
Zendesk(2026年9月10日) | オペレーターと顧客の通話を双方向に音声で翻訳。ルーティングを持つCCaaS製品の中に組み込む | 10月からclosed EAP |
DeepL Voice API(2026年2月2日) | リアルタイムの音声文字起こしと、最大5言語への翻訳をAPIで提供 | API Pro契約者向けに提供開始。音声から音声への翻訳は、2月中旬から6週間の早期アクセスを予定(2月2日の発表時点) |
Zoom Contact Center(2026年3月10日) | AI Expert Assistの機能「Live AI Interpreter」として、音声・ビデオの会話を音声から音声へリアルタイムに翻訳 | 2026年3月中旬の提供予定として発表 |
X-HACK ContactX(2026年7月23日) | AIが一次受付・自動応答し、書き起こしと要約を日本語で記録 | 提供開始。判断が必要な案件は有人へ引き継ぐ設計 |
DeepLの発表は、すでに「言語力よりも“専門性”を軸にした人材配置が可能に」という見出しを立て、コンタクトセンターとBPO事業者が初期導入の中心になる見込みだとしていました。専門性で配置するという発想そのものは、Zendeskが初めて言い出したものではありません。DeepLは既存システムに組み込むAPIです。コンタクトセンター製品の中に通話翻訳を置く動きも、Zendeskが最初ではありません。Zoomは3月、自社のコンタクトセンター製品に、音声から音声へ訳す「Live AI Interpreter」を加えると発表していました。Zendeskの発表で目を引くのは、翻訳の置き場所そのものより、ルーティングの話として打ち出した点です。振り分けと翻訳を同じ製品が握るので、「言語で分けない」設定をルーティングの側から直接組める、というのが今回の構図です。
2. 言語別キューが要員効率を下げる構造
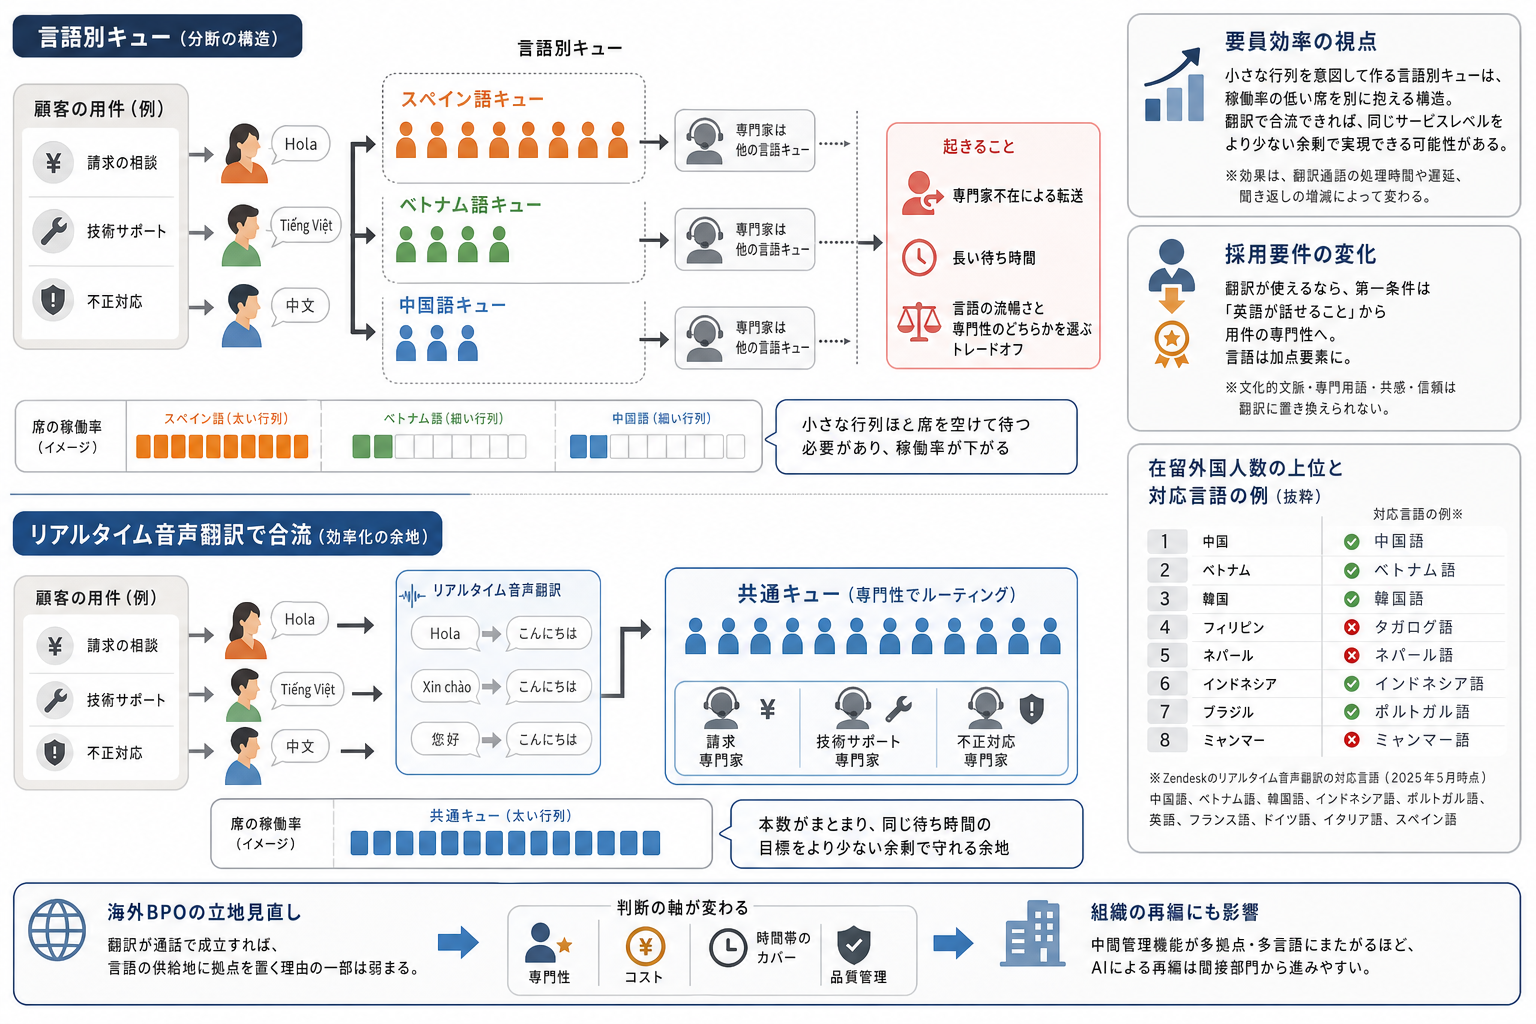
言語別キューの弱点を、CX Todayは具体例で書いています。請求や技術サポート、不正対応の専門家が必要な用件でも、顧客はスペイン語のキューに入れられることがある。その結果、言語の流暢さと製品の専門性のどちらかを選ぶことになりかねず、顧客は転送と長い待ち時間でその代償を払うことが多い、というものです。
要員計画の側から見ると、もう一つの弱点があります。当ラボが9月に解説したアーラン式の記事では、同じサービスレベルを守るのに必要な席の稼働率が、入電の少ないセンターほど低くなることを整理しました。電話が重なる「たまたま」は本数が多いほど均されるので、小さな行列ほど席を空けて待つ必要がある、という確率の性質です。
以下は当ラボの説明で、特定の製品の効果測定ではありません。言語別キューは、この小さな行列を意図して作る設計です。日本語の太い行列の横に英語や中国語の細い行列を並べると、細い行列の側は稼働率の低い席を別に抱えることになります。翻訳で細い行列を太い行列へ合流させられるなら、同じ待ち時間の目標をより少ない余剰で守れる余地が生まれます。
ただし、合流の効果は翻訳通話の処理時間しだいです。遅延や確認の聞き返しで通話ごとの処理時間が延びれば、合流で浮いた余剰は削られます。また、用件ごとに担当が分かれていれば、センターをひとつの行列とみなす式の前提はもともと外れています。効果の大きさは、翻訳通話と母語通話の処理時間を並べて測るまで分かりません。
採用要件も動きます。翻訳が使えるなら、求人の第一条件は「英語が話せること」から用件の専門性に移り、言語は加点要素に下がります。ただしCX Todayは、多言語オペレーターの価値が突然失われるわけではないとし、文化的な文脈、専門用語、共感、信頼は翻訳された音声に置き換えられないと書いています。
出入国在留管理庁の発表では、令和7年末の在留外国人数は412万5,395人で、初めて400万人を超えました。国籍・地域別の上位は中国、ベトナム、韓国、フィリピン、ネパール、インドネシア、ブラジル、ミャンマーの順です。
この並びを今回の対応言語の列挙と照らすと、中国語、ベトナム語、韓国語、インドネシア語、ポルトガル語、英語は列挙にあります。一方でネパール語、ミャンマー語、タガログ語は列挙にありません。国籍と通話で使う言語は一致しないので単純な対応づけはできませんが、生活や手続きの窓口で必要になる言語ほど、今回の列挙から外れやすいことは読み取れます。当ラボが7月に書いた多言語AI対応の地図で、観光の言語と生活の言語のずれとして整理した構図が、ここでも表れています。
海外BPOの立地も、同じ論理で見直しの対象になります。CX Todayの週次ラウンドアップは、多言語対応はこれまで、高価な言語専門要員のプールを抱えるか、外部委託するか、翻訳しやすいテキストチャネルへ顧客を寄せるかの選択だったと整理しています。ここからは当ラボの見方ですが、翻訳が通話で成立すれば、言語の供給地に拠点を置く理由の一部は弱まり、立地の判断は専門性、コスト、時間帯のカバー、品質管理の側へ寄ります。当ラボが扱ったテレパフォーマンスの再編でも、中間管理機能が複数拠点・複数言語にまたがって重複している組織ほど、AIによる再編が間接部門から進みやすいと書きました。
3. 留保。翻訳の外側で設計しなければならないこと
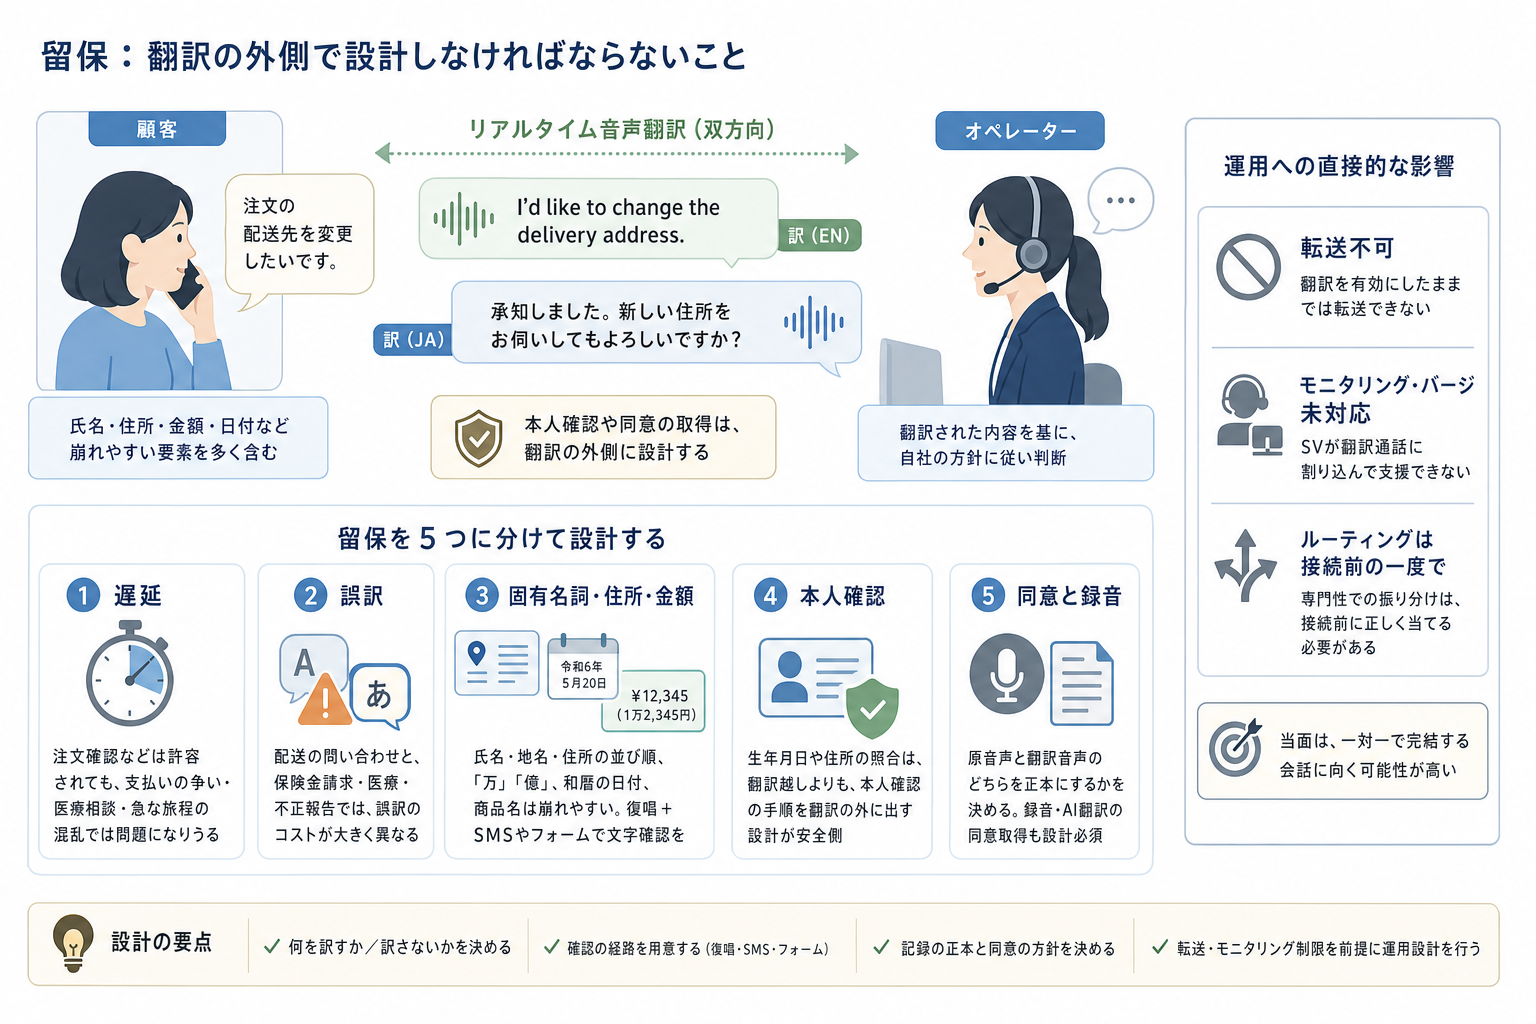
ヘルプ記事は、翻訳された会話ではオペレーターが自分の判断で自社の方針に従うよう求めています。留保を5つに分けます。
遅延。 CX Todayは、注文状況の確認なら少しの遅れは許容できても、支払いの争い、医療の相談、急な旅程の混乱では問題になりうると書いています。
誤訳。 週次ラウンドアップは、配送の問い合わせの誤訳と、保険金請求・医療・不正報告の誤訳は別物だとしています。誤訳のコストは、用件の種類で大きく変わります。
固有名詞・住所・金額。 ここからは当ラボの見方です。日本語の氏名や地名、住所の並び順、「万」「億」の単位、和暦の日付、商品名は、訳の中で崩れやすい要素です。口頭の復唱に加えて、SMSやフォームで文字として確かめる経路を用意しておきたいところです。
本人確認。 同社は2月のvoice AI agentsの早期アクセスで、規制対象の個人情報の扱いや、多言語・方言の会話を改善の重点に挙げていました。今回の翻訳とは別の機能ですが、音声で個人情報を扱う場面を同社も難所と見ていることは読み取れます。生年月日や住所を翻訳越しに照合するより、本人確認の手順だけを翻訳の外に出す設計の方が安全側です。
同意と録音。 原音声と翻訳音声のどちらを残すかを選べるのは、裏返せば、何を記録の正本にするかを導入側が決めなければならないということです。顧客が実際に言ったことは原音声に、オペレーターが聞いたことは翻訳音声に残ります。「言った・言わない」の争いでどちらを参照するか、AIで訳していることを顧客にどう伝えるかは、社内規程と照らして決める必要があります。法的な扱いは専門家への確認を勧めます。
さらに、翻訳を有効にした通話が転送やモニタリング・バージに対応しないという制限は、運用に直接効きます。CX Todayは、当面はエスカレーションを要する複雑な対応より、一対一で完結する会話に向くかもしれないと書きました。翻訳を有効にしたままでは転送できないので、専門性での振り分けは接続前の一度で当てる必要があり、SVが翻訳通話に割り込んで助けることも当面はできません。
4. ラボの見立て。言語は「最初の分岐」から「条件の一つ」へ
ここからは私の見立てです。
リアルタイム音声翻訳が変えるのは、言語別キューの有無より、振り分けの順番だと考えます。これまでは「言語で分ける、次に用件で分ける」でした。翻訳が使えるなら「用件と専門性で分ける、言語は条件として見る」に並べ替えられます。現実的には、母語で対応できるオペレーターが空いていればそちらへ、待ち時間が閾値を超えたら翻訳で専門の担当者へ、という併用から始まるでしょう。言語はキューの境界から、スキルの属性の一つへ下がります。
ヘルプ記事が接続前の言語判定の手段にvoice AI agentを挙げている点も、この見立てと整合します。言語の識別は、人のオペレーターの手前、AIの入口へ移っていきます。
自己反証を2つ置きます。
第一に、EAP段階では品質のデータがありません。品質と遅延は言語ごとに違うと同社自身が書いている以上、日本語と英語で成立した運用が、日本語とベトナム語で成立するとは限りません。見立てが外れるとすれば、翻訳通話の処理時間が母語通話より大きく延び、合流の効果が消える場合です。
第二に、差は言語だけではありません。文化、敬語、商習慣の差は訳の外に残ります。とくに日本語を話さないオペレーターが翻訳越しに日本語の顧客を受ける逆向きの使い方では、敬語やお詫びの言い回しへの期待が高いぶん、違和感が出やすいはずです。翻訳で海外拠点から日本語窓口を運営する発想には、強い制約がかかると私は見ています。
5. SV・センター長への示唆
導入を検討する前に決めておきたいことを4点にまとめます。
第一に、試すなら「薄い言語×定型の用件」から。 少量で需要の読めない言語の、住所変更、配送照会、予約確認のように一対一で完結する用件が候補です。支払いの争い、医療の相談、不正や事故の報告、苦情は、品質のデータが出るまで対象から外します。
第二に、評価は翻訳の正確さ単体ではなく、通話単位の業務指標で。 翻訳通話と母語通話で、処理時間、聞き返しの回数、再入電、エスカレーション率、顧客満足度を並べます。オペレーターが通話中に翻訳を切った頻度も、使いにくさの信号として記録します。
第三に、エスカレーションと記録の設計を先に決める。 EAPの制限のもとでは、翻訳を有効にした通話は転送もSVの割り込みもできません。専門性での振り分けを接続前に当てる設計、翻訳で行き詰まったときの退避手順(翻訳を切る、母語話者や通訳へかけ直す)、原音声と翻訳音声のどちらを残すかを、導入前に文章にしておきます。
第四に、多言語人材は配置を変える対象として考える。 高リスクの会話、翻訳通話の品質評価、固有名詞や商品名の対訳集の整備は、言語が分かる人にしかできません。採用要件を言語から専門性へ移すなら、既存の多言語オペレーターの役割と評価も同時に見直す必要があります。
6. 結び
第一に、Zendeskの発表は一般提供ではなく、10月からのclosed EAPです。対応言語はヘルプ記事の列挙どおりで、翻訳を有効にした通話は転送やモニタリングに対応せず、品質と遅延の数値もまだ公開されていません。
第二に、翻訳が変えるのは振り分けの順番です。言語別キューは小さな行列を別に抱える設計で、翻訳はそれを太い行列に合流させる手段になりえます。効果の大きさは、翻訳通話の処理時間を測るまで分かりません。
第三に、遅延、誤訳、固有名詞、本人確認、録音の正本は、翻訳の外側で決める問題です。多言語人材の価値は消えず、高リスク会話と品質管理の側へ移ります。
あなたのセンターの言語別キューは、いま何件の電話を受け、その席はどれだけ空いて待っているでしょうか。翻訳の導入を検討する前に、その数字を言語ごとに並べておくことを勧めます。
注記:本記事の事実関係は、Zendeskの2026年9月10日の発表、同社ヘルプセンターの記事、Zoom、DeepL、X-HACKの発表、出入国在留管理庁の公表資料、CX Todayの記事に基づき、2026年9月11日時点で確認したものです。Real-Time Voice Translationは早期アクセス段階の機能で、ヘルプ記事にあるとおり内容は変更される可能性があります。翻訳の品質や遅延、料金について、当ラボは公開情報の範囲を超えて確認していません。在留外国人の国籍と通話で使われる言語は一致しないため、対応言語との照合は目安です。アーラン式に関する記述は当ラボの既往記事の説明に基づくもので、特定の製品の効果を示すものではありません。見立てに関する部分は筆者個人の見解です。本記事は公開情報をもとにした筆者の分析であり、記事作成にはAIによるリサーチ支援を活用しています。
参考リンク
元の発表
Zendesk「Zendesk Expands Contact Center Voice Support Across Languages」(2026年9月10日) https://www.zendesk.co.jp/newsroom/articles/zendesk-expands-contact-center-voice-support-across-languages/
Zendesk help「About real-time voice translation in Contact Center (closed EAP)」 https://support.zendesk.com/hc/en-us/articles/11202642705434-About-real-time-voice-translation-in-Contact-Center-closed-EAP
Zendesk help「Announcing the native Zendesk Contact Center」(2026年6月9日) https://support.zendesk.com/hc/en-us/articles/10876544456346-Announcing-the-native-Zendesk-Contact-Center
Zendesk help「Announcing voice AI agents (EAP)」(2026年2月12日) https://support.zendesk.com/hc/en-us/articles/10231529954074-Announcing-voice-AI-agents-EAP
当ラボの関連記事
AHTを1分縮めると席が4つ減る。コールセンターの「アーラン式」は何を計算しているのか ー 「1人あたり◯分」の稟議が小さく見える本当の理由 https://ccai-lab.com/articles/erlang-c-seat-count-ai-roi
多言語コンタクトセンターのAI対応はどこまで実現したのか ー 言語ごとに違う「できる・できない」の地図 https://ccai-lab.com/articles/2026-07-28-multilingual-voicebot-reality
世界最大のコールセンター企業がAIで削るのは現場ではない ー テレパフォーマンスが名指しした間接部門 https://ccai-lab.com/articles/2026-09-10-teleperformance-ai-restructuring
解決率88%なのに好意は22%、AIコンタクトセンターは「渡し方」でつまずく ー エスカレーション設計という最後の一マイル https://ccai-lab.com/articles/2026-07-12-escalation-design
旅行・航空・宿泊のコールセンターAIはなぜ難しいのか ー 繁忙期スパイク×多言語×高感情の三重苦 https://ccai-lab.com/articles/2026-08-09-travel-airline-cc-ai
外部出典
CX Today「Can Zendesk Cut Multilingual Contact Center Costs With AI?」(2026年9月10日) https://www.cxtoday.com/contact-center/zendesk-real-time-voice-translation-contact-center/
CX Today「Contact Center Weekly Roundup: Zendesk Targets Language Barriers as AI Control Wars Heat Up」(2026年9月10日) https://www.cxtoday.com/contact-center/contact-center-news-zendesk-genesys-ringcentral-verint/
DeepL「DeepL、リアルタイム音声の文字起こし・翻訳を実現する「DeepL Voice API」を提供開始」(2026年2月2日) https://www.deepl.com/ja/press-release/deepl_launches_voice_api_for_real_time_speech_transcription_and_translation
Zoom「Zoom drives connected customer relationships with new agentic AI capabilities」(2026年3月10日) https://news.zoom.com/ec26-zoom-business-services/
X-HACK「AIコールセンター「ContactX」、英語・中国語・韓国語など50以上の言語のリアルタイム書き起こし・翻訳に対応」(2026年7月23日) https://prtimes.jp/main/html/rd/p/000000031.000036760.html
出入国在留管理庁「令和7年末現在における在留外国人数について」 https://www.moj.go.jp/isa/publications/press/13_00062.html
よくある質問
Zendeskのリアルタイム音声翻訳は、いつから使えますか
同社の発表では、10月からZendesk Contact Center Nativeを使う対象顧客に向けて、クローズドの早期アクセスプログラムとして提供されます。一般提供ではなく、参加にはアカウント担当者を通じた資格確認と、構造化されたフィードバックの提供が求められます。ヘルプ記事は開発中で変更の可能性があるとしています。ヘルプ記事上はContact Centerのアドオンの扱いで、料金は公開されていません。
翻訳が使えれば、言語別の窓口は不要になりますか
すぐに不要になるとは言えません。同社のヘルプ記事の本文も、言語の流暢さ「だけ」ではなく用件と専門性で振り分けられると書いており、言語を条件から外すとまでは書いていません。早期アクセス期間は、翻訳を有効にした通話は転送やSVのモニタリング・割り込みに対応せず、品質と遅延は言語や音声条件で変わります。当面は、母語で対応できる担当者と翻訳を併用し、少量で需要の読めない言語から試す形が現実的です。
リアルタイム音声翻訳を試すなら、どの問い合わせから始めるべきですか
住所変更、配送照会、予約確認のように一対一で完結する定型の用件からが候補です。支払いの争い、医療の相談、不正や事故の報告、苦情は、誤訳や遅延のコストが大きいため、品質のデータが出るまで対象から外すことを勧めます。評価は翻訳の正確さ単体ではなく、翻訳通話と母語通話の処理時間、聞き返し、再入電、エスカレーション率を並べて行います。
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
 この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。