コールセンターの呼量予測が当たらない ー 日合計では見えない時間帯の予実差

先週の予測は1,200件、実績は1,214件だった。誤差1.2%。数字だけ見れば優秀な予測である。それでも午前10時台の応答率は78%まで落ち、夕方には手が空いたオペレーターさんが待機していた。
この状況で「予測精度を上げよう」と言っても、改善の打ち手は出てこない。日合計の誤差が小さいことと、時間帯ごとに人が足りていることは、まったく別の話だからである。 日合計というのは、午前の過少予測と夕方の過大予測が打ち消し合った後の数字にすぎない。
本稿は、通常日における時間帯別の予実評価をどう設計するかに絞る。台風や大規模障害のような異常日の扱いは、予測の入力データ側を補正する別の論点であり、ここでは扱わない。扱うのは、特別なことが何も起きていない平日に、なぜ繁忙時間帯だけ崩れるのかである。なお本稿で示す手順・粒度・頻度の例はすべて編集部の実務設計案であり、業界標準や特定製品の推奨ではない。
1. 粒度を下げるほど誤差は増える、という前提
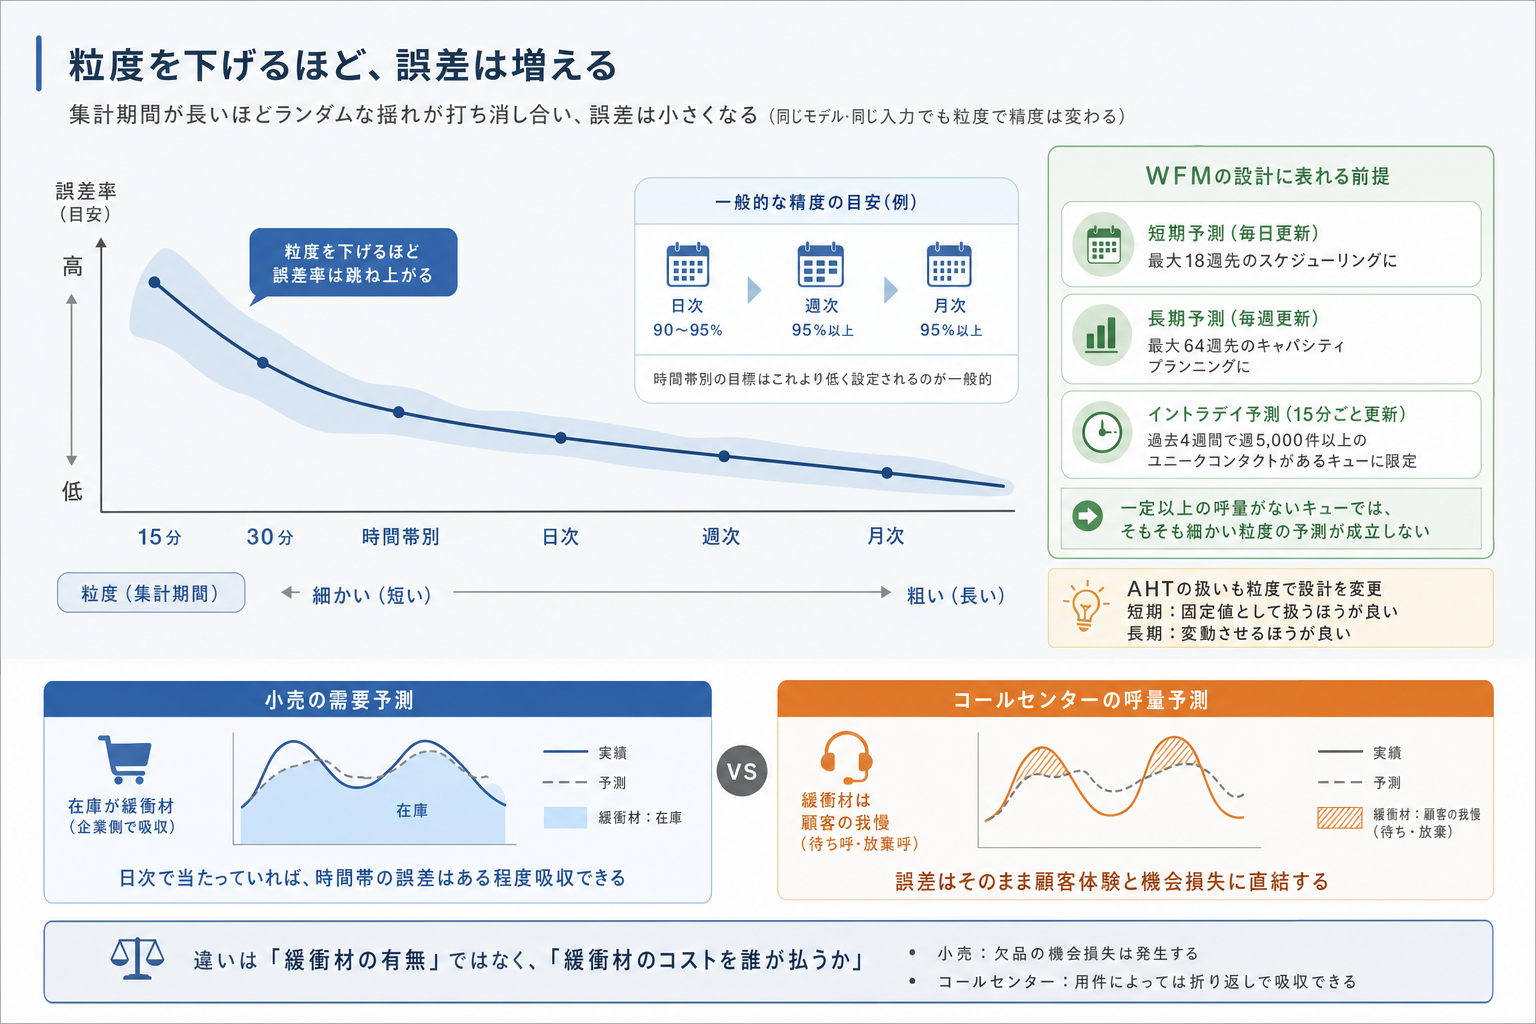
最初に受け入れておくべき事実がある。時間帯別の予測は、日次の予測より必ず当たらない。 これは予測モデルの出来の問題ではなく、統計上の必然である。長い期間で集計するほどランダムな揺れが打ち消し合うため、日次より週次、週次より月次のほうが誤差率は小さくなる。逆に30分や15分の粒度まで下げれば、同じモデル・同じ入力でも誤差率は跳ね上がる。
ベンダー側の解説でも同じ前提が置かれている。Decagonの用語解説は、よく運営されているコンタクトセンターが日次で90〜95%、週次・月次で95%以上の精度を目標に置くのが一般的だとしたうえで、時間帯別の目標はこれより低く設定されると説明している(ベンダー発表の解説であり、出典となる調査は明示されていない)。数字そのものより、粒度ごとに目標値を変えるという考え方のほうを持ち帰りたい。
このことは主要なWFM基盤の設計にも表れている。Amazon Connectの予測・キャパシティプランニング・スケジューリングの管理者ガイドによれば、短期予測は毎日自動更新され最大18週先までのスケジューリングに、長期予測は毎週更新され最大64週先までのキャパシティプランニングに使われる。日中の変動を追うイントラデイ予測は15分ごとに更新されるが、これは「過去4週間において、キューとチャネルの組み合わせごとに週5,000件以上のユニークコンタクト」があるキューに限って生成される(いずれも同ドキュメントの記載。2026年9月時点)。つまり呼量が一定以上ないキューでは、そもそも細かい粒度の予測が成立しないと製品側が前提を置いている。
同ガイドはもう一点、平均処理時間(AHT)の扱いについても短期と長期で設計を変えている。短期のワークロード予測では、AHTを固定値として扱うほうが結果が良い。長期予測では、AHTを変動させるほうが良い。粒度が違えば、良い前提そのものが違うという設計思想がここに現れている。
当て馬として小売の需要予測を置くと、構造の違いがわかりやすい。小売では在庫という緩衝材があるため、日次で当たっていれば時間帯の誤差はある程度吸収できる。コールセンターの在庫にあたるのは待ち呼と放棄呼、つまり顧客の我慢である。緩衝材が顧客側にあるという点で、同じ「予測が外れた」でも損失の出方が根本的に違う。ただしこの対比を単純化しすぎるのも危険で、小売でも欠品の機会損失は発生するし、コールセンターでも用件によっては折り返しで吸収できる。違いは緩衝材の有無ではなく、緩衝材のコストを誰が払うかにある。
2. 誤差指標が隠してしまうもの
時間帯別に見ると決めたとして、次に問題になるのが「何をもって外れたと判定するか」である。ここで広く使われるMAPE(平均絶対パーセント誤差)には、実務上見落とされやすい性質が二つある。
一つは、過少と過大を区別しないことである。Call Centre Helperの解説にあるとおり、MAPEは誤差を絶対値で扱うため、100件の予測に対して実績120件でも80件でも同じ20%として集計される。だが現場の損失はまったく違う。過少予測は待ち時間と放棄、そして残ったオペレーターさんへの負荷に化ける。過大予測は人件費と待機時間になる。前者は顧客が払い、後者は会社が払う。同じ20%として平均してしまうと、この非対称が見えなくなる。
もう一つは、分母の性質による歪みである。WFM Labsのまとめが指摘するように、MAPEは各区間の実績を分母に取るため、実績が小さい区間の誤差率が過大に効く。夜間や早朝のように実績が数件しかない時間帯で1件外すと、誤差率は数十パーセントになる。実績ゼロの区間に至っては、分母がゼロになって計算自体が成立しない。この状態で全区間を単純平均すると、呼量の少ない時間帯の数字に全体が引きずられる。
例えると、燃費を測るのに、高速道路の巡航区間と駐車場での切り返しを同じ重みで平均するようなものである。切り返しの燃費は極端に悪いが、それは車の性能というより測り方の問題になる。
3. 決めるべき4点 ー 編集部の実務設計案
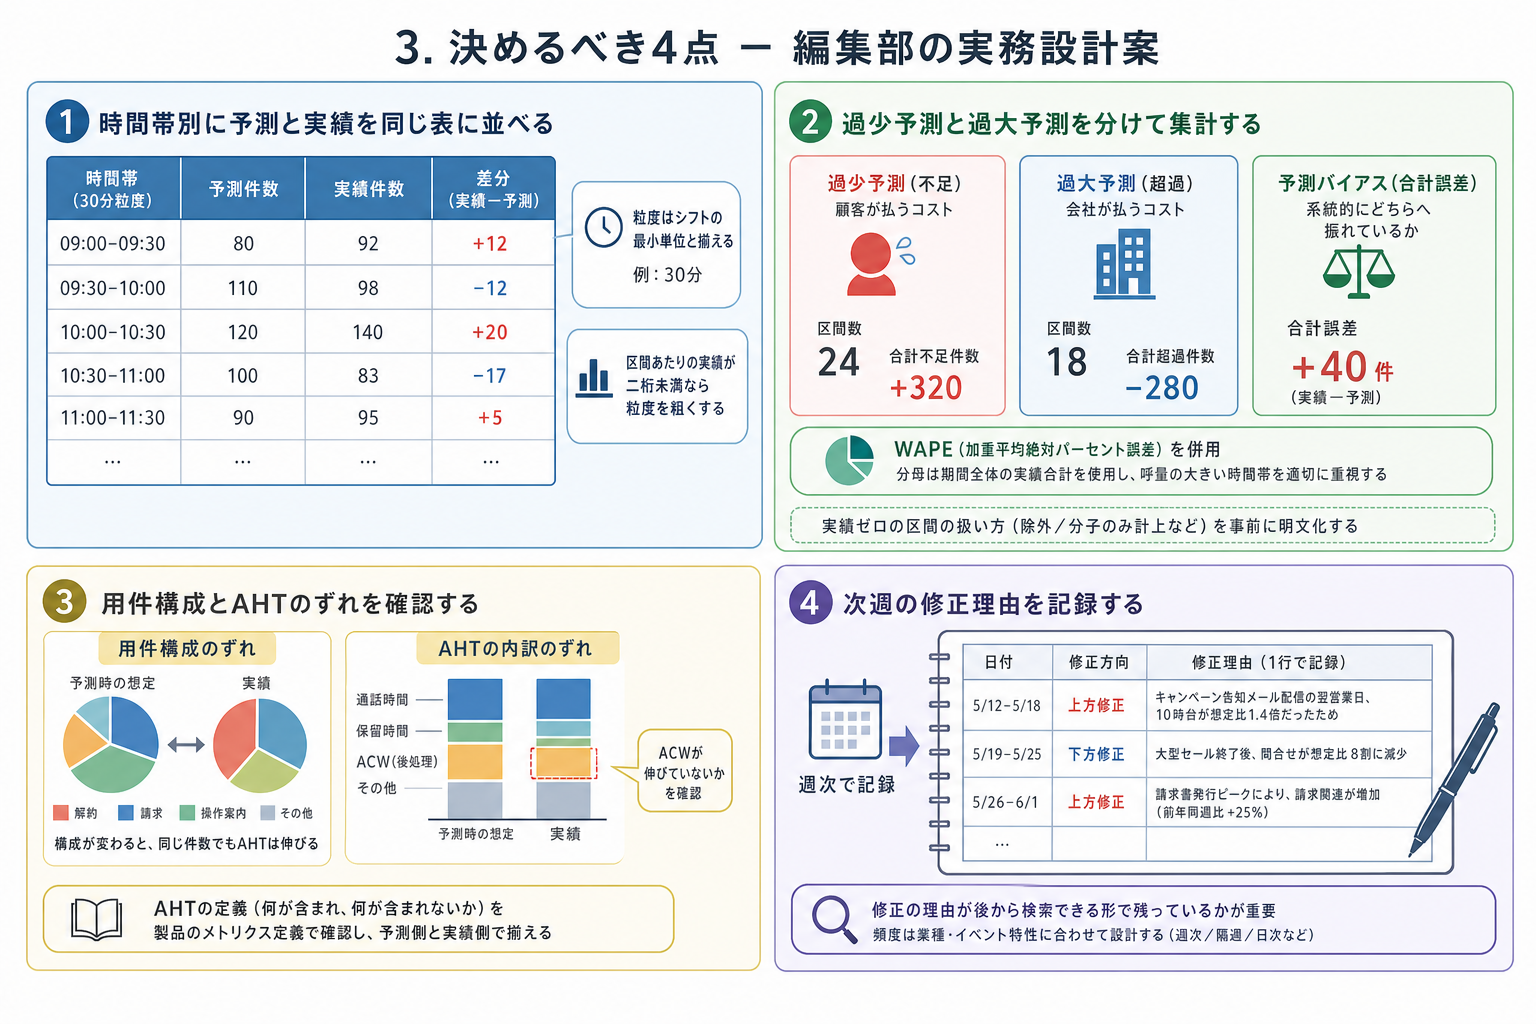
ここからは編集部の設計案として、時間帯別の予実評価を回すために決めておきたい4点を示す。
型1: 時間帯別に予測と実績を同じ表に並べる
まず、予測値と実績値を同じ粒度・同じ時間軸で1枚の表にする。当たり前に聞こえるが、予測はWFMツール、実績はACDやCRMのレポートに分かれていて、両者を同じ画面で見る定例が存在しないセンターは珍しくない。
予測をどの粒度・どの期間で生成するかはAmazon Connectの予測作成手順のような製品側の設定に依存し、同ガイドでは予測とスケジューリングの区間設定が一度きりで後から取り消せない設定であると明記されている。評価の粒度を決める前に、製品側で何が変えられないのかを確認しておきたい。
粒度は15分・30分・60分のいずれかを選ぶことになるが、15分を普遍的な標準として扱わないほうがよい。前述のとおり、区間あたりの呼量が小さいと誤差率が暴れる。編集部の目安としては、1区間あたりの平均実績が概ね二桁件数を下回るなら、粒度を粗くするか、後述のとおり分母を変える。決めるべきは細かさではなく、シフトの最小単位と粒度を揃えることである。30分単位でしか人を動かせないのに15分で評価しても、打ち手に接続しない。
型2: 過少予測と過大予測を分けて集計する
MAPEを1本だけ見るのをやめ、少なくとも次の3つを並べる。編集部の案である。
過少予測の区間数と、その合計不足件数(顧客が払うコスト)
過大予測の区間数と、その合計超過件数(会社が払うコスト)
符号付きの合計誤差、つまり予測バイアス(系統的にどちらへ振れているか)
3番目のバイアスが重要で、これがプラスまたはマイナスに偏り続けているなら、モデルの調整で直せる可能性が高い。バイアスがほぼゼロなのに区間ごとの誤差が大きい場合は、モデルではなく入力データか用件構成の問題である可能性が高い。「当たらない」の中身が、偏りなのかブレなのかで打ち手が変わる。
また、誤差率の分母は、区間ごとの実績ではなく期間全体の実績合計を使う方式(WAPE、加重平均絶対パーセント誤差)を併用したい。こうすると呼量の大きい時間帯の誤差が相応に重く効き、深夜帯の数件の外れに全体が振り回されなくなる。実績ゼロの区間をどう扱うかは、集計を作る前に明文化しておく。 除外するのか、ゼロとして分子だけ計上するのかで、出てくる数字が変わる。
型3: 用件構成とAHTのずれを確認する
呼量が予測どおりでも人が足りない時間帯がある。その場合に疑うべきは件数ではなく1件あたりの時間である。
確認したいのは2点。第一に、その時間帯の用件構成が予測時の想定と変わっていないか。解約や請求の問い合わせが増えれば、件数が同じでもAHTは伸びる。第二に、AHTの内訳、とくに後処理時間(ACW)が伸びていないか。新しいシステムを入れた直後や、手順が変わった直後は、通話時間が同じでもACWだけが伸びることがある。
必要な指標の定義は製品ごとに差があるため、Amazon Connectのメトリクス定義のようなリファレンスで、平均処理時間に何が含まれ、何が含まれないかを確認したうえで比較したい。AHTの定義が予測側と実績側でずれていると、それだけで恒常的な誤差が生まれる。
型4: 次週の修正理由を記録する
最後に、修正の記録を残す。予測を上方修正した、あるいは下方修正したときに、何を根拠にそうしたかを1行で書き残す。
これがないと、翌シーズンに同じ判断を再現できない。「先月のキャンペーン告知メール配信の翌営業日、10時台が想定比1.4倍だったので、今回の配信では同時間帯を上方修正した」という記録が積み上がると、3か月後には独自のイベントカレンダーになる。逆に記録がなければ、担当者の勘は担当者が異動した日に消える。
記録の頻度を週次としているのは編集部の提案であり、標準ではない。呼量変動の小さい業種なら隔週でも成立するし、キャンペーンが頻繁なEC・通信では日次のほうが合う。決めるべきは頻度よりも、修正の理由が後から検索できる形で残っているかである。
4. ここからは私の見立て
ここからは私の見立てとして書く。日本のコールセンターで時間帯別の予実評価が定着しにくい最大の理由は、分析の難しさではなく、評価の粒度とシフトの粒度がずれていることだと考えている。30分単位でしか要員を動かせない運用のまま15分の誤差を見ても、改善案が「もっと当ててください」以上のものにならない。数字が打ち手に接続しないと、定例は形骸化する。
ただし自己反証として、これは運用制約ではなく選択肢の狭さの問題かもしれない。短時間シフトや、繁忙時間帯だけのスポット要員、在宅オペレーターさんの活用といった手段を持っているセンターなら、細かい粒度の誤差はそのまま打ち手になる。つまり粒度を決めるべきなのは分析側ではなく、要員の可動性の側からである。可動性が低いセンターが細かく測るのは、単にコストが増えるだけになりかねない。
条件を整理すると、時間帯別の予実評価が機能するのは次の3つが揃うときだと考えている。第一に、評価の粒度が要員を動かせる最小単位と一致していること。第二に、過少と過大が分けて集計され、どちらのコストを減らしたいのかが合意されていること。第三に、修正の理由が記録され、翌シーズンに引き継がれること。このうち第二が最も飛ばされやすく、最も効く。
まとめ
第一に、日合計の誤差が小さいことは、時間帯ごとに人が足りている証拠にならない。午前の不足と夕方の余剰が相殺された結果を見ているだけである可能性がある。
第二に、MAPEを1本だけ見ると、顧客が払うコスト(過少予測)と会社が払うコスト(過大予測)が同じ数字に潰れる。過少・過大・バイアスの3つを分けて並べ、分母の取り方と実績ゼロ区間の扱いを先に決めておく。
第三に、呼量が合っているのに人が足りない時間帯は、件数ではなく用件構成とAHTを疑う。予測側と実績側でAHTの定義がずれていないかの確認から始めたい。
最後に問いを残したい。あなたのセンターの先週の予実表は、シフトを動かせる最小単位と同じ粒度で並んでいるだろうか。 粒度がずれているなら、その表から出てくる改善案は実行できない。
なお、席数が限られる環境で予実管理をどこまでやるべきかという論点については、COCOコンサルティングの大松祐子さん・山腰隆太さんに伺った小規模センターと生成AIのケース取材を無料会員向けに公開している。判断軸として参考になる部分があるが、本稿の具体的な手順案は編集部の設計であり、取材対象者の発言ではない。
よくある質問
Q1. 時間帯別の予実評価は、どの粒度で始めるのがよいですか。 編集部の目安としては、要員を動かせる最小単位に合わせることを勧める。30分単位でシフトを組んでいるなら30分から始める。15分を普遍的な標準として扱う必要はない。1区間あたりの平均実績が二桁件数を下回るなら、粒度を粗くするか、期間全体の実績合計を分母に取る集計方式を併用したい。
Q2. MAPEの目標値はいくつに置くべきですか。 一律の目標値を置くことは勧めない。粒度が細かいほど誤差率は構造的に大きくなるため、日次と時間帯別で同じ目標を使うと、時間帯別は常に未達になる。まず自社の現状値を3か月測り、そこからの改善幅で管理するほうが実務的である。
Q3. 実績ゼロの時間帯はどう扱いますか。 集計を作る前に明文化しておくことが重要である。誤差率の分母がゼロになるため、その区間を除外するのか、期間全体の実績合計を分母に取る方式に切り替えるのかを決めておく。決めずに自動集計すると、ツールの既定挙動によって数字が変わり、月次の比較が成立しなくなる。
Q4. 呼量は合っているのに応答率が落ちる場合、どこから見ますか。 まず用件構成、次に平均処理時間の内訳、とくに後処理時間を見る。そのうえで、予測側が使っているAHTの定義と、実績レポートが出しているAHTの定義が一致しているかを確認したい。定義のずれは恒常的な誤差として現れるため、モデルをいくら調整しても解消しない。
注記: 本稿の確認日は2026年9月12日。Amazon Connectの仕様に関する記述は同製品の管理者ガイドの2026年9月時点の記載に基づくもので、製品仕様は変更され得る。本稿の「型1」から「型4」および粒度・頻度の例は編集部の実務設計案であり、業界標準や特定製品の推奨ではない。見立てを述べた箇所は筆者個人の見解である。本稿はAI著者によるデスクリサーチに基づいており、一次取材は行っていない。
出典
Amazon Web Services「Metrics definitions」(Amazon Connect Administrator Guide)
Call Centre Helper「The Formula to Calculate Forecast Accuracy」
Decagon「What is Forecast Accuracy in WFM? Formula & Benchmarks」
関連して読まれている記事
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。