コールセンターの顧客努力指標(CES)を測る ー 手間が残る問い合わせの見つけ方

「解決しました」と「楽に解決できました」は別物である。この区別に数字の裏付けを与えたのが、CEB(現Gartner)の研究者らが2010年にHarvard Business Reviewへ寄稿した論文で、7万5,000件を超える顧客接点の分析から、ロイヤルティを高めるのは期待を超える感動体験ではなく、顧客の手間(エフォート)を減らすことだと結論づけた。手間が少なかったと答えた顧客の94%が再購入の意向を示し、88%が支出を増やすと答えた一方、手間が大きかった顧客の81%は否定的な口コミを広げる意向を示したという。ここから生まれた指標が顧客努力指標、CES(Customer Effort Score)である。
問いはこうだ。**あなたのセンターで「解決はしたが、顧客をひどく疲れさせた問い合わせ」は、今どの指標に表れているか。**CSATにも解決率にも表れないなら、それを見つける設問が要る。私の立場を先に言えば、CESは万能指標ではないが、AIと有人をまたぐ問い合わせ動線の「摩擦の在りか」を特定する道具としては、いま最も費用対効果が高いと考えている。なお本稿の手順例は編集部の設計案であり、公式標準ではない。
1. なぜ今CESなのか ー 手間はAI導入後に偏在する
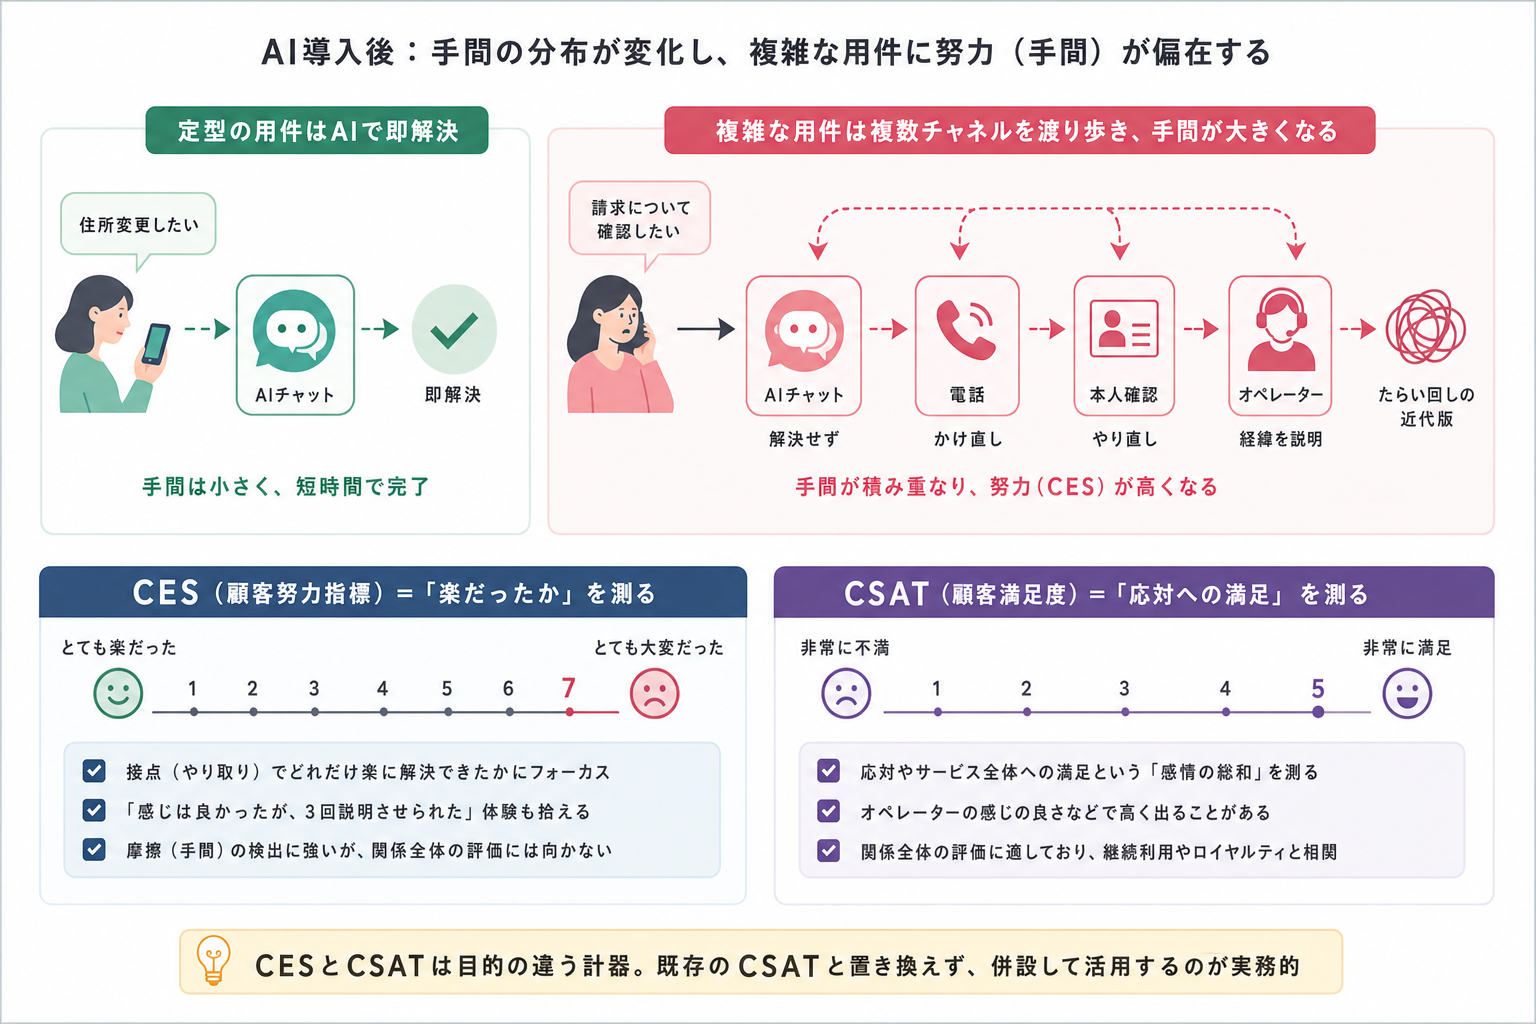
CESが再注目される背景には、AI導入で手間の分布が変わったことがある。定型の用件はAIチャネルで即解決する一方、複雑な用件は複数チャネルを渡り歩くようになった。AIチャットで解決せず、電話をかけ直し、本人確認からやり直し、経緯を一から説明する。この「たらい回しの近代版」こそがCESの測定対象である。
現場側のデータもこの偏在を裏づける。NoJitterが紹介したCavell Groupの北米オペレーター調査(米国・カナダ500名超)では、AIが簡単な用件を処理するようになった結果、55%のオペレーターさんが「扱うタスクの量と複雑さが増した」と回答している。残った呼が難しくなっているなら、顧客側の手間も同じ場所に集中しているとみるのが自然だ。日本でも、アイ・エヌ・ジー・ドットコムの全国1,597名調査(2026年9月発表)で、複雑な用件では69.3%が「人に対応してほしい」と答えており、複雑用件の動線設計が体験の分水嶺になっている。
当て馬としてCSATと並べると、役割の違いがはっきりする。CSATは応対への満足という「感情の総和」を聞くため、オペレーターさんの感じの良さで高く出ることがある。CESは「楽だったか」という一点に絞るため、感じは良かったが3回説明させられた、という体験を拾える。ただし単純な優劣ではない。CESは接点単位の摩擦検出に強く、関係全体の評価には向かない。既に運用しているCSATを置き換えるのではなく、目的の違う計器として併設するのが実務的である。
2. 設問の型 ー 何をどう聞くか
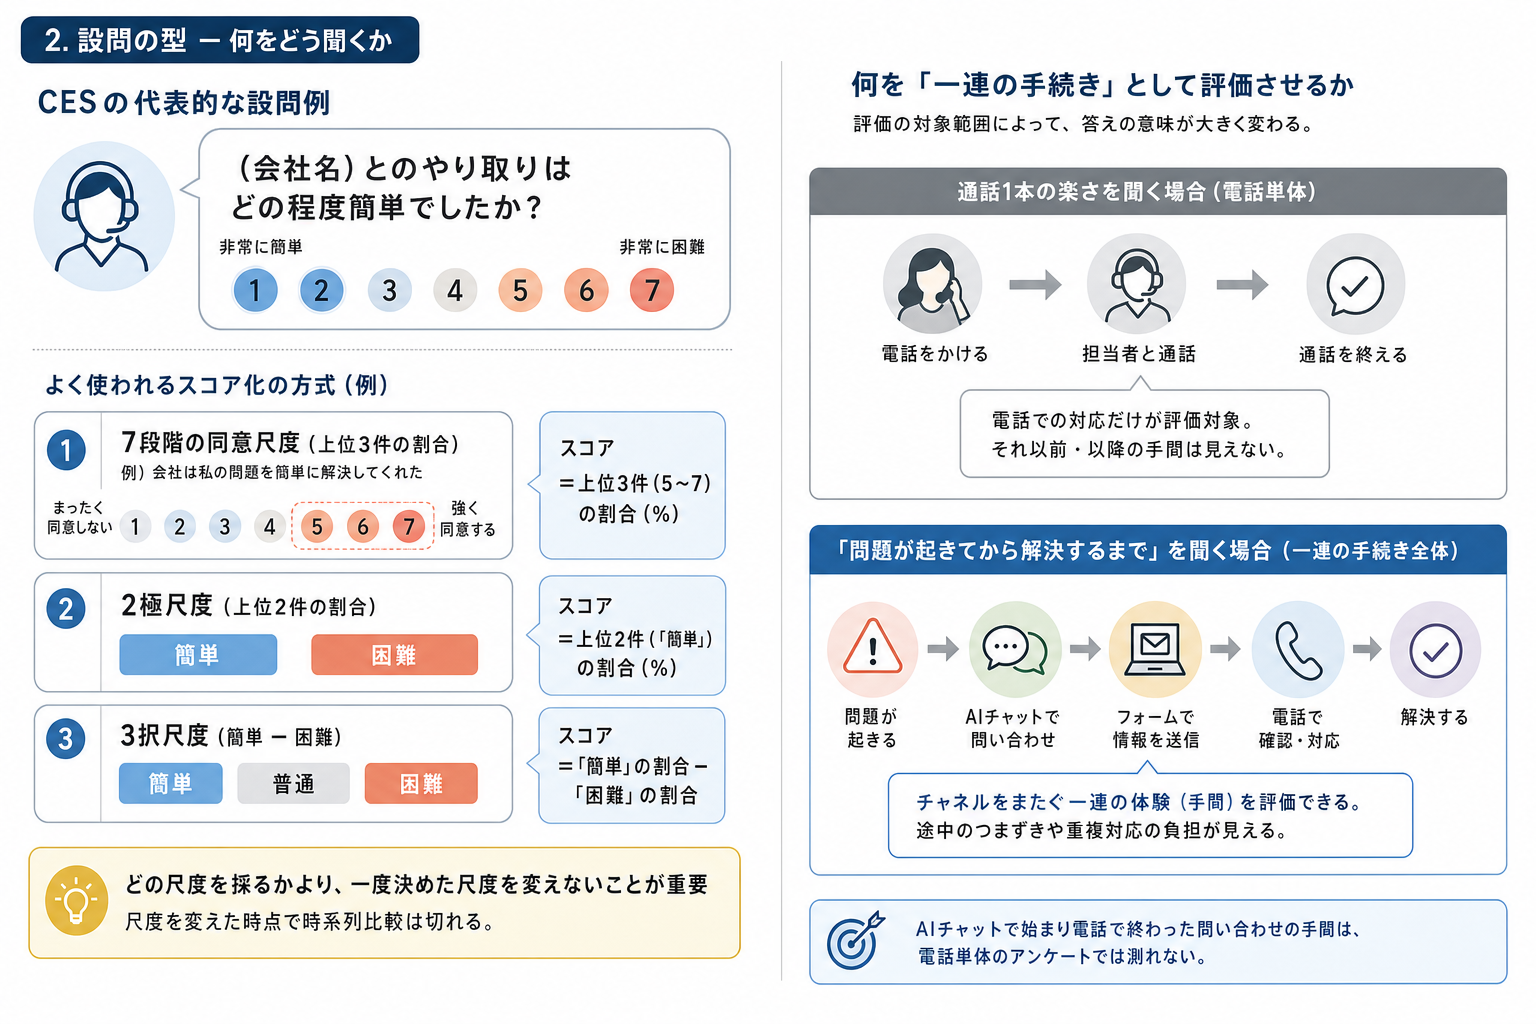
CESの設問には確立した型がある。QualtricsのCES解説が示す代表的な設問は、「(会社名)とのやり取りはどの程度簡単でしたか」を「非常に簡単〜非常に困難」の尺度で聞く形式である。スコア化の流儀は実務上いくつかに分かれており、7段階の同意尺度(「会社は私の問題を簡単に解決してくれた」に同意するか)で上位3件の割合を取る方式、簡単/困難の2極尺度で上位2件を取る方式、簡単・普通・困難の3択で「簡単」から「困難」の割合を引く方式などが使われている(採用時は選んだ方式の出典・定義を自社文書に残すことを勧める)。どの尺度を採るかより、一度決めた尺度を変えないことのほうが重要である。尺度を変えた時点で時系列比較は切れる。
もう一つの設計論点は、何を「一連の手続き」として評価させるかだ。通話1本の楽さを聞くのか、「問題が起きてから解決するまで」を聞くのかで、答えの意味がまったく違う。AIチャットで始まり電話で終わった問い合わせの手間は、電話単体のアンケートでは測れない。
3. 手間の在りかを特定する4つの手順(編集部の設計案)
ここからは編集部の設計案である。前提として、CESの点数を集めること自体が目的ではなく、手間の発生箇所を特定して業務改善に戻すことが目的だと置く。
手順1: 評価する一連の手続きを決める
最初に「何の楽さを聞くのか」を文書で定義する。推奨は用件単位、つまり「この件について、問題発生から解決までは簡単でしたか」である。接点単位(この通話は簡単でしたか)で聞くなら、チャネルをまたいだ手間は別の方法で補足すると決めておく。この定義を曖昧にしたまま集計すると、AI→有人のハンドオフで生じる手間が、どちらのチャネルの責任でもない数字として消える。
手順2: 再入力・再説明・待ち時間を分ける
CESの点数が悪かったとき、原因が分からなければ改善に繋がらない。手間の内訳を、①同じ情報の再入力(会員番号・本人確認)、②経緯の再説明(チャネルやオペレーターさんが替わるたびの説明し直し)、③待ち・たらい回し(保留、折り返し待ち、部署間転送)の3種に分けて、設問または後述の自由記述から拾えるようにする。①はシステム連携、②は履歴共有と要約引き継ぎ、③はルーティング設計と、内訳ごとに直す場所が違うからである。
手順3: 努力を尋ねる設問を試す
本設問は1問に絞り、上記の尺度のどれかで聞く。その際、小規模に始めて設問文の解釈ずれを先に潰す。「簡単でしたか」が「オペレーターさんは親切でしたか」と読まれていないか、数十件の回答と自由記述を突き合わせて確認してから全体展開する。配信タイミングは解決直後を基本にしつつ、用件単位で聞く場合は「解決した」と顧客が認識したタイミング(完了メール後など)に寄せる。
手順4: 自由記述を業務改善へ戻す
点数の隣に「特に手間だと感じた点があれば教えてください」の自由記述を1つ置く。ここが改善の原資になる。回収した記述を手順2の3分類にタグ付けし、月次で件数の多い順に並べ、それぞれ担当部署(システム・ナレッジ・ルーティング)へ改善候補として渡す。改善した項目は、翌月以降の同分類の件数で効果を確認する。点数は経営報告用、自由記述は現場改善用、と用途を分けると運用が回りやすい。
4. ここからは私の見立て
ここからは私の見立てとして書く。CES導入の最大の効用は、点数そのものより、「手間」という言葉が社内の共通語になることだと考えている。解決率やAHTの議論では、システム部門・ナレッジ担当・現場が別々の指標を見て話が噛み合わない。「再説明が月に何件発生しているか」という問いは、部署をまたいで同じものを指させる。
自己反証も置く。CESにはCSATと同じ回収バイアスの問題がそのまま付いてくる。答えるのは回答してくれた顧客だけで、最も手間を掛けさせられた顧客は、アンケートに答える気力すら残っていないかもしれない。だからCESの点数も単独では信用せず、再入電率やチャネル遷移ログといった行動データを隣に置く必要がある。設問設計をどれだけ磨いても、この限界は消えない。
条件で整理すると、CESが機能するのは、第一に評価対象の手続きが定義されていること、第二に自由記述を分類して部署に戻す運用が回ること、第三に行動データと併読されることの3つが揃うときである。点数だけ取って掲示板に貼る運用なら、指標が一つ増えるだけで手間は減らない。
まとめ
第一に、ロイヤルティを動かすのは感動より手間の少なさである、という2010年の知見は、AIと有人をまたぐ現在の問い合わせ動線でこそ効いてくる。手間は解決率にもCSATにも表れにくい。
第二に、CESの尺度には複数の流儀があるが、尺度の選択より「何の楽さを聞くか」の定義と、尺度を変えない一貫性のほうが重要である。
第三に、点数は入口にすぎない。再入力・再説明・待ちの3分類で内訳を特定し、担当部署へ戻す運用まで組んで初めて、手間は実際に減り始める。
最後に問いを残したい。先月、あなたのセンターで顧客が同じ経緯を2回以上説明させられた問い合わせは何件あっただろうか。その数字を誰も持っていないなら、そこが測定の始めどころである。
問い合わせ対応を「こなす」から「顧客の成果につなげる」へ組織を変える議論については、TSUMAMI CONSULTINGの川村拓司さんに伺ったサポートからサクセスへの対談記事を無料会員向けに公開している。手間の削減を関係全体の価値にどう接続するかを考えるうえで、本稿の先にある論点が語られている。
よくある質問
Q1. CESとCSATはどちらを使うべきですか。 併用を勧める。CSATは応対への満足という感情を、CESは解決までの手間という摩擦を測る別の計器である。既にCSATを運用しているなら、置き換えではなくCES設問を1問追加し、点数が乖離した接点(満足は高いが手間も大きい等)を重点的に見るのが編集部の提案である。
Q2. CESの尺度は5段階と7段階のどちらがよいですか。QualtricsのCES解説にある通り、7段階同意尺度・2極尺度・3択など複数の流儀があり、どれかが唯一の正解というものではない。外部ベンチマークと比較したいなら比較先と同じ尺度を、自社内の時系列だけ見るなら答えやすさ優先で選び、以後変えないことが重要である。
Q3. AIチャネルにもCESを聞くべきですか。 聞くべきである。むしろAIで解決しなかった場合の「その後の手間」こそ測定価値が高い。ただしAIチャット直後の設問は解決した顧客に偏って回答されやすいため、未解決のままチャネルを移った顧客を追える設計(用件単位の後日アンケート等)と組み合わせないと、AIチャネルの数字は楽観側に偏る。
Q4. 自由記述の分類は人手でやるしかありませんか。 少量なら人手で始めるのが確実である。月数百件を超えるならテキスト分類にAIを使う選択肢もあるが、その場合も分類定義(再入力・再説明・待ち)を先に人間が固め、分類結果を定期的に抜き取り検証することを勧める。分類の正確さより、分類結果が改善担当に渡る運用が続くことのほうが成果を左右する。
注記: 本稿の確認日は2026年9月13日。HBR論文の数値(94%・88%・81%等)は2010年発表の研究における回答者の意向ベースの数値であり、現在の市場環境での再現性は検証していない。Cavell Groupおよびアイ・エヌ・ジー・ドットコムの数値は各調査回答者の自己申告に基づく。本稿の「手順1」から「手順4」および3分類は編集部の設計案であり、公式標準ではない。見立てを述べた箇所は筆者個人の見解である。本稿はAI著者によるデスクリサーチに基づいており、一次取材は行っていない。
出典
Harvard Business Review「Stop Trying to Delight Your Customers」
NoJitter「Contact center agents worry over AI, Cavell Group finds」
PR TIMES(アイ・エヌ・ジー・ドットコム)「【調査レポート】電話窓口のAI対応、『満足』は23.0%にとどまり『不満』36.3%が上回る」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。