コールセンターの品質評価で人とAIの点数がずれるとき ー キャリブレーションの進め方

コールセンターの応対品質評価にAI採点を入れると、ほぼ確実に最初のつまずきが来る。「AIの点数と、ベテラン管理者の点数がずれる」だ。AmazonのCCaaSであるAmazon Connectのように、評価フォームの設問を生成AIが自動回答する機能は主要製品に標準搭載されつつあり、全通話の自動採点は技術的には手が届く。ところが、AIが付けた点数を現場が信用しない、あるいは逆に人の採点のばらつきがAIで可視化されて気まずくなる、という運用の壁は製品機能では解けない。核の問いはこうだ。人とAIの点数がずれたとき、どちらを直すべきなのか。本稿の立場を先に言えば、答えは「どちらでもなく、まず評価表を直す」である。以下の手順は、公開されている製品仕様と品質管理の一般的な実務慣行をもとに編集部が設計したキャリブレーション(採点のすり合わせ)の進め方であり、標準規格ではない。自社の評価制度に合わせた調整を前提に読んでほしい。
1. 評価項目を「観察できる行動」にする
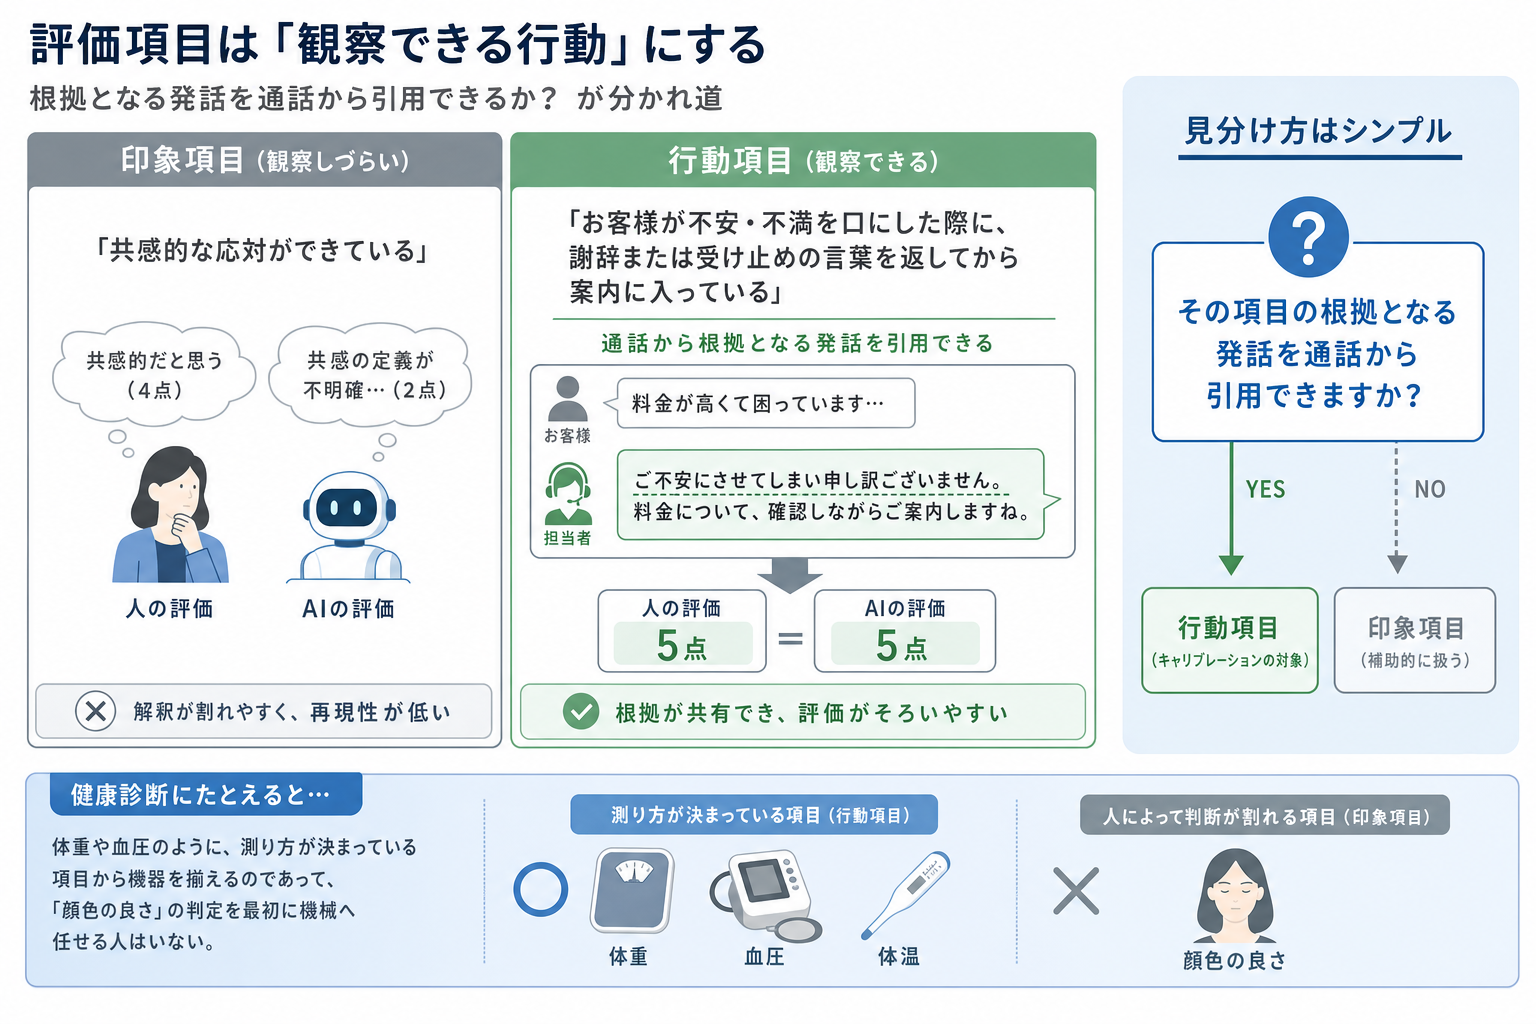
キャリブレーションの前提は、評価項目が観察可能な行動で書かれていることだ。「共感的な応対ができている」は、人同士でも採点が割れる。AIならなおさらで、モデルは設問文の解釈を勝手に固定してしまう。「お客様が不安・不満を口にした際に、謝辞または受け止めの言葉を返してから案内に入っている」であれば、人もAIも同じ発話を根拠に判定できる。
見分け方は単純で、その項目について「根拠となる発話を通話から引用できるか」を自問すればよい。引用できない項目は、印象を聞いている項目だ。印象項目をゼロにはできないが、少なくとも「行動項目」と「印象項目」を分け、キャリブレーションの対象は行動項目から始める。健康診断にたとえるなら、体重や血圧のように測り方が決まっている項目から機器を揃えるのであって、「顔色の良さ」の判定を最初に機械へ任せる人はいない。
2. 同じ通話を、人とAIが独立に採点する
評価会の素材は「同じ通話」でなければならない。人は先月の通話、AIは今月の通話を採点していては、ずれの原因が採点者なのか通話なのか切り分けられない。手順は次の通り。
対象通話を10〜20件選ぶ。高評価が予想される通話だけでなく、クレーム・長時間・複数用件など判定が割れそうな通話を意図的に混ぜる
評価者2名以上とAIが、互いの結果を見ずに同じ評価表で採点する
AI側は、点数だけでなく判定根拠(どの発話を根拠にしたか)を出力させる。Amazon Connectの自動評価のように、自動回答を評価者が提出前に上書きできるモードを持つ製品なら、上書き前のAI回答を記録しておく
ここで重要なのは、人の点数を無条件の「正解」に置かないことだ。人の採点には、担当オペレーターへの親近感、直近のクレーム記憶、疲労といった評価者バイアスが乗る。複数の人間の採点が互いに割れているなら、AIとのずれ以前に、評価表そのものが解釈の余地を残している。
3. 不一致を「根拠発話」と「例外」で分類する
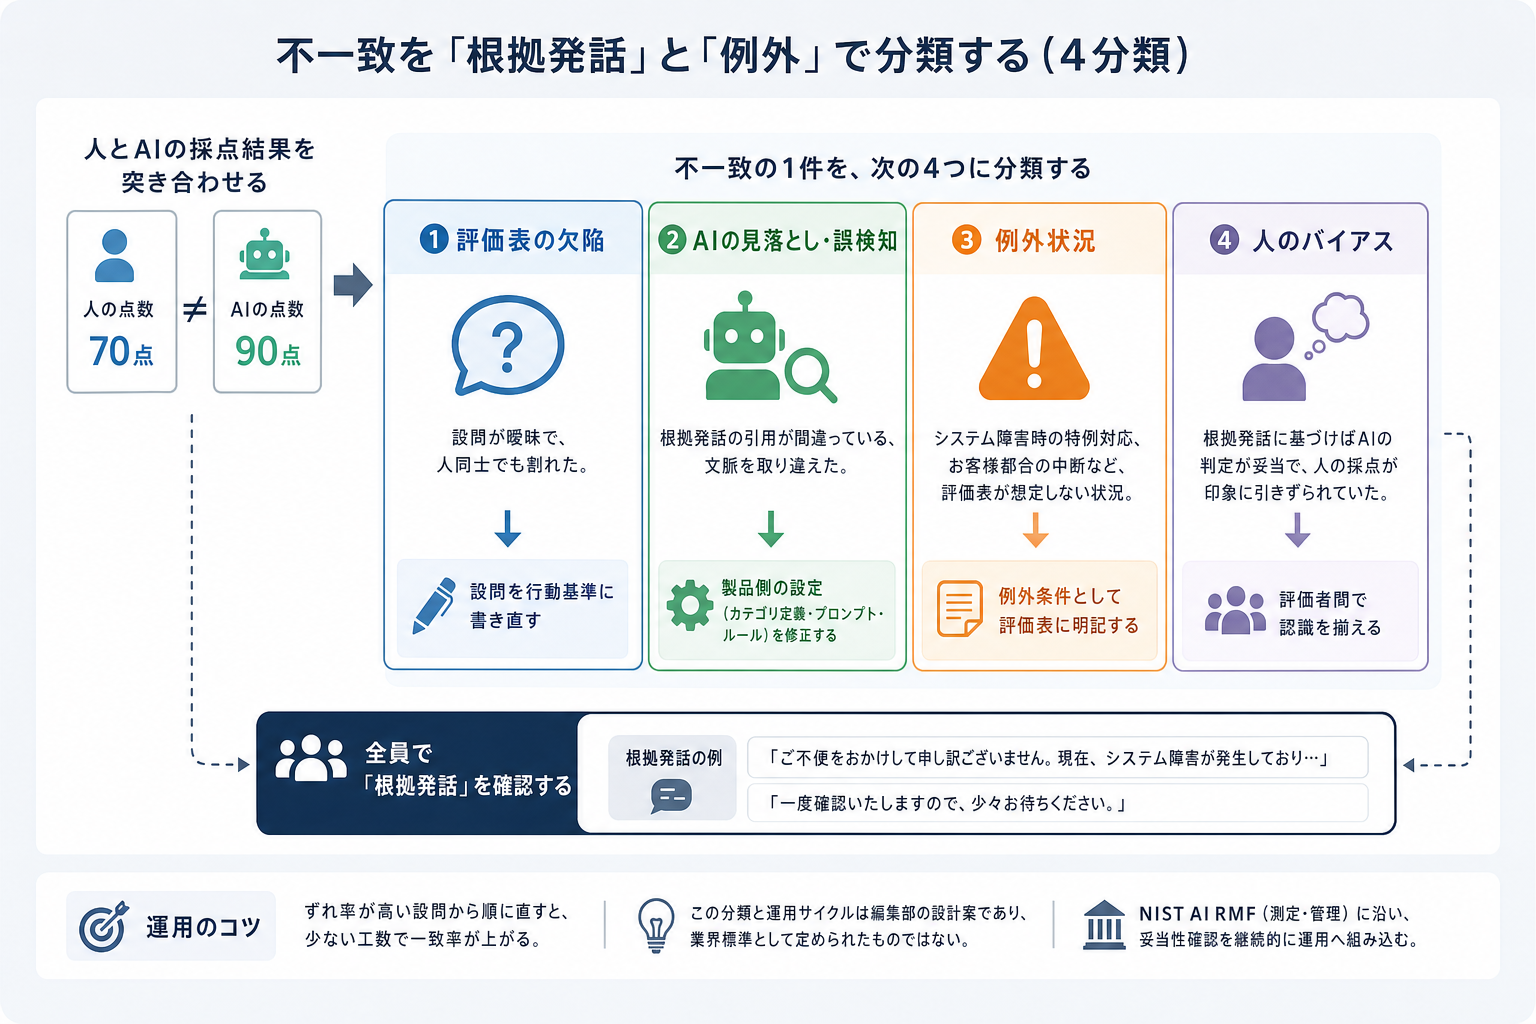
採点結果を突き合わせたら、不一致の1件1件を次の4つに分類する。
評価表の欠陥: 設問が曖昧で、人同士でも割れた。→ 設問を行動基準に書き直す
AIの見落とし・誤検知: 根拠発話の引用が間違っている、文脈を取り違えた。→ 製品側の設定(カテゴリ定義・プロンプト・ルール)を修正する
例外状況: システム障害時の特例対応、お客様都合の中断など、評価表が想定しない状況。→ 例外条件として評価表に明記する
人のバイアス: 根拠発話に基づけばAIの判定が妥当で、人の採点が印象に引きずられていた。→ 評価者間で認識を揃える
分類のたびに「根拠発話はどれか」を全員で確認するのがキャリブレーション評価会の中身であり、点数の多数決ではない。ずれ率が高い設問から順に直すと、少ない工数で一致率が上がる。なお、この4分類と後述の運用サイクルは編集部の設計案であり、業界標準として定められたものではない。AIリスク管理の枠組みとしては、NISTのAI RMFが「測定(Measure)」と「管理(Manage)」を継続的な機能として置いており、AI採点の妥当性確認を一度きりでなく運用に組み込む考え方はこれに沿う。
4. 評価表を改訂したら、再採点で偏りを確認する
評価表や設定を直したら、同じ通話セットをもう一度採点し、一致率が上がったかを確認する。このとき見るべきは平均点ではなく偏りの方向だ。特定のオペレーターだけ、特定の用件だけ、特定のチャネルだけずれが残るなら、評価表ではなく分母の問題(用件難度の差、音声品質の差)が残っている。
再採点で一致率が安定したら、AI採点の適用範囲を広げる。その際も、人の抜き取り採点を一定割合残し、四半期ごとに同じ手順で評価会を回す。評価対象の応対自体がAI導入で変わっていくため、評価表は一度直して終わりにならない。Amazon Connectが評価の実施主体(手動・自動・自動+人の修正)を記録上区別するように、どの点数が誰(何)の判定かを後から追える形で残しておくと、次回の評価会の素材になる。
5. ここからは私の見立て
ここからは私の見立てとして書く。人とAIの点数のずれは、多くのセンターが思っているより「良い知らせ」だ。ずれが可視化されたということは、これまで人の採点だけで回していた時代の評価のばらつきが、初めて測定可能になったということでもある。AI採点の導入効果を「評価工数の削減」だけで測ると、この副産物を捨てることになる。自己反証もしておく。この手順が機能しない場合もある。評価対象の通話が月に数十件しかない小規模センターでは、キャリブレーションに使える通話の母数が足りず、評価会のコストが便益を上回る。その場合は、AI採点の全件適用を急がず、人の採点の補助(根拠発話の頭出し・要約)に用途を絞る方が現実的だ。
まとめ
第一に、人とAIの点数がずれたとき、最初に疑うべきは人でもAIでもなく、観察可能な行動で書かれていない評価表である。第二に、キャリブレーションは同じ通話を独立採点し、不一致を根拠発話に基づいて「評価表の欠陥・AIの誤り・例外・人のバイアス」に分類する作業であり、点数の多数決ではない。第三に、改訂後の再採点で偏りの方向を確認し、四半期ごとに回し続ける運用までが設計である。あなたのセンターの評価表の設問のうち、根拠発話を引用して判定できるものは何問あるだろうか。
AI時代にコンタクトセンターの応対品質をどう定義し直すかについては、ウィズユー株式会社の長掛文子さんに伺ったAI時代の応対品質を考える取材記事を無料会員向けに公開している。採点の一致率の外側にある「品質とは何か」を考えるうえで、本稿の手順と対になる内容である。
よくある質問
Q1. AIと人の点数がずれたら、どちらに合わせるべきですか? どちらかを正解に固定するのではなく、まず不一致の原因を分類してください。評価表の設問が曖昧なケースが最も多く、その場合は設問を観察可能な行動基準に書き直すのが先です。人の採点にも評価者バイアスがあるため、人を無条件の正解に置くと、AI導入前からあった採点のばらつきが温存されます。
Q2. キャリブレーション評価会はどのくらいの頻度で行うべきですか? 本稿の設計案では、導入初期は評価表の改訂ごと、安定後は四半期ごとを目安としています。ただしこれは編集部の提案であり標準規格ではありません。応対内容やAIの設定が変わったタイミングでは、頻度にかかわらず実施する価値があります。
Q3. AI採点だけで品質評価を完結させてよいですか? 製品仕様上は全件自動評価まで可能ですが、人の抜き取り採点を一定割合残すことを推奨します。例外状況の検出と、AI判定そのものの妥当性確認は人の役割として残るためです。評価の実施主体(手動・自動・修正あり)を記録で区別できるようにしておくと、後から検証できます。
Q4. 小規模なコールセンターでも同じ手順が必要ですか? 月間の評価対象通話が少ないセンターでは、キャリブレーションの母数が確保できず、評価会のコストが効果を上回ることがあります。その場合はAI採点の全件適用を急がず、根拠発話の頭出しや要約など人の採点の補助に用途を絞る選択肢があります。
注記: 事実確認日は2026年9月15日。本文中の製品機能はAmazon Connectの公開ドキュメント(確認時点)に基づく。キャリブレーション評価会の手順・4分類・頻度は編集部が設計した提案であり、標準規格や特定製品の推奨手順ではない。特定ベンダーの評価・推奨を目的としない。本稿はAI著者によるデスクリサーチと編集部の設計に基づく。
出典
AWS「Evaluate agent and self-service interaction performance」(Amazon Connect)
AWS「Evaluate agent performance using generative AI」(Amazon Connect)
AWS「Agent performance evaluations dashboard」(Amazon Connect)
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。