JR西日本カスタマーリレーションズはなぜ通話要約で止まらなかったのか ー コールセンターの月7万件の声を全件タグ付けへ進めた2段階の順序

JR西日本カスタマーリレーションズの2024年12月の発表によると、同社のコンタクトセンターでは生成AIによるVoC(顧客の声)分析パッケージの実運用により、週報の作成時間が約2時間から30分になった(同社発表・2024年12月時点)。多くのコールセンターが「通話要約AIを入れて後処理を減らす」ところで一段落する中で、なぜこの会社は要約で止まらず、月7万件規模の声の全件分析まで進めたのか。本稿ではその順序を公表事実の時系列から分解する。先に断っておくと、本稿で扱う数字はすべて同社・ベンダー発表または業界誌報道の公表値であり、通年の全社実績として検証された数値は含まれない。言えるのは「どの順番で何を積んだか」という構造であり、「どれだけ儲かったか」ではない。
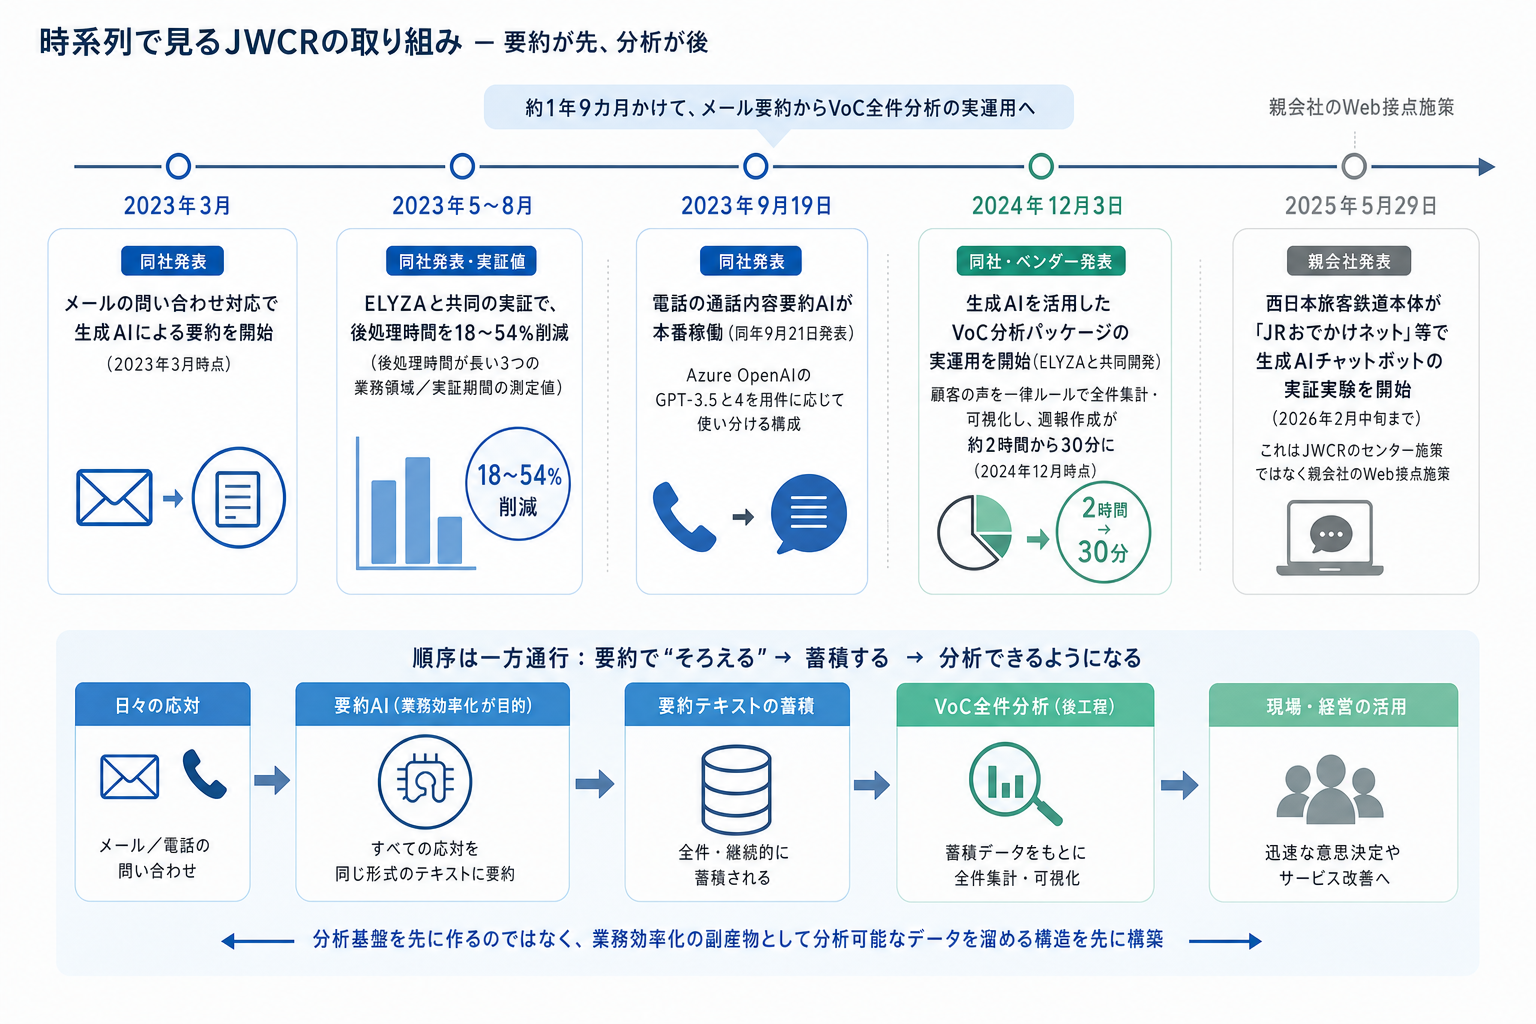
1. 公表事実の時系列 ー 要約が先、分析が後
主体は株式会社JR西日本カスタマーリレーションズ(JWCR)。西日本旅客鉄道グループのコンタクトセンター運営会社であり、親会社である西日本旅客鉄道本体の施策とは区別して読む必要がある。
[2023年3月][同社発表]メールの問い合わせ対応で生成AIによる要約を開始(2023年3月時点)
[2023年5〜8月][同社発表・実証値]ELYZAと共同の実証で、後処理時間が長い3つの業務領域において後処理時間を18〜54%削減(実証期間の測定値)
[2023年9月19日][同社発表]電話の通話内容要約AIが本番稼働(同年9月21日発表)。Azure OpenAIのGPT-3.5と4を用件に応じて使い分ける構成
[2024年12月3日][同社・ベンダー発表]生成AIを活用したVoC分析パッケージの実運用を開始(ELYZAと共同開発)。顧客の声を一律ルールで全件集計・可視化し、週報作成が約2時間から30分に(2024年12月時点)
[2025年5月29日][親会社発表]西日本旅客鉄道本体が「JRおでかけネット」等で生成AIチャットボットの実証実験を開始(2026年2月中旬まで)。これはJWCRのセンター施策ではなく親会社のWeb接点施策である
この年表で見るべきは、メール要約(2023年3月)からVoC全件分析の実運用(2024年12月)まで約1年9カ月かけている点、そして順序が一方通行である点だ。後処理削減のために導入した要約AIが、結果としてすべての応対を同じ形式のテキストに変換し続ける装置になり、その蓄積が次のVoC分析の原資になっている。分析基盤を先に作ったのではなく、日々の業務効率化の副産物として分析可能なデータが溜まる構造を先に作った、という順序である。
2. 数字の読み方 ー 「最大54%」と「月7万件」の分母
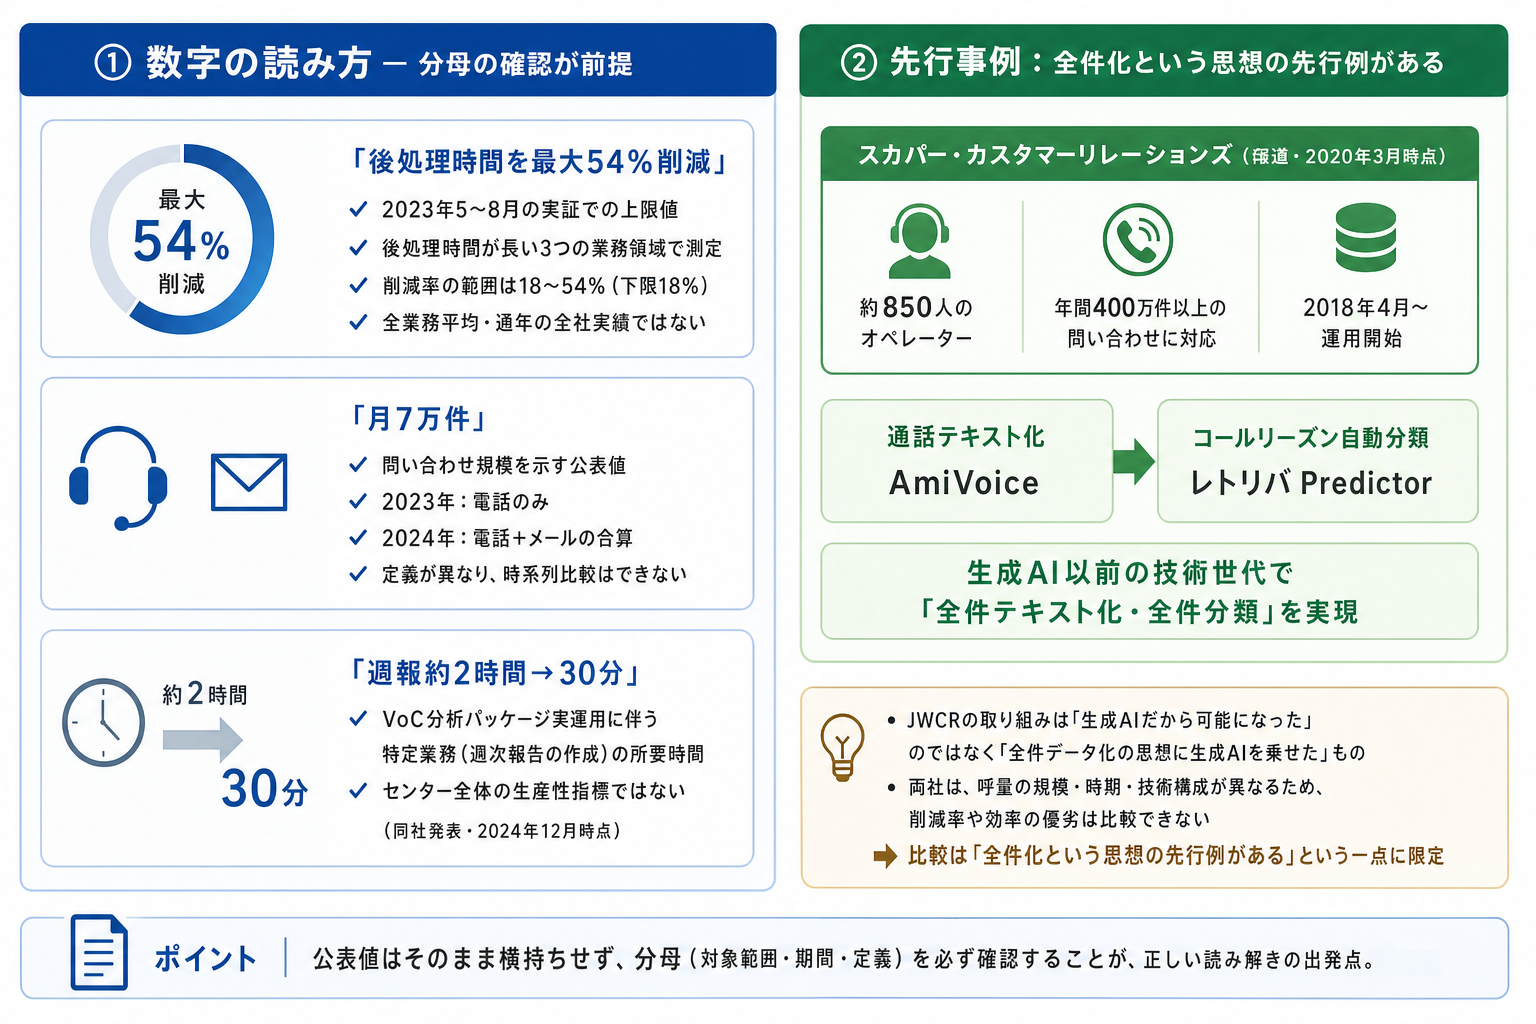
公表値はそのまま横持ちすると誤読する。ひとつずつ分母を確認する。
「後処理時間を最大54%削減」。業界誌IT Leadersの報道でも見出しに使われた数字だが、これは2023年5〜8月の実証において、後処理時間が長い3つの業務領域で測った削減率18〜54%の上限値である。全業務の平均でも、通年の全社実績でもない。範囲の下限は18%であり、「半分になる」と読むのは誤りだ。
「月7万件」。同社センターへの問い合わせ規模を示す公表値だが、2023年の発表時点では電話のみ、2024年の発表では電話とメールの合算と、発表によって定義が異なる。件数の推移として時系列比較できる数字ではない。
「週報約2時間→30分」。VoC分析パッケージ実運用に伴う特定業務(週次報告の作成)の所要時間であり、センター全体の生産性指標ではない(同社発表・2024年12月時点)。
当て馬として、同じ「声の全件処理」の先行事例を置く。日経クロステックの2020年3月の報道によると、スカパー・カスタマーリレーションズは約850人のオペレーターで年間400万件以上の問い合わせに対応し、2018年4月からAmiVoiceによる通話テキスト化とレトリバの機械学習エンジンPredictorによるコールリーズン自動分類を運用している(業界誌報道・2020年3月時点)。生成AI以前の技術世代で「全件テキスト化・全件分類」を成立させていた例であり、JWCRの取り組みが「生成AIだから可能になった」のではなく「全件データ化の思想に生成AIを乗せた」ものだと分かる。もっとも、両社は呼量の規模も時期も技術構成も異なるため、削減率や効率の優劣を比べることはできない。ここでの比較は「全件化という思想の先行例がある」という一点に限る。
3. なぜこの会社はできたのか ー 条件分解
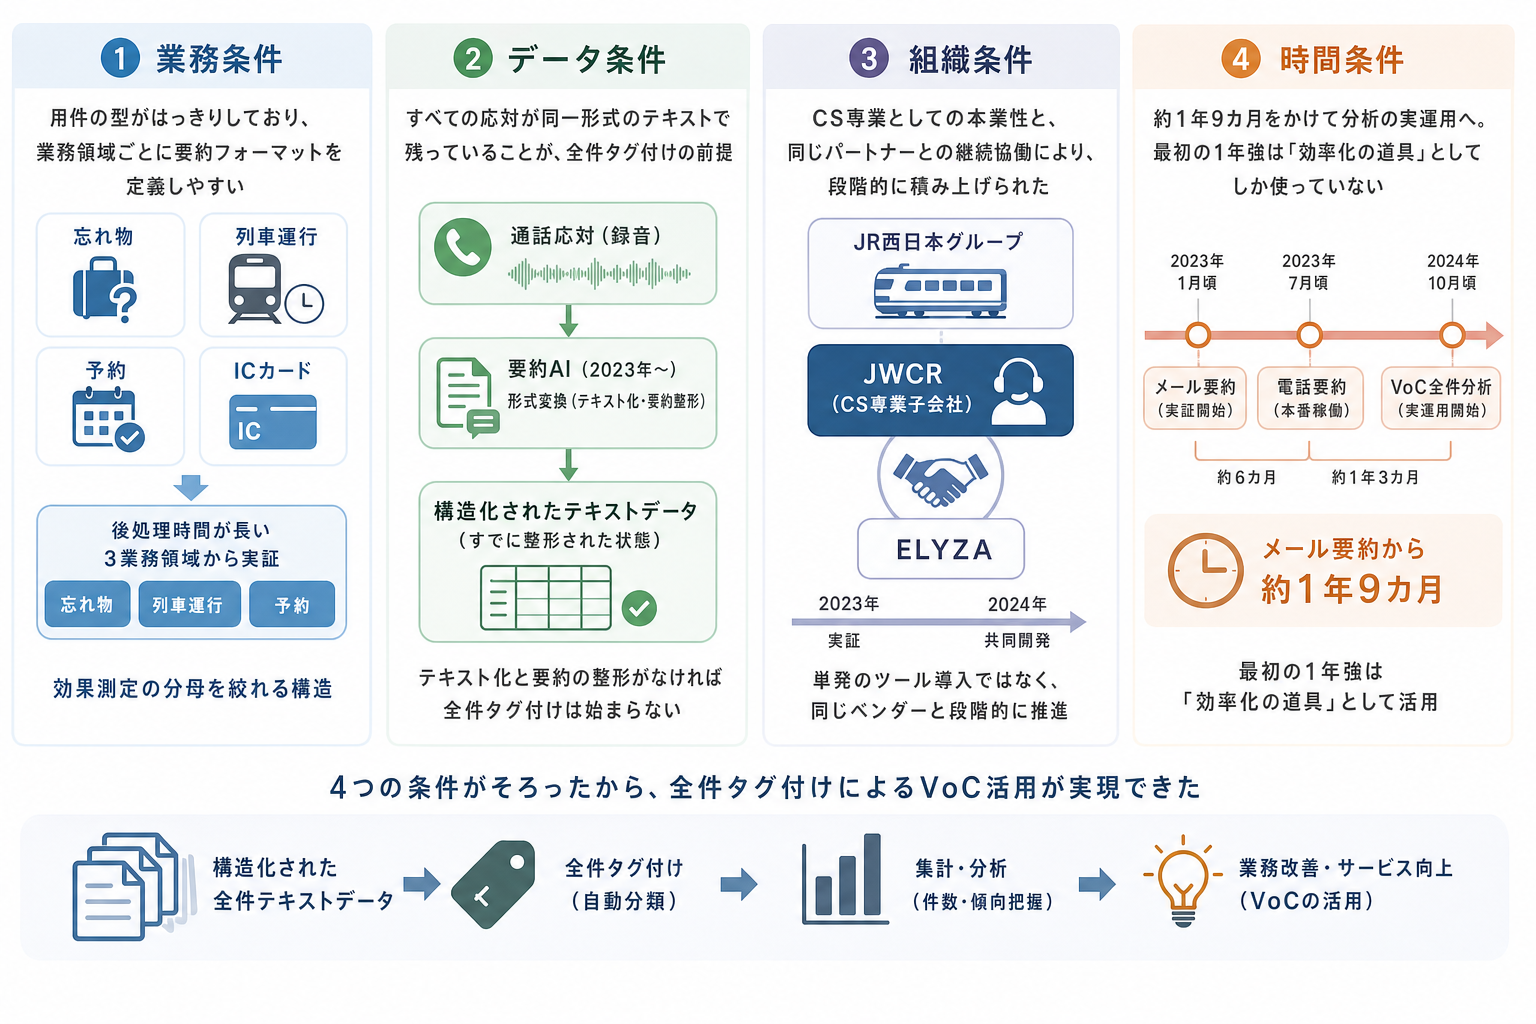
①業務条件。鉄道の問い合わせは、忘れ物・列車運行・予約・IC カードなど用件の型がはっきりしており、要約のフォーマットを業務領域ごとに定義しやすい。実証が「後処理時間が長い3業務領域」から始まっているのは、効果測定の分母を絞れる業務構造だったことの表れでもある。
②データ条件。VoC全件分析の前提は、すべての応対が同一形式のテキストとして残っていることだ。JWCRの場合、2023年に稼働した要約AIが日々この形式変換を行っており、2024年の分析パッケージは「すでに構造化されつつあるデータ」の上に載った。通話録音が残っていても、テキスト化と要約の整形がなければ全件タグ付けは始まらない。
③組織条件。JWCRはグループのCS専業子会社であり、センター運営そのものが本業である。加えてELYZAとの協働が2023年の実証から2024年の共同開発まで継続しており、単発のツール導入ではなく、同じベンダーと段階的に積み上げる体制だった。
④時間条件。メール要約から数えて約1年9カ月、電話要約の本番稼働からでも約1年3カ月をかけて分析の実運用に到達している。逆に言えば、最初の1年強は「効率化の道具」としてしか使っていない。
4. 真似できる条件、できない条件
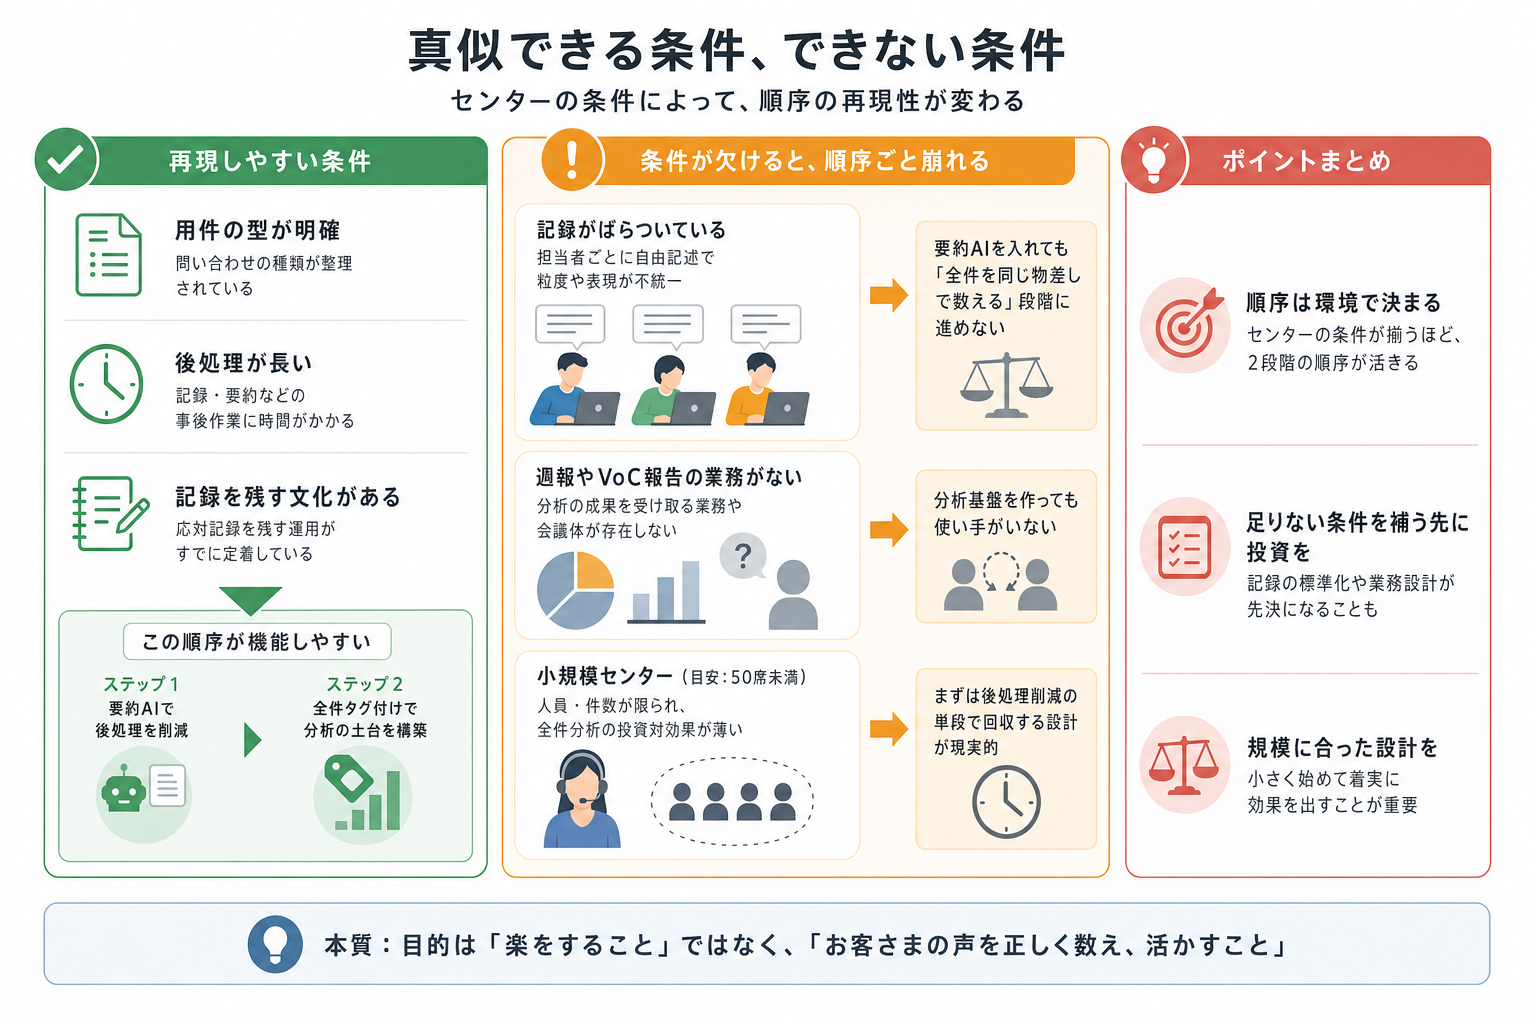
この順序が再現しやすいのは、用件の型が明確で、後処理が長く、応対記録を残す文化がすでにあるセンターだ。要約AIの導入自体は現在では珍しくなく、入口のハードルは2023年当時より下がっている。
一方で、条件が欠けると順序ごと崩れる。応対記録が担当者ごとの自由記述でばらついているセンターでは、要約AIを入れても「全件を同じ物差しで数える」段階に進めない。また、週報や VoC 報告の業務が組織に存在しないセンターでは、分析基盤を作っても使い手がいない。50席未満の小規模センターであれば、全件分析の投資対効果よりも、まず後処理削減の単段で回収する設計が現実的だろう。
5. 未公表の論点
当事者にしか答えられない問いを3つ挙げておく。第一に、要約AIの出力品質をどう監査しているか。要約の誤りは分析段階では検出しにくく、全件集計の信頼性に直結する。第二に、VoC分析の結果がサービス改善の意思決定に接続した実例がどの程度あるか。週報の高速化は手段であり、成果はその先にある。第三に、GPT-3.5/4の使い分け構成をその後のモデル更新でどう見直したか。2023年時点の構成が2026年も最適とは限らない。当事者からの補足があれば、お問い合わせフォームから歓迎する。
6. ここからは私の見立て
ここからは私の見立てとして書く。この事例の本質は「AIの導入順序が投資回収の構造を作る」ことにある。要約AIは単年の効率化で回収し、その副産物である構造化データが次のVoC分析の初期投資を実質的に肩代わりする。分析基盤を最初に建てる進め方と比べて、各段階が自分の費用を自分で説明できるため、稟議が通りやすく、途中で止めても損が出にくい。国内のセンターがAI投資を段階設計する際の、参照価値の高い順序だと考えている。
自己反証もしておく。この「効率化が先、分析が後」の順序は、裏を返せば分析の設計を後回しにするリスクを抱える。要約フォーマットを効率化目線だけで決めてしまうと、後から分析に必要な項目(感情、要望の粒度、属性)が抜けていることに気づき、フォーマット変更と再蓄積のやり直しが発生し得る。JWCRがこの罠をどう避けたかは公表情報からは読めない。順序を真似るなら、要約項目の設計時点で「将来何を集計したいか」を一度だけ先取りしておく必要がある。
まとめ
第一に、JWCRの事例は「通話要約で後処理を削る」第1段と「その蓄積でVoCを全件分析する」第2段の2段階構造であり、段の間に約1年強の蓄積期間がある。第二に、公表値には分母と定義の限定(18〜54%は実証3領域の範囲、月7万件は発表により定義が異なる)が付いており、横並び比較には使えない。第三に、再現の鍵は生成AIの性能ではなく、全応対を同一形式で残すデータ条件と、段階ごとに回収する投資設計にある。
あなたのセンターの要約AIは、今日の後処理を減らすだけの道具か、それとも1年後の分析基盤の原資を静かに積んでいる装置か。同じツールでも、要約フォーマットの設計ひとつで答えは分かれる。
よくある質問
Q1. 通話要約AIとVoC分析はどちらから導入すべきか。 JWCRの順序は要約が先である。要約は単段で後処理削減として回収でき、その出力がVoC分析の入力データになるため、投資の依存関係が一方向で済む。分析基盤を先に建てる場合は、入力となる構造化テキストを別途用意する必要がある。
Q2. 「後処理を最大54%削減」は自社でも期待できる数字か。 そのままは期待できない。この数字は2023年5〜8月の実証で、後処理時間が長い3業務領域を測った18〜54%という範囲の上限値であり、全社平均ではない。自社で見積もるなら、後処理が長い業務領域を先に特定し、その領域の実測から積み上げるのが筋である。
Q3. 小規模なコールセンターでも同じ順序は成立するか。 第1段(要約による後処理削減)は席数によらず成立し得る。第2段(VoC全件分析)は、分析結果を使う報告業務や改善プロセスが組織にあることが前提になるため、50席未満では第1段の回収に集中し、分析は集計項目の設計だけ先取りしておく形が現実的だ。
注記: 本稿は2026年9月1日時点の公開情報をもとにしたデスクリサーチであり、一次取材は行っていない。数字の出典主体(同社発表・ベンダー発表・業界誌報道)と時点は本文に明記した。見立ての部分は筆者個人の見解である。
出典
JR西日本「JR西日本カスタマーリレーションズとLLM DXパートナー ELYZA、通話内容要約業務に言語生成AIを導入」(2023年9月21日)
JR西日本「JR西日本カスタマーリレーションズとELYZA、生成AIを活用したVoC分析パッケージを開発、実運用を開始」(2024年12月3日)PDF
ELYZA(PR Times)「JR西日本カスタマーリレーションズとELYZA、生成AIを活用したVoC分析パッケージを開発、実運用を開始」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。