解決率73.1%、Intercomはなぜ自社でモデルを鍛え始めたのか ー「評価を作る力」がCSベンダーの堀を作り替える

2026年3月26日、Intercom(同年5月12日に社名を「Fin」へ変更。6月15日にはSalesforceが約36億ドルでの買収契約を発表し、2026年9月時点で未完了。本稿では発表時点の社名で表記します)が自社ブログに「Announcing Fin Apex: The age of vertical models is here」という記事を出しました。カスタマーサポートAI「Fin」の回答エンジンを、それまで使っていたGPTやClaude Sonnet 4.0から、自社でポストトレーニングしたモデル「Fin Apex 1.0」に置き換えたという発表です(出典:Intercom公式ブログ)。
同じ月、Decagonは「Decagon Labs」の設立を公表し、そこでこう書いています。自社のモデルトラフィックの80%超が、すでに自前で訓練したモデルの上で動いている、と(出典:Decagon公式ブログ)。
問いは「どのモデルが優秀か」ではありません。カスタマーサポート(以下CS)のベンダーが、なぜ自分でモデルを鍛え始めたのかです。先に述べると、私はこれをモデルの話ではなく、評価(Evals)を誰が持つかという話だと考えています。そして日本のCS業界にとって、そこが一番手薄な場所です。
1章:Sequoiaの記事に、CSの会社は一社も出てこない
きっかけは、米Sequoia Capitalが2026年8月19日に公開した「Own Your Intelligence: A How-To Guide」という記事です(出典:Sequoia Capital)。AIアプリ企業の競争軸が、「どのモデルを使うか」から「自社に必要な知能をどこまで自分で作り込むか」へ移った、という趣旨のものです。
Sequoiaはその手順を4段階で示しています。
Evals(評価):何を正解とするかを定義し、試験問題と採点基準を作る
Harness と Context:モデルの周りの段取りを設計する
Post-training(追加学習):モデル自体を鍛える
Online Learning:本番の利用履歴を回収し、改善を回し続ける
主役として登場するのは法務AIのHarveyです。同社は2026年5月にLegal Agent Benchmark(LAB)を公開しました。24の法務分野にまたがる1,200超のタスクと、専門家が記述した7万5,000項目以上の採点基準からなります(出典:Harvey公式ブログ)。そのうえで8月20日、Kimi K3を土台に追加学習したモデル「Harvey Tenet」を公開しました(出典:Harvey公式ブログ)。研究チームはわずか7名です(出典:Sequoia Capital)。
ここで押さえておきたいのは、このSequoiaの記事に、Sierra、Decagon、Intercom、CrestaといったCS領域の企業は一社も登場しないということです。にもかかわらず、4段階のうち①と③は、CS領域ですでに実行されています。もっと言えば、法務より先に走っていた部分すらあります。
比較対象を先に置きます。業種特化モデルを最初に名乗ったのは、法務でもコーディングでもなく、コンタクトセンターでした。Cresta が「世界初のコンタクトセンター基盤モデル」としてOcean-1を発表したのが2023年6月(出典:Contrary Research。Cresta公式の発表ページは現在アクセスできず、一次情報での確認は取れていません)、Observe.AIが300億パラメータのコンタクトセンター特化LLMを発表したのが同じく2023年6月です(出典:Observe.AI公式リリース)。Harvey Tenetの3年前です。
もっとも、単純に「CSが先行していた」と言うのは正確ではありません。この2社はその後、モデルの世代更新に関する公開情報が乏しく、Crestaは現在むしろ評価基盤側(評価器群とシミュレーション)の発信に軸足を移しています(出典:Cresta公式ブログ)。先に走ったことが、そのまま優位には転化していないというのが、事実から読める姿です。
2章:CS領域で実際に起きた3つの動き
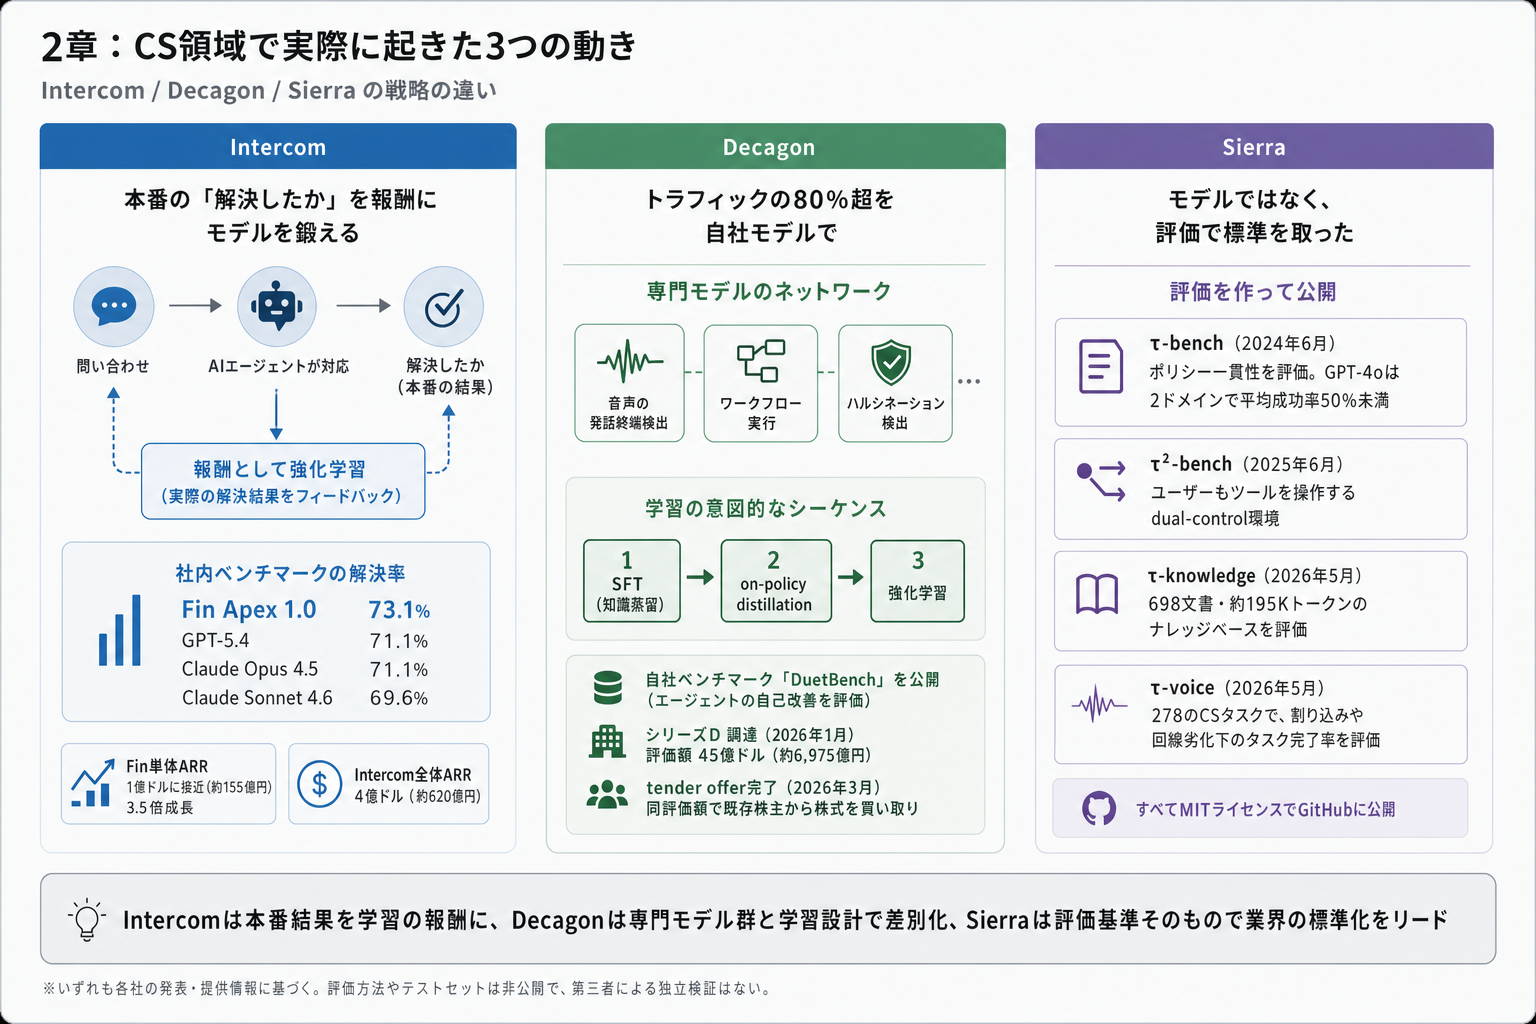
Intercom ー 本番の「解決したか」を報酬にモデルを鍛える
Fin Apex 1.0は、オープンウェイトモデルを土台にした数千億パラメータ級のモデルです。ベースモデル名は非開示で、理由は競争上の配慮と、今後ベースモデルを乗り換える予定があることの2つだと説明されています(出典:VentureBeat、Intercomへの取材コメント)。特徴は学習の回し方です。Finはいま週200万件近い問い合わせを解決する規模で動いており、その本番運用を土台に、実際に問い合わせが解決したかどうか(real resolution outcomes)を報酬とする強化学習を行っていると、IntercomはVentureBeatの取材に説明しています(出典:VentureBeat。週200万件の規模はIntercom公式ブログ)。
公表された社内ベンチマークの結果は次の通りです。なおこれはIntercomが報道機関に個別提供した数値で、同社の公式サイトには「Sonnet 4.6比で解決率2.8%向上」といった本番環境での相対値しか掲載されていません(下表の差3.5ポイントとは別の測定です。出典:VentureBeat、Intercom提供値、fin.ai/cx-models)。
モデル | 解決率 |
|---|---|
Fin Apex 1.0 | 73.1% |
GPT-5.4 | 71.1% |
Claude Opus 4.5 | 71.1% |
Claude Sonnet 4.6 | 69.6% |
Fin単体のARRは1億ドル(約155億円)に接近し、3.5倍成長。Intercom全体のARRは4億ドル(約620億円)とされています(出典:VentureBeat、Intercom提供値)。
ただし、この評価はIntercom独自の社内ベンチマークで、テストデータセットも評価基準も測定方法も公開されていません(出典:fin.ai/cx-models)。第三者による独立検証はありません。
Decagon ー トラフィックの80%超を自社モデルで
Decagonは汎用の基盤モデルを作るのではなく、「専門モデルのネットワーク」を構築すると表明しています。音声の発話終端検出、ワークフロー実行、ハルシネーション検出を、それぞれ別のモデルが担当する構成です(出典:Decagon公式ブログ)。
追加学習の順序も公開されています。SFT(フロンティアモデル群からの知識蒸留)→ on-policy distillation → 強化学習、という3段階を「意図的なシーケンス」として実施しているとしています(出典:Decagon公式ブログ)。2026年6月には、エージェントの自己改善を評価する自社ベンチマーク「DuetBench」も発表しました(公開データセットではありません。出典:Decagon公式ブログ)。
同社は2026年1月に評価額45億ドル(約6,975億円)でシリーズDを調達し、3月には同じ評価額で従業員向けのtender offer(既存株主からの株式買い取り)を完了しています(出典:Decagon公式ブログ、TechCrunch)。
Sierra ー モデルではなく、評価で標準を取った
そしてSierraです。同社はHarvey Tenetに相当する命名された自社モデルを公表していません。ノイズの多い多人数環境向けに発話区間検出(VAD)モデルを自社訓練したこと(出典:Sierra「Engineering low-latency voice agents」)、15以上のモデルを組み合わせる構成であること(出典:Sierra「Constellation of models」)は公表していますが、垂直モデルを製品の看板にはしていません。
代わりに何をしたか。評価を作って、公開しました。
τ-bench(2024年6月):シミュレートされた人間ユーザーとAPIの両方を相手に、ドメイン固有ポリシーを一貫して守れるかを測る。GPT-4oの平均成功率は2ドメインで50%未満(出典:Sierra公式ブログ、arXiv 2406.12045)
τ²-bench(2025年6月):ユーザー側もツールを操作するdual-control環境(出典:arXiv 2506.07982)
τ-knowledge(2026年5月):698文書・約195Kトークンのナレッジベースを辿らせる(出典:Sierra公式ブログ)
τ-voice(2026年5月):278のカスタマーサービスタスクで、割り込みや回線劣化を含む音声条件下のタスク完了率を測る(出典:Sierra公式ブログ)
これらはMITライセンスでGitHubに公開されています(出典:github.com/sierra-research/tau2-bench)。
そして決定的なのはここです。OpenAIは2026年4月23日のGPT-5.5の公式発表で、τ²-bench Telecomのスコアを掲載しました(GPT-5.5が98.0%、GPT-5.4が92.8%。いずれもプロンプト調整なしの条件下の自己申告値で、他社モデルのスコアは併載されていません。OpenAIは、プロンプト調整ありで測定された他社の結果を除外したと注記しています。出典:OpenAI公式)。フロンティアラボが、CSベンダーの作った物差しで自社モデルを名乗っている。
Sierraは2026年5月に9.5億ドルを調達し、ポストマネー評価額は150億ドル(約2兆3,250億円)超とされています(出典:TechCrunch、CNBC)。ARRは3年目に入る時点で1億5,000万ドル超と自社が公表しています(出典:Sierra公式ブログ)。
3章:型に抜き出すと3つある
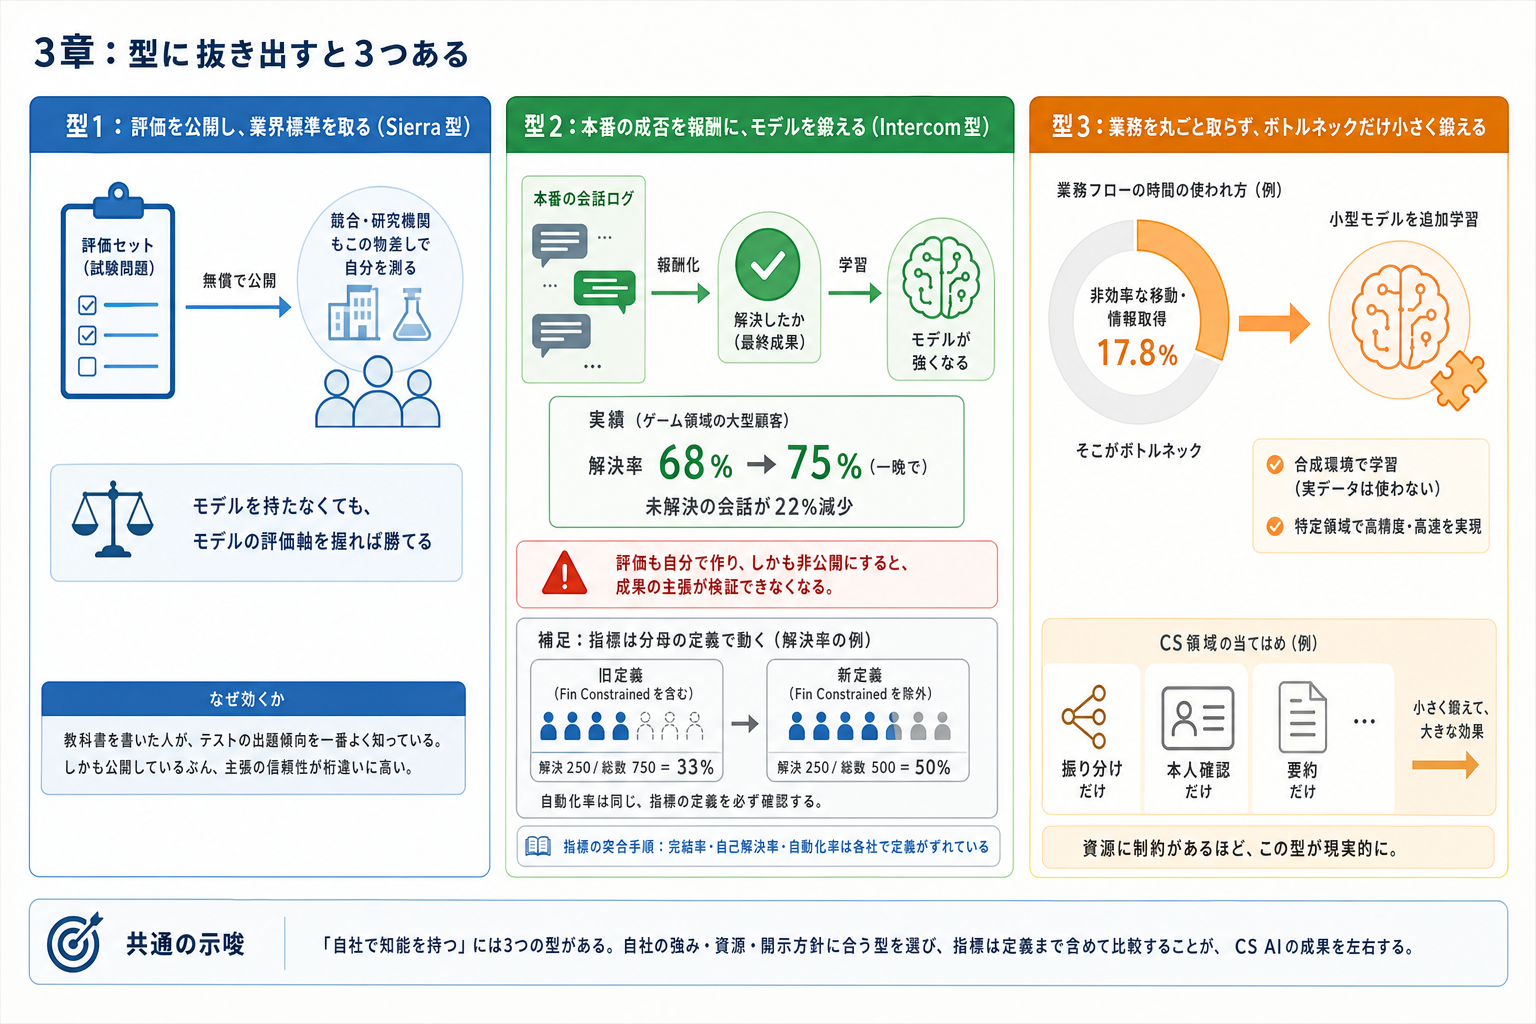
ここまでの事実を、再現可能な型として3つに抜き出します。
型1:評価を公開し、業界標準を取る(Sierra型)
自分で試験問題を作り、それを無償で配る。競合も、フロンティアラボも、その物差しで自分を測るようになる。モデルを持たなくても、モデルの評価軸を握れば勝てるという別解です。
なぜ効くか。教科書を書いた人が、テストの出題傾向を一番よく知っているからです。しかも公開しているぶん、主張の信頼性が桁違いに高い。
型2:本番の成否を報酬に、モデルを鍛える(Intercom型)
「解決したか」という業務の最終成果をそのまま報酬関数にする。ログは分析対象ではなく、燃料になります。ゲーム領域の大型顧客で解決率が一晩で68%から75%に改善した、言い換えれば未解決の会話が22%減った、というのがIntercomの説明です(出典:Intercom公式ブログ)。
ただしこの型には弱点があります。評価も自分で作り、しかも非公開にすると、成果の主張が検証できなくなる。Sierraとの非対称はここです。モデルは内製、評価は公開。モデルも評価も内製・非公開。同じ「自社で知能を持つ」でも、外から見える確からしさが違います。
補足:ベンダーの公表する「解決率」は、分母の定義で動く
型2に関わる事実として、実務者向けに必ず押さえておきたい点を挟みます。
Intercomは2026年、Finの性能指標の定義を変更しました。「Fin Constrained」(Finが有効だったが回答機会を得られなかった会話)を分母から除外する、というものです。公式ヘルプに例が示されています。同じ実績で、解決率は33%(250÷750)から50%(250÷500)へ動きます(出典:Intercom公式ヘルプ)。自動化率は変わりません。
ベンダーが悪意でやっているという話ではなく、公式に開示された変更です。ただ、「解決率」という一語をベンダー横断で並べて比較することの危うさは、これで十分に示されていると思います。RFPで比較表を作るとき、数字の隣に分母の定義を書かせるかどうかで、意思決定の質が変わります。指標の突合手順は、当ラボの完結率・自己解決率・自動化率は各社で定義がずれているにまとめています。
型3:業務を丸ごと取らず、ボトルネックだけ小さく鍛える
法人支出管理のRampは、自社エージェントの道具呼び出しのうち17.8%が表計算内の非効率な移動と情報取得に費やされていることを特定し、そこだけを担う小型モデルをオープンモデルから追加学習しました。結果、完全一致の正答率でAnthropicのClaude Opus 4.6を約4ポイント上回りながら、応答速度はClaude Haiku 4.5とほぼ同等(正規化レイテンシ1.05倍)だったとしています(出典:Ramp Labs)。学習に使ったのは顧客の実データではなく、本番で起きるはずの失敗を人工的に再現した合成環境です。
CS領域で言えば、「対応を全部AIに」ではなく、「振り分けだけ」「本人確認だけ」「要約だけ」を小さく鍛える形です。資源に制約があるほど、この型が現実的になります。
4章:日本のCS業界はどこに立っているか
ここから事実の整理を離れ、見立てを書きます。
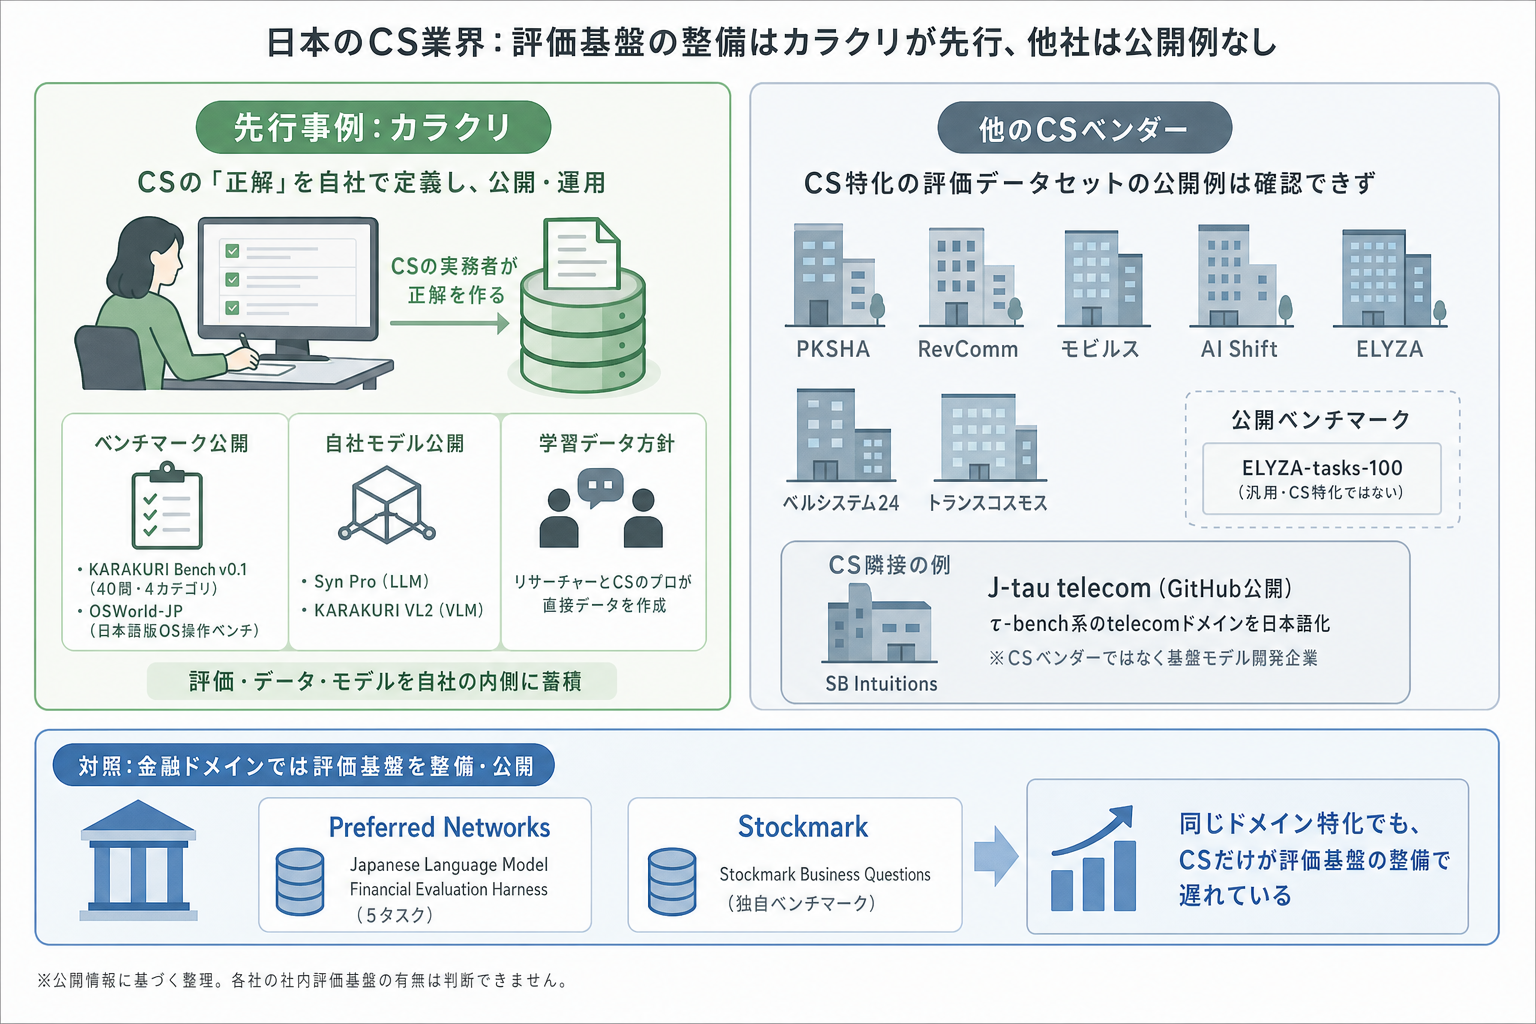
日本には、CS業務の「正解」を定義した公開物がほとんどない
国内のコンタクトセンター/CS領域のAI各社について、公開されている評価ベンチマークを探しました。見つかったのは、実質1本です。
カラクリの「KARAKURI Bench v0.1」。カスタマーサポートでの生成AI利用を想定した日本語ベンチマークで、Hugging FaceにApache-2.0で公開されています。40問構成で、reader(ナレッジからの回答生成)、japanese(文法訂正・曖昧性検出)、writing(FAQ・マニュアル・謝罪文)、business(CS業務知識)の4カテゴリ。各問に配点付きのルーブリックが定義されています(出典:Hugging Face karakuri-ai/karakuri-bench-v0.1)。
同社はさらに、国際的に使われるベンチマークOSWorldの日本語版「OSWorld-JP」を自社で作り、GitHubに公開し、JSAI2025(人工知能学会全国大会)で発表しています(出典:GitHub karakuri-ai/OSWorld-JP、JSAI2025予稿)。同社は自社モデルも公開しており、LLM「Syn Pro」(2025年10月)、視覚言語モデル「KARAKURI VL2」(2026年4月)があります。
学習データについても、同社は公式サイトで、学習データの品質がそのまま出力精度になるという信念のもと、多くの会社が外部委託する中でカラクリは自社のリサーチャーとCSのプロが直接データを作成する、と明記しています(出典:カラクリ公式)。
これはHarveyが、実務弁護士の実案件をもとに専門家が7万5,000項目超の採点基準を書いたとしているのと、同じ論法です。顧客の対話ログを溜めて賢くするのではなく、CSの実務者が正解を書き下ろす。Sequoiaの記事が、評価や顧客対話といった独自データを自社の内側に置くことを勧めている点に照らせば、国内で最もはっきりした実例だと思います。
一方、PKSHA、RevComm、モビルス、AI Shift、ELYZA、ベルシステム24、トランスコスモスについては、CS特化の評価データセットを公開しているものは確認できませんでした。社内で評価基盤を持っているかどうかは、公開情報からは判断できません(ELYZAは汎用の日本語ベンチマーク「ELYZA-tasks-100」をHugging Faceで公開していますが、CS特化ではありません)。CS隣接では、SB Intuitionsがτ-bench系(τ²-benchのtelecomドメイン)を日本語化した「J-tau telecom」をGitHubに公開していますが(出典:SB Intuitions技術ブログ)、同社はCSベンダーではなく基盤モデル開発企業です。
対照的なのが金融です。Preferred Networksは金融特化型PLaMoと合わせて、自社開発の「Japanese Language Model Financial Evaluation Harness」(5タスク)を評価基盤として整備しています(出典:Preferred Networks)。Stockmarkも独自ベンチマーク「Stockmark Business Questions」をHugging Faceで公開しています(出典:Stockmark)。同じドメイン特化でも、CSだけが評価基盤の整備で遅れているというのが、調べた範囲での結論です。
自己反証:カラクリを持ち上げすぎないための事実
もっとも、私の見立てに不利な事実も挙げておきます。
KARAKURI Benchは40問です。Harveyの7万5,000項目の採点基準と比べれば、規模は3桁違う。業界標準というより「評価の型を示した最初の一歩」と見るのが実態に近い。
また、Syn Proの「日本語性能1位」は、Nejumi Leaderboard 4における32Bパラメータ以下という限定条件付きの主張です(出典:カラクリ公式リリース)。KARAKURI VL2のOSWorld-JP v0.2の結果も、GIMPやThunderbirdの個別タスクではClaude Sonnet 4.6を上回るものの、総合スコアは0.331で、Claude Sonnet 4.6の0.593に及んでいません(出典:カラクリ公式リリース)。同社の自社公表値です。
そして2026年のカラクリの重心は、モデル公開よりも事業モデルの転換にあります。成果報酬型プラン、アウトカム課金のボイスエージェント、EC特化のBPO『AgenticCS BPO』。モデル開発は、その原価を下げる手段として位置づけられている構図に見えます(出典:カラクリ公式リリース各種)。
日本のCS業界の条件をどう読むか
不利な条件から書きます。CS業務は同業でも会社ごとに手順が違い、「業界の正解」を定義しにくい。加えて、専門家を組織に抱えているのはベンダーではなくBPO事業者や事業会社のCS部門です。Harveyは実務弁護士の実案件を素材にできたから7万5,000項目を書けました。CSベンダーの多くはエンジニア中心の組織です。
有利な条件もあります。日本のコンタクトセンターには、文書化されていない判断ルールが濃く残っています。エスカレーション基準、言い回しの許容範囲、クレームの初期対応。従来これは属人化という負債として語られてきましたが、学習データの原材料としては資産です。そして専門家の時間単価は米国より安い。同じ予算で作れる正解データの量が違います。
土台モデルも無償で手に入ります。カラクリのVL2はQwen3-VL-8B-Thinking、Harvey TenetはKimi K3、RampのFast AskはQwenが土台でした。出発点は買わなくていい。
なお、以上は米欧のCSベンダーと国内の公開情報から推論したものであり、国内の実データで検証したものではありません。
まとめ
第一に、Sequoiaの言う「知能の内製化」は、CS領域ではすでに実行段階にあります。Intercomは本番の解決成否を報酬にモデルを鍛え、Decagonはトラフィックの80%超を自社モデルで動かしている。Harvey Tenetと同じことが、CSではその5か月前に起きていました(名乗りだけなら、2023年のCrestaとObserve.AIまで遡ります)。
第二に、その中で最も強い立場を取ったのは、モデルを持たないSierraでした。評価を作って公開し、OpenAIが自社モデルの発表でそれを引用するところまで持っていった。モデルは調達できても、正解の定義は調達できない。ここが競争の焦点になったということです。
第三に、日本のCS領域には、その正解を書き下ろした公開物がほぼありません。カラクリのKARAKURI Bench 40問と、OSWorld-JPがあるだけです。金融には評価ハーネスがあり、ビジネス知識にもある。CSにない。
そのうえで、最後は問いにします。
自社のCS業務について、「これができたら合格」と言える採点基準を、何項目書けますか。書けるとしたら、それを書けるのは社内の誰か。
その人数と、その人が正解を書くのに使える時間。それが、これからのCS×AIで手に入る精度の上限だと、私は考えています。
注記
本稿の数値は2026年9月3日時点で確認したものです。
円換算は1ドル155円で計算しています。
記載した企業の性能数値は、断りのない限り各社の自社公表値であり、第三者による独立検証を経ていません。特にIntercom、Decagon、Cresta、Observe.AI、カラクリの性能主張は自社ベンチマークまたは自社調査によるものです。Sierraのτ-bench系は例外的に、OpenAIが外部から採用している点で検証水準が異なります。
Fin(旧Intercom)が公表する本番環境の平均解決率76%(2026年6月時点・全顧客平均)は、本稿の社内ベンチマーク73.1%とは別の指標であり、分母の定義は非開示です。
4章以降は筆者の解釈であり、確立された事実ではありません。
調査およびリサーチの整理にAIを活用しています。
参考リンク
当ラボの関連記事
完結率・自己解決率・自動化率は各社で定義がずれている ー 指標を突合するチェックリスト https://ccai-lab.com/articles/2026-08-11-metrics-definition-audit
成果課金はコンタクトセンターに定着するのか ー「解決1件いくら」の価格設計が問い直すもの https://ccai-lab.com/articles/2026-07-24-outcome-based-pricing-cc
コールセンター向けLLMはどう選ぶのか ー レイテンシ・日本語・コスト・ガバナンスの評価軸 https://ccai-lab.com/articles/2026-08-06-llm-model-selection-cc
聞き返しは課金しない、回答完了で課金する。カラクリGeNの成果報酬型プランが国内に持ち込んだ「解決の定義」 https://ccai-lab.com/articles/2026-08-27-karakuri-gen-outcome-pricing
一次情報(公式・本人発信)
Sequoia Capital「Own Your Intelligence: A How-To Guide」(2026/8/19)競争軸の4段階フレーム https://sequoiacap.com/article/own-your-intelligence-a-how-to-guide
Harvey「Introducing Harvey's Legal Agent Benchmark」(2026/5/6)24分野・1,200超タスク・7.5万項目の採点基準 https://www.harvey.ai/blog/introducing-harveys-legal-agent-benchmark
Harvey「Update on Harvey's Post-Training Effort」(2026/8/20)Harvey Tenetの構成と学習手法 https://www.harvey.ai/blog/post-training-update-harvey-tenet
Intercom「Announcing Fin Apex: The age of vertical models is here」(2026/3/26)週200万会話・解決成否を報酬とするRL https://www.intercom.com/blog/announcing-fin-apex-the-age-of-vertical-models-is-here/
Intercom「Today Intercom becomes Fin」(2026/5/12)社名変更 https://www.intercom.com/blog/today-intercom-becomes-fin/
Salesforce「Salesforce Signs Definitive Agreement to Acquire Fin」(2026/6/15)約36億ドル・完了はFY2027 Q4予定 https://www.salesforce.com/news/press-releases/2026/06/15/salesforce-signs-definitive-agreement-to-acquire-fin/
Intercom「Update to Fin performance metrics」解決率の分母定義変更(33%→50%の例示) https://www.intercom.com/help/en/articles/15599377-update-to-fin-performance-metrics
Fin「CX Models」性能主張と方法論非開示 https://fin.ai/cx-models
Decagon「Introducing Decagon Labs」(2026/3/24)モデルトラフィックの80%超が自社訓練モデル https://decagon.ai/blog/introducing-decagon-labs
Decagon「Decagon's $250 million commitment to the AI concierge future」(2026/1/27)評価額45億ドルのシリーズD https://decagon.ai/blog/series-d-announcement
Decagon「Why off-policy training isn't enough」(2026/3/25)SFT→on-policy distillation→RLの3段階 https://decagon.ai/blog/why-off-policy-training-isnt-enough
Decagon「DuetBench」(2026/6/9)自己改善を評価する自社ベンチマーク https://decagon.ai/blog/duetbench
Sierra「Benchmarking AI agents(τ-bench)」(2024/6)GPT-4oの成功率50%未満 https://sierra.ai/blog/benchmarking-ai-agents
τ²-bench 論文(arXiv 2506.07982)dual-control環境 https://arxiv.org/abs/2506.07982
Sierra「τ-voice」(2026/5/1)278タスクの音声エージェント評価 https://sierra.ai/blog/tau-voice-benchmarking-real-time-voice-agents-on-real-world-tasks
Sierra「τ-knowledge」(2026/5/13)698文書のナレッジベース探索評価 https://sierra.ai/blog/tau-knowledge
tau2-bench(GitHub、MITライセンス) https://github.com/sierra-research/tau2-bench
OpenAI「Introducing GPT-5.5」τ²-bench Telecomのスコア掲載 https://openai.com/index/introducing-gpt-5-5/
Sierra「Constellation of models」15以上のモデルを組み合わせる構成 https://sierra.ai/blog/constellation-of-models
Sierra「Engineering low-latency voice agents」VADモデルの自社訓練 https://sierra.ai/blog/voice-latency
Sierra「Year two in review」(2026/2/6)ARR 1億5,000万ドル超 https://sierra.ai/blog/year-two-in-review
Cresta「How Cresta Grades Its Agents」(2026/8/3)評価器のハイブリッド構成 https://cresta.com/blog/how-cresta-grades-its-agents-evaluators-in-an-llm-world
Observe.AI「30-Billion-Parameter Contact Center LLM」(2023/6/20)数億件の顧客インタラクションで学習 https://www.observe.ai/press-releases/contact-center-llm-generative-ai
Ramp Labs「Building Fast & Accurate Agents with Prime-RL Post Training」(2026/5/7)17.8%のボトルネックだけを鍛える https://labs.ramp.com/research/prime-rl-post-training/
カラクリ「KARAKURI LMについて」学習データ作成体制の記述 https://karakuri.ai/gai/karakuri-lm
KARAKURI Bench v0.1(Hugging Face、Apache-2.0、40問) https://huggingface.co/datasets/karakuri-ai/karakuri-bench-v0.1
OSWorld-JP(GitHub) https://github.com/karakuri-ai/OSWorld-JP
OSWorld-JP 論文(JSAI2025) https://www.jstage.jst.go.jp/article/pjsai/JSAI2025/0/JSAI2025_3Win556/_article/-char/ja
カラクリ「Syn Pro」(2025/10/24)Nejumi Leaderboard 4・32B以下で日本語1位 https://prtimes.jp/main/html/rd/p/000000133.000025663.html
カラクリ「KARAKURI VL2」(2026/4/21)OSWorld-JP v0.2の評価結果 https://prtimes.jp/main/html/rd/p/000000151.000025663.html
カラクリ「AgenticCS BPO」(2026/3/31) https://karakuri.ai/news/Agenticcs_bpo
SB Intuitions「J-tau telecom」(2026/6/19)τ-bench telecomの日本語化 https://www.sbintuitions.co.jp/blog/entry/2026/06/19/100154
Preferred Networks「金融特化型PLaMo」(2025/6/17)金融評価ハーネス5タスク https://www.preferred.jp/ja/news/pr20250617
Stockmark「Stockmark-2-100B-Instruct-beta」(2025/3/18)自社ベンチマークでの評価 https://stockmark.co.jp/r-and-d/topics/20250318/
報道・調査
VentureBeat「Intercom's new post-trained Fin Apex 1.0 beats GPT-5.4 and Claude Sonnet 4.6」解決率73.1%とARR https://venturebeat.com/technology/intercoms-new-post-trained-fin-apex-1-0-beats-gpt-5-4-and-claude-sonnet-4-6
TechCrunch「Decagon completes first tender offer at $4.5B valuation」(2026/3/4) https://www.techcrunch.com/2026/03/04/decagon-completes-first-tender-offer-at-4-5b-valuation/
TechCrunch「Sierra raises $950M」(2026/5/4)評価額150億ドル超 https://techcrunch.com/2026/05/04/sierra-raises-950m-as-the-race-to-own-enterprise-ai-gets-serious/
CNBC「Bret Taylor's Sierra raises nearly $1B」 https://www.cnbc.com/2026/05/04/bret-taylor-sierra-fundraise-openai.html
Contrary Research「Cresta Business Breakdown」Ocean-1が2023年6月発表であることの裏付け https://research.contrary.com/company/cresta
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。