明治安田生命のコールセンターは5年で何を積み上げたのか ー 2020年の音声認識から2024年の応対メモ自動生成まで、年55万件の照会を支える土台を時系列で読む

明治安田生命保険相互会社は2024年1月22日、同社のニュースリリースで、年間約55万件の電話照会を受けるコミュニケーションセンターに生成AIを導入し、応対メモの作成業務にかかる時間を約30%削減する「見込み」だと発表した(同社発表・導入前の想定値)。目を引くのは生成AIの部分だが、本稿の核はそこではない。この発表が成立した理由を遡ると、2020年5月に本稼働していた約300席の音声認識にたどり着く。応対メモを自動生成するには、まず通話がテキストになっていなければならない。この記事で言えるのは、公表情報から再構成した「順序」と、その順序を支えた条件までであり、削減効果の実績値は2026年9月時点で未公表のため断定できない。数字はすべて発表主体と性質(実績か見込みか)を添えて読んでいく。
1. 公表事実の時系列 ー 「メモ自動生成」の前に4年ある
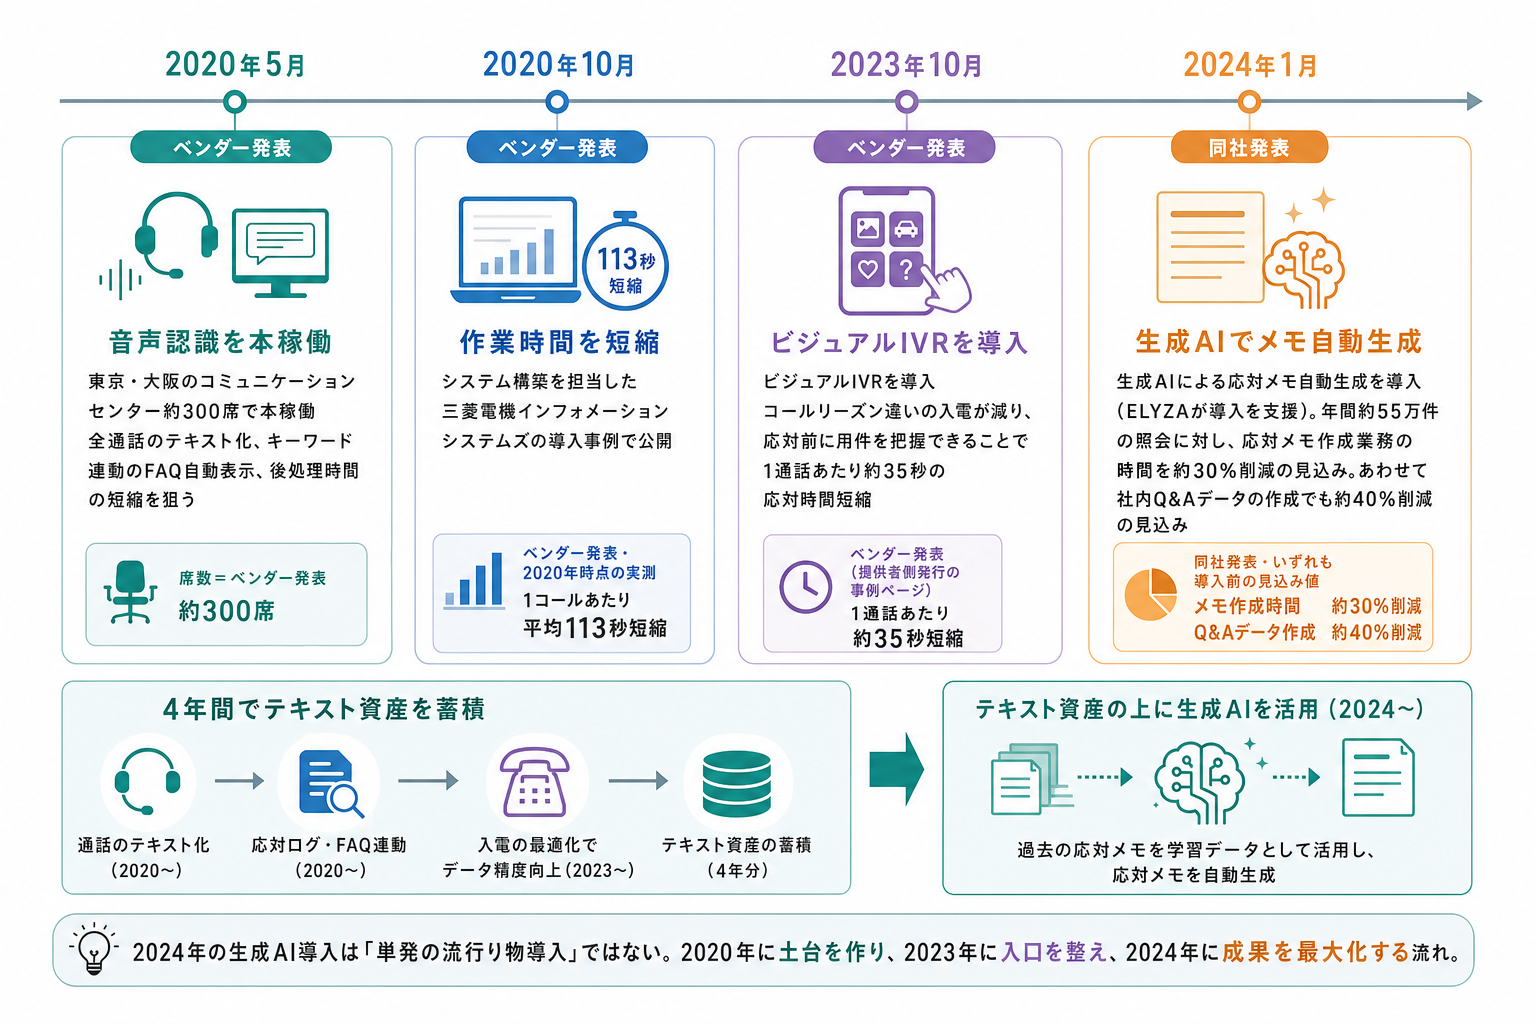
公表されている事実を時系列に並べる。発表主体と数値の性質を必ずセットで見てほしい。
年月 | 発表主体 | 事実 | 数値の性質 |
|---|---|---|---|
2020年5月 | ベンダー発表 | 音声認識「AmiVoice Communication Suite」が東京・大阪のコミュニケーションセンター約300席で本稼働(5月7日)。全通話のテキスト化、キーワード連動のFAQ自動表示、後処理時間の短縮を狙う(アドバンスト・メディアのリリース、発表は同年10月20日) | 席数=ベンダー発表 |
2020年12月 | ベンダー発表 | システム構築を担当した三菱電機インフォメーションシステムズの導入事例が公開。1コールあたりの作業時間を平均113秒短縮とする | ベンダー発表・2020年時点の実測 |
2023年10月 | ベンダー発表 | モビルスの導入事例によると、ビジュアルIVRを導入。コールリーズン違いの入電が減り、応対前に用件を把握できることで1通話あたり約35秒の応対時間短縮 | ベンダー発表(提供者側発行の事例ページ) |
2024年1月 | 同社発表 | 生成AIによる応対メモ自動生成を導入(ELYZAが導入を支援)。年間約55万件の照会に対し、応対メモ作成業務の時間を約30%削減の見込み。あわせて社内Q&Aデータの作成でも約40%削減の見込み | 同社発表・いずれも導入前の見込み値 |
この並びから読み取るべきは、2024年の生成AI導入が「単発の流行り物導入」ではないことだ。2020年に通話のテキスト化という土台を作り、2023年に入電の入口(ビジュアルIVR)を整え、2024年にテキスト資産の上へ生成AIを載せた。応対メモの自動生成は、過去の応対メモを学習データとして使える状態、つまり4年分のテキスト資産があって初めて成立する。
2. 数字の読み方 ー 「30%削減」は後処理全体ではない
数字は定義を確かめてから使いたい。第一に、「約30%削減」の対象は同社リリースの原文では「応対メモの作成業務にかかる時間」であり、後処理(ACW)全体ではない。後処理には手続き処理やシステム入力など他の作業も含まれるため、「後処理が3割減る」と読み替えると過大評価になる。第二に、30%と40%はいずれも導入前の想定値で、達成したという発表は2026年9月時点で確認できない。第三に、約300席は2020年時点、年約55万件は2024年発表時点の数字であり、時点が違う。掛け合わせて「席あたり件数」を計算するような使い方はできない。
同業のかんぽ生命と比べてみる。日本経済新聞の報道によると、かんぽ生命はコールセンターのAI活用に60億円を投じる一方、人員はむしろ増やして対話を重視する方針だ(報道・2026年2月)。同じ生保のセンターでも、明治安田が「メモ作成という特定業務の時間削減」を積み上げ型で進めるのに対し、かんぽは投資額と人員方針を先に掲げる。ただし両社は事業規模もチャネル構成も照会の中身も異なり、どちらが優れているかをこの比較から言うことはできない。読み取れるのは、生保のセンターAIに「業務単位の効率化を積む道」と「体制ごと投資する道」の2通りの進め方が併存している、という事実までだ。
3. なぜ明治安田はこの順序で進められたのか ー 条件を4軸で分解する
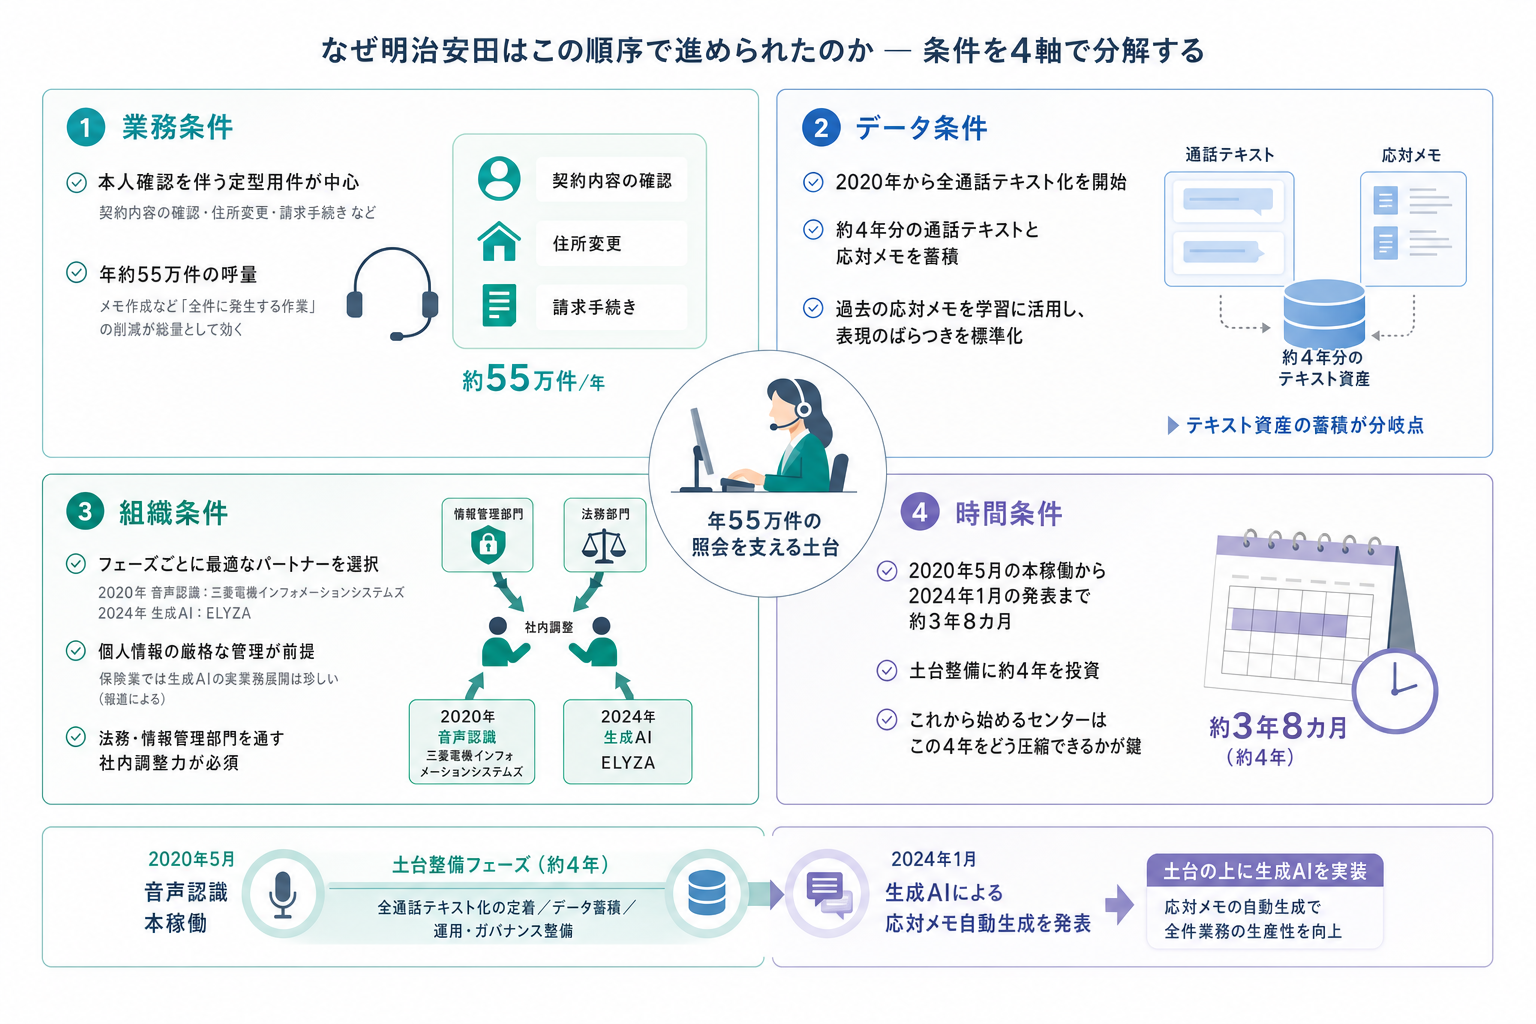
ベンダーの事例ページは「何を入れたか」と「効果」しか書かない。記事として価値があるのは条件の分解なので、公表情報から4軸で推定できる範囲を整理する。
① 業務条件。 生保の電話照会は、契約内容の確認・住所変更・請求手続きなど、本人確認を伴う定型性の高い用件が太い。年約55万件という呼量は、メモ作成のような「全件に発生する数十秒〜数分の作業」の削減が総量として効く規模であり、1件あたりの小さな時短を積む投資が正当化しやすい。
② データ条件。 2020年の音声認識で全通話テキスト化が始まっており、2024年の生成AI導入時点で約4年分の通話テキストと応対メモの蓄積があった。ELYZAのリリースも、過去の応対メモを学習に使い表現のばらつきを標準化したことに触れている。ここが最大の分岐点で、テキスト資産ゼロの状態から「メモ自動生成」だけを入れることはできない。
③ 組織条件。 2020年の音声認識はシステムインテグレーターの三菱電機インフォメーションシステムズが構築を取りまとめ、2024年の生成AIは国産LLMのELYZAが支援と、フェーズごとに組む相手を替えている。保険業は個人情報の扱いが厳しく、IT Leadersの報道も、機微な個人情報を含む業務で生成AIを実業務展開した例は保険業界では珍しいと伝えている。法務・情報管理部門を通す社内調整力そのものが条件だったと言える。
④ 時間条件。 音声認識の本稼働(2020年5月)から生成AI導入発表(2024年1月)まで約3年8カ月。土台整備に約4年かけている。逆に言えば、これから始めるセンターが同じ到達点に最短で行けるかは、この4年をどこまで圧縮できるかの問題になる。
4. 真似できる条件・できない条件
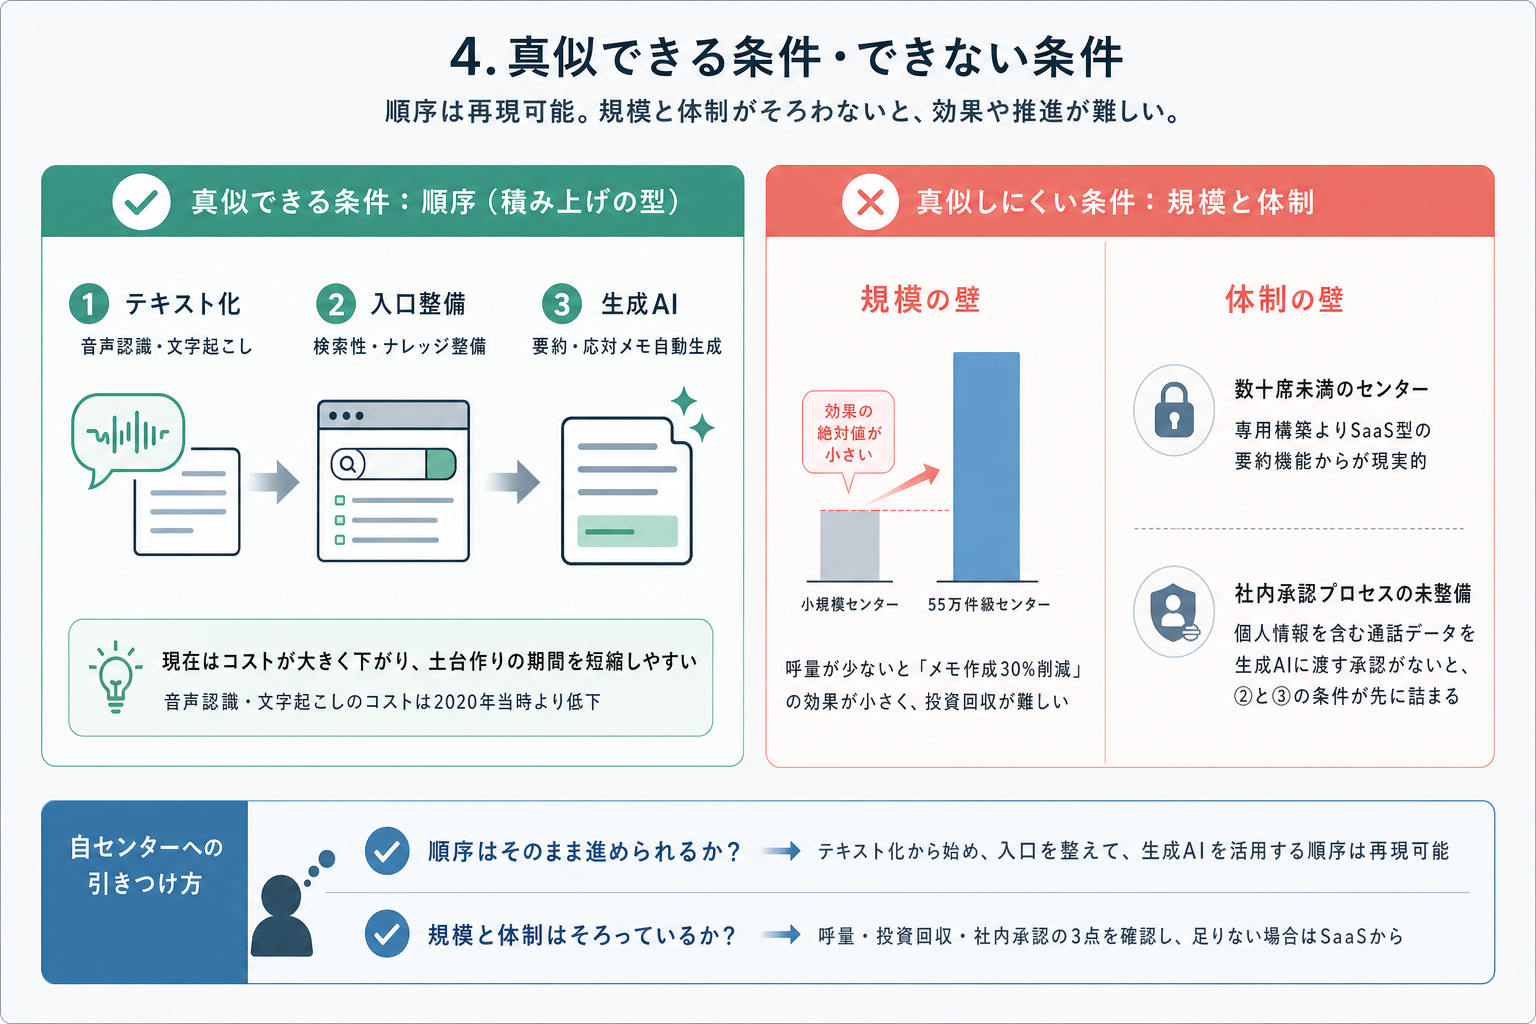
読者のセンターに引きつけて仕分ける。真似できるのは順序だ。「テキスト化→入口整備→生成AI」という積み方は、規模を問わず再現できる。現在は音声認識と文字起こしのコストが2020年当時より大きく下がっており、土台作りの期間は短縮できる可能性が高い。真似しにくいのは規模と体制で、年55万件級の呼量がないセンターでは「メモ作成30%削減」の絶対効果が小さく、投資回収の計算が合いにくい。目安として、数十席未満のセンターなら専用構築よりSaaS型の要約機能から入る方が現実的だし、個人情報を含む通話データを生成AIに渡す社内承認プロセスを持たない組織では、②と③の条件が先に詰まる。
5. 未公表の論点 ー 当事者にしか答えられない3つ
公開情報では届かない論点を挙げておく。第一に、30%・40%の見込みは実績としてどうだったのか。達成・未達とその要因は、後続センターにとって最も価値のある情報だ。第二に、自動生成されたメモの品質管理を誰がどう担っているのか。誤要約の検知と修正のフローは公表されていない。第三に、メモ作成時間が減った分のオペレーターの時間は何に再配分されたのか。応対品質か、席数調整か、それ以外か。これらは当事者にしか答えられない。当事者からの補足があれば、お問い合わせフォームから歓迎する。
6. 参考になるのは適用先の絞り方
明治安田の事例で最も参考になるのは、生成AIの適用先を「顧客との対話」ではなく「メモ作成」という社内向け業務に絞ったことだと見ている。顧客応対そのものをAIに任せると、誤答がそのまま顧客に届くリスクを負うが、メモ生成なら出力を人が確認してから確定でき、失敗のコストが社内に閉じる。個人情報の厳しい業界で本番運用まで到達できたのは、この「失敗が顧客に露出しない業務」を選んだ設計に依るところが大きいはずだ。
自己反証もしておく。この読み方には「単に2020年当時の技術では音声認識しかできなかっただけで、順序は結果論だ」という反論が成り立つ。実際、生成AIが2020年に実用レベルであれば、同社が同じ4年をかけたかは分からない。ただ、仮に結果論だとしても、テキスト資産の蓄積が生成AI活用の前提条件になったという因果は変わらない。これから始める側にとって「先に資産を作った者が次の技術をすぐ載せられる」という教訓の価値は、順序が意図的だったかどうかに依存しない。
まとめ
第一に、明治安田の応対メモ自動生成は単発導入ではなく、2020年の音声認識300席から約4年の積み上げの最終工程である。第二に、公表数値は「メモ作成業務の時間を約30%削減の見込み」であり、後処理全体の実績値ではない。数字は対象業務・時点・性質(見込みか実績か)を確かめてから使うべきだ。第三に、真似できるのは規模ではなく順序であり、テキスト資産の蓄積が生成AI適用の前提になる。あなたのセンターの通話は、いま何年分テキストになっていますか。
よくある質問
Q1. 明治安田生命のコールセンターはどんなAIを導入していますか? A. 公表情報では、2020年5月に音声認識「AmiVoice Communication Suite」を東京・大阪の約300席で本稼働(ベンダー発表)、2023年10月にモビルスのビジュアルIVRを導入(ベンダー事例)、2024年1月にELYZAの支援で生成AIによる応対メモ自動生成を、カラクリの技術で社内Q&Aデータ作成を導入(同社発表)しています。
Q2. 「応対メモ作成30%削減」は実績ですか? A. 導入前の見込み値です(2024年1月22日の同社リリース)。対象も「応対メモの作成業務にかかる時間」であり、後処理全体ではありません。実績値の公表は2026年9月時点で確認できていません。
Q3. 小規模なコールセンターでも同じ進め方はできますか? A. 「通話のテキスト化→入口の整備→生成AIの適用」という順序自体は規模を問わず参考になります。ただし数十席未満のセンターでは専用構築の投資対効果が合いにくく、SaaS型の音声認識・要約機能から始める方が現実的です。
注記
本稿は2026年9月8日時点の公開情報に基づくデスクリサーチであり、一次取材は行っていません。見解は筆者個人のものです。数値の出典主体は本文に明記した通り、同社発表(明治安田生命リリース)とベンダー発表(アドバンスト・メディア、三菱電機インフォメーションシステムズ、モビルス、ELYZA)が混在しており、ベンダー発表値は提供者側の発行物である点に留意してください。正式社名は明治安田生命保険相互会社(ブランド名: 明治安田)で、明治安田損害保険は別法人です。
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。