コールセンターAIのPoC評価項目と合格基準 ー ボイスボットを本番化する前の試験設計

Gartnerが432件のAIカスタマーサービス・ユースケースを分析した結果では、ROIを生み出せていたのは25%にとどまり、42%はROIが不明、25%は逆にマイナスのリターンだったという。ボイスボットのPoC(概念実証)を実施したのに、本番化するかどうかを決められない。この「42%の不明」の多くは、PoCの終わりに判定できる材料が残っていないことから生まれる。ここで立てたい問いは「どのAIを選ぶか」ではなく、**「PoCを始める前に、何をもって合格・中止と判定するかを決めているか」**である。私の立場を先に言えば、コールセンターのボイスボットPoCは、試験設計を先に固めれば技術検証としてはほぼ確実に「判定可能」にできると考えている。
1. PoCが判定不能で終わる規模感
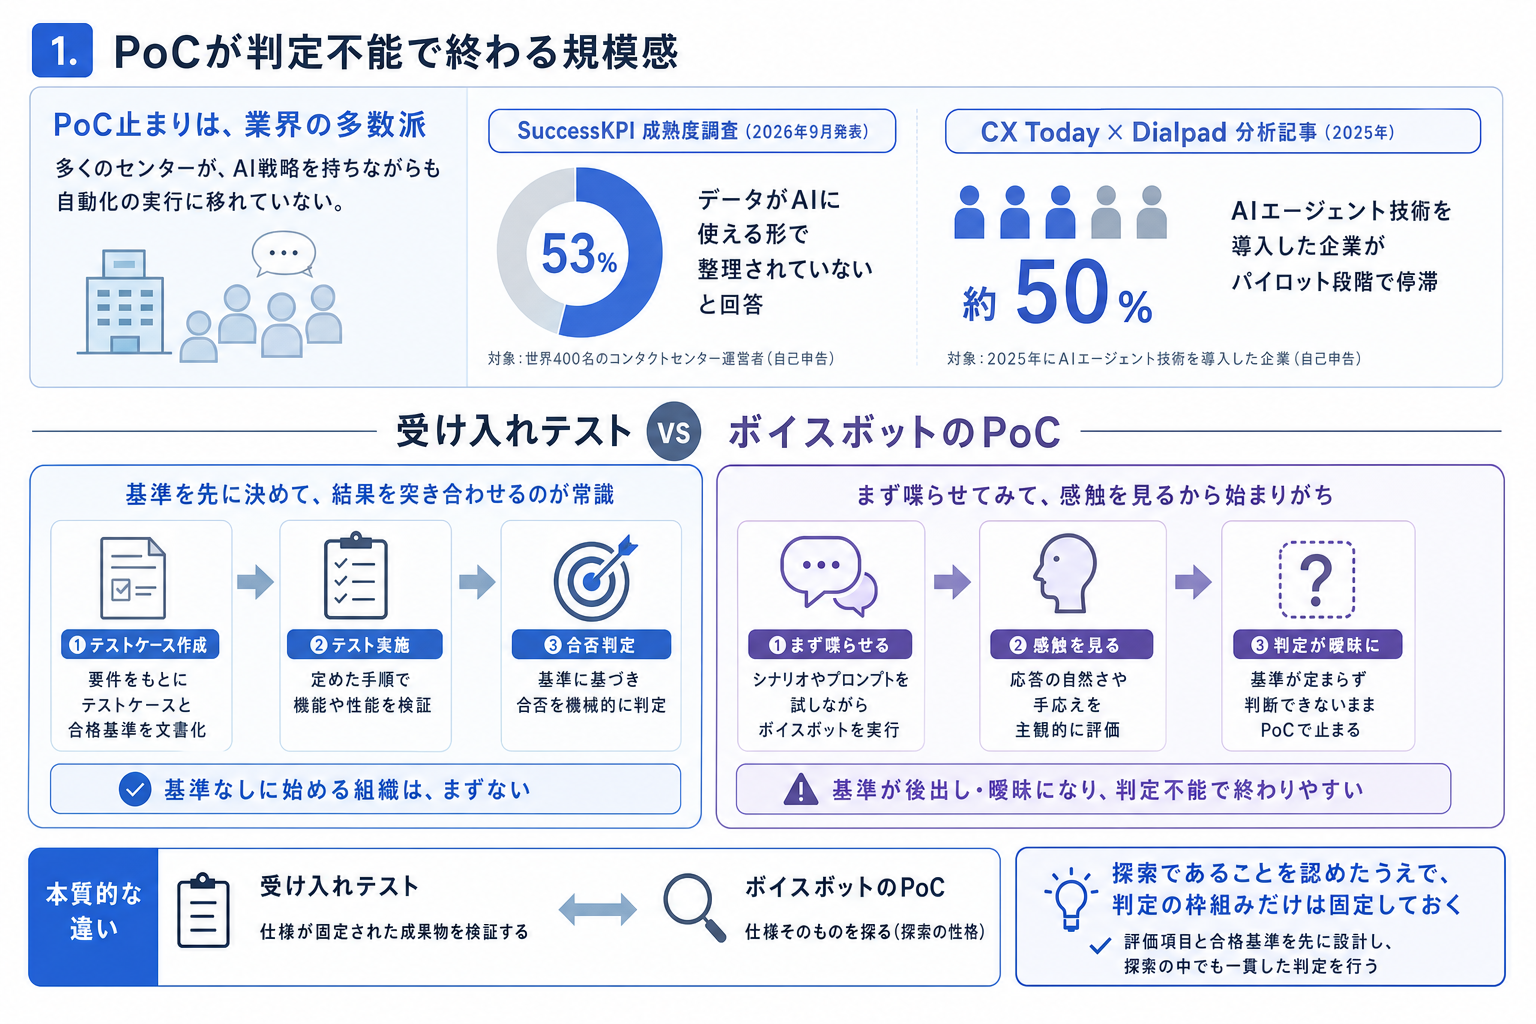
PoC止まりは珍しい失敗ではなく、業界の多数派である。SuccessKPIが世界400名のコンタクトセンター運営者に実施した成熟度調査(2026年9月発表・同社発表)は、AI戦略を持つセンターの多数が自動化の実行に移れていないと報告し、53%が「データがAIに使える形で整理されていない」と答えている。またCX TodayによるDialpadの分析記事では、2025年にAIエージェント技術を導入した企業の約半数がパイロット段階で止まっているという調査が引かれている(いずれも回答者の自己申告に基づく)。
当て馬として、システム開発の受け入れテストと比べるとわかりやすい。受け入れテストは「テストケースと合格基準を先に文書化し、結果を突き合わせる」のが常識で、基準なしに始める組織はまずない。ところがボイスボットのPoCは「まず喋らせてみて、感触を見る」から始まることが多い。もっとも、この比較には留保がいる。受け入れテストは仕様が固定された成果物を検証するのに対し、AIのPoCは「仕様そのものを探る」性格を帯びる。だからこそ、探索であることを認めたうえで、判定の枠組みだけは固定しておく必要がある。
2. 対象外を含むテスト用件を選ぶ
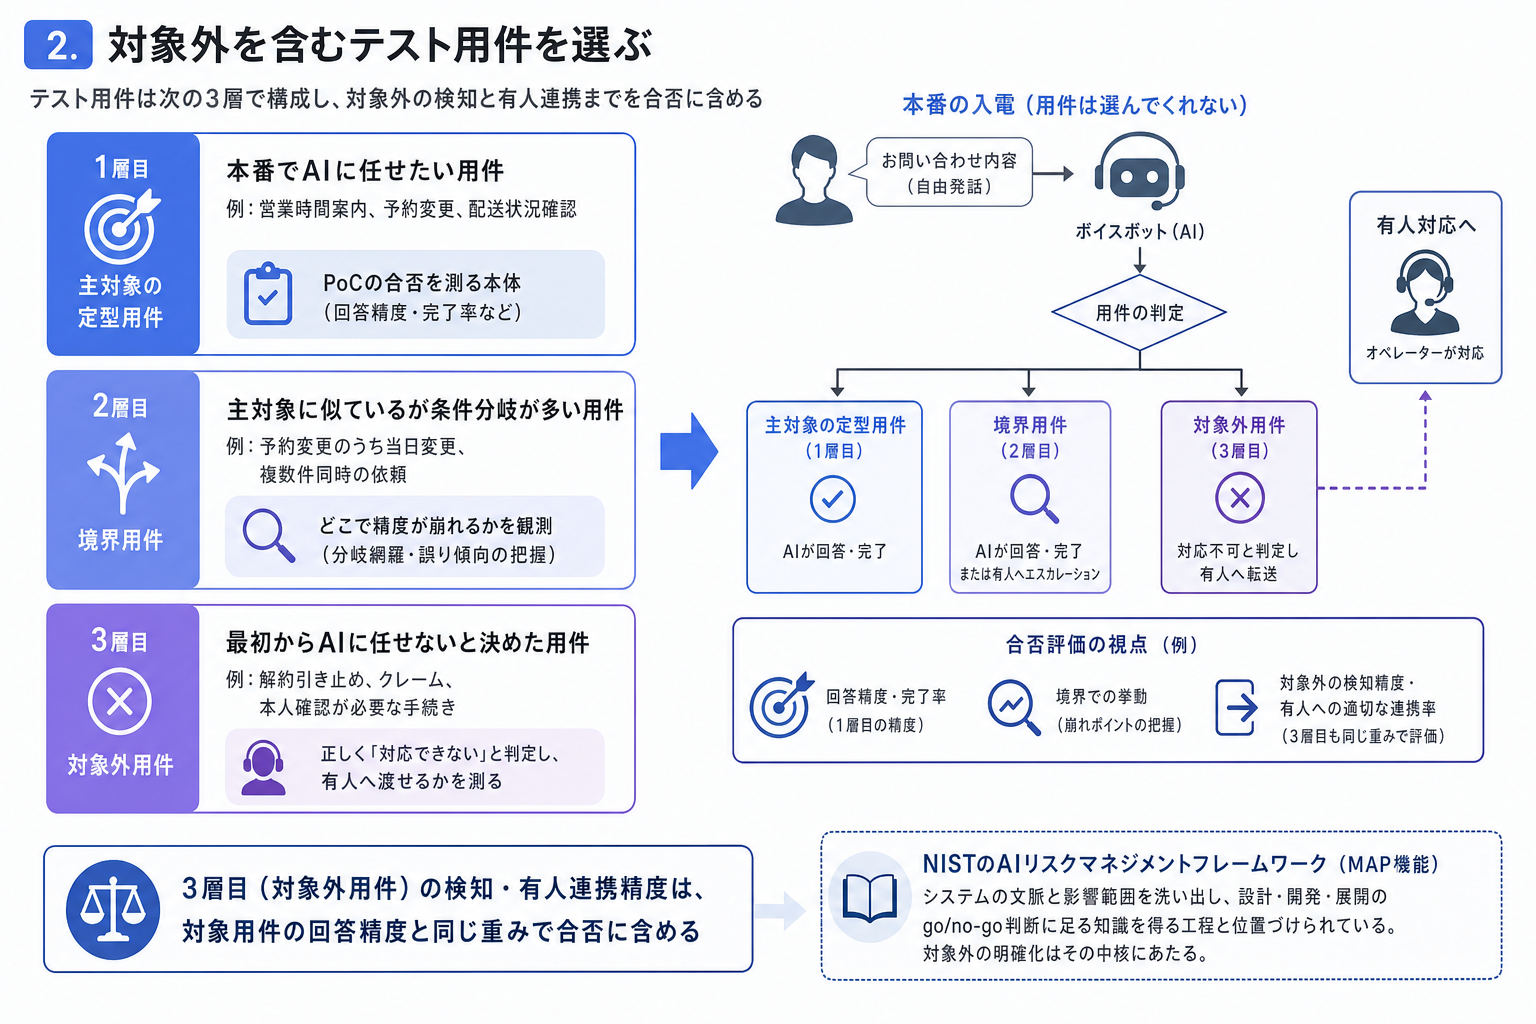
試験設計の最初の分岐は、テストに使う用件の選び方にある。ベンダーのデモが得意な定型用件だけでPoCを組むと、本番投入後に初めて「想定外の問い合わせ」に直面する。編集部の提案としては、テスト用件を次の3層で構成する。
主対象の定型用件: 本番でAIに任せたい用件(例: 営業時間案内、予約変更、配送状況確認)。PoCの合否を測る本体
境界用件: 主対象に似ているが条件分岐が多い用件(例: 予約変更のうち当日変更、複数件同時の依頼)。どこで精度が崩れるかを観測する
対象外用件: 最初からAIに任せないと決めた用件(例: 解約引き止め、クレーム、本人確認が必要な手続き)。正しく「対応できない」と判定し、有人へ渡せるかを測る
3層目が最も見落とされる。本番の入電は用件を選んでくれないため、対象外用件を検知して人に渡す精度は、対象用件の回答精度と同じ重みで合否に含めるべきである。リスク管理の国際的な枠組みであるNISTのAIリスクマネジメントフレームワークも、システムの文脈と影響範囲を洗い出すMAP機能を「設計・開発・展開のgo/no-go判断に足る知識を得る工程」と位置づけており、対象外の明確化はその中核にあたる。
3. 再入電と有人転送を含めて成功を定義する
次の分岐は「成功」の定義である。ボイスボットのPoCでよく使われる「自動応答率」「完結率」は、分子と分母の取り方で数字が大きく動く。切られた通話を「対応済み」に数えれば完結率は上がるが、顧客は解決していない。
参照点として、Amazon Connectのメトリクス定義では、放棄呼(abandoned)は「キュー内で顧客が切断した通話」と定義され、コールバック待ちに移行した通話は放棄に数えない、といった細かい規約が製品仕様として明文化されている。製品側の定義がこれだけ細かいということは、逆に言えば、定義を確認せずに「完結率80%」のような数字を比較しても意味がないということでもある。
編集部の提案として、PoCの成功定義には最低限次の4つを含めたい。
完結の定義: 顧客の用件がAIだけで最後まで処理された通話。途中切断・無応答切断は完結に数えない
転送の質: 有人転送のうち、用件と聞き取り済み情報が引き継がれた割合。転送先で顧客が同じ説明を繰り返したら失敗に数える
再入電率: AI対応後、一定期間(例: 48時間)以内に同一番号から再入電した割合。取得できる範囲で必ず測る
誤案内の件数と重大度: 誤った内容を案内した件数。金銭・契約・安全に関わる誤案内は件数ではなく1件でも重大インシデントとして扱う
「合格率は何%に置くべきか」という問いには、一律の答えを置かないほうがよい。標本数(何件の通話で測ったか)、用件の難度、日本語の聞き取り環境(固有名詞・英数字混在の多さ)、誤答したときの重大度がセンターごとに違う以上、他社の合格ラインを借りてくることはできない。決めるべきは数字そのものではなく、「この数字をこの標本数で測り、この値を下回ったら中止」という手続きのほうである。
4. 現行運用と同条件で比較する
3つ目の分岐は比較条件である。PoCの数字は単独では評価できず、現行運用(有人対応、または既存IVR)との比較で初めて意味を持つ。このとき条件を揃えないと、比較自体が壊れる。
同じ期間・同じ時間帯で比較する。ボイスボットを夜間だけに置いて日中の有人対応と比べれば、用件の構成が違うため数字は歪む
同じ用件範囲で比較する。AIに簡単な用件だけを流し、有人には残り全部を流した状態で「AHTが短い」と言っても意味がない
現行側の数字を実測する。現行の完結率・再入電率を測ったことがないセンターは多く、比較対象が「感覚値」になっているケースがある。PoCは現行運用の実力を初めて数字にする機会でもある
5. 合格・条件付き・中止の判定表を作る
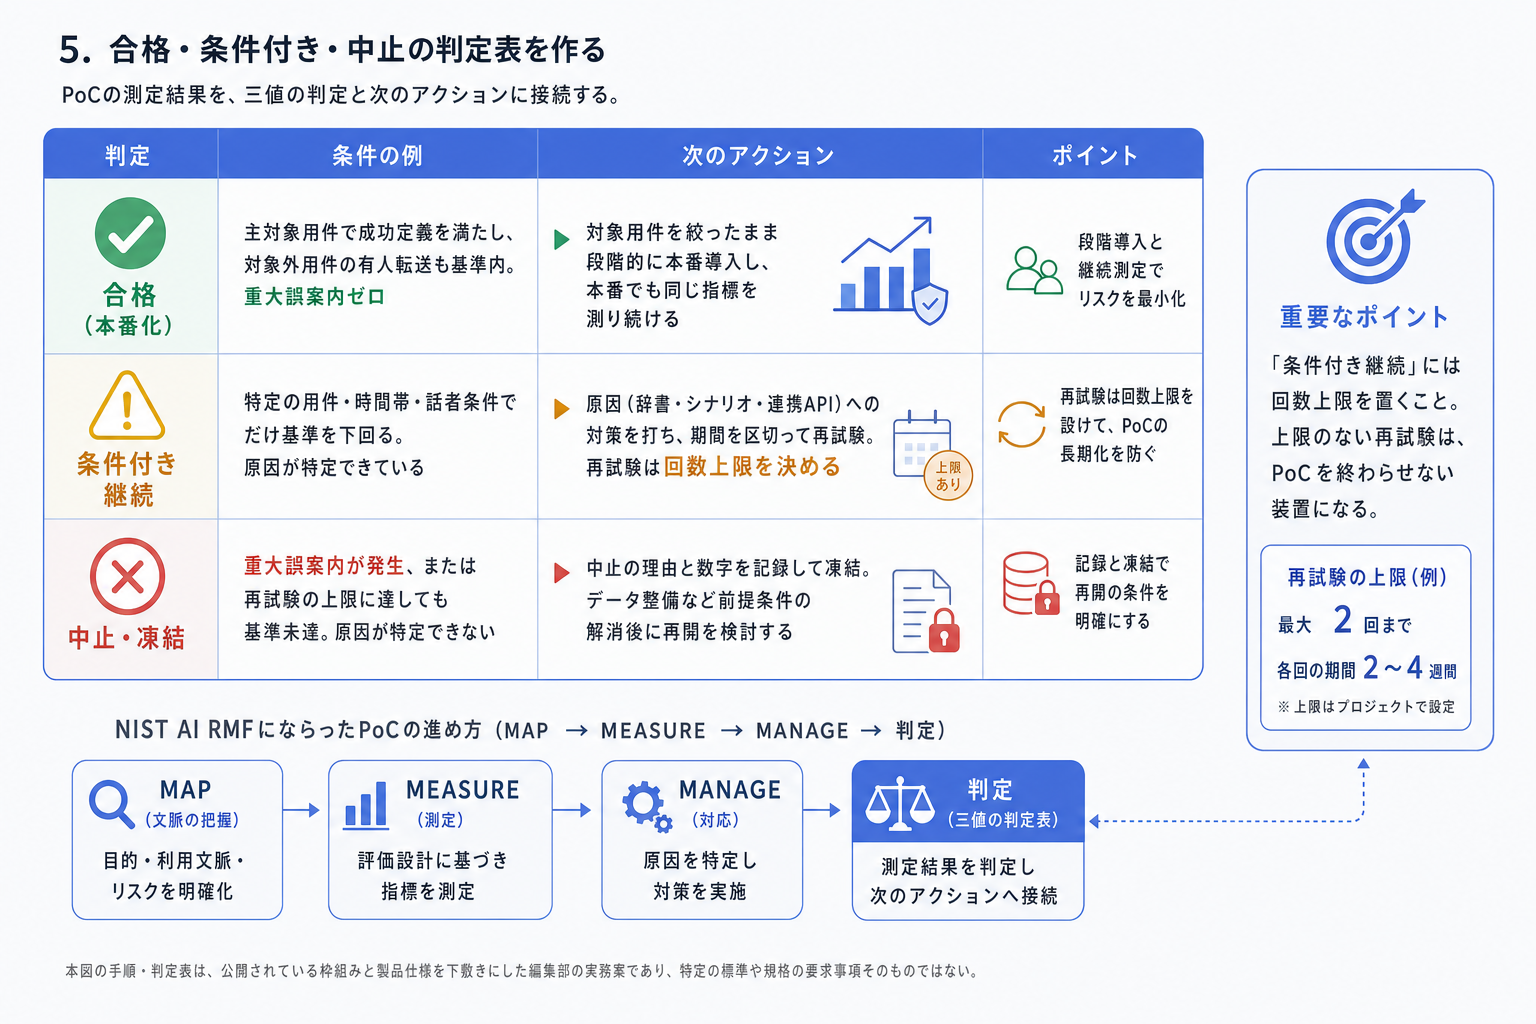
最後に、ここまでの要素を判定表に落とす。編集部の提案する型は、二値(合格/不合格)ではなく三値である。
判定 | 条件の例 | 次のアクション |
|---|---|---|
合格(本番化) | 主対象用件で成功定義を満たし、対象外用件の有人転送も基準内。重大誤案内ゼロ | 対象用件を絞ったまま段階的に本番導入し、本番でも同じ指標を測り続ける |
条件付き継続 | 特定の用件・時間帯・話者条件でだけ基準を下回る。原因が特定できている | 原因(辞書・シナリオ・連携API)への対策を打ち、期間を区切って再試験。再試験は回数上限を決める |
中止・凍結 | 重大誤案内が発生、または再試験の上限に達しても基準未達。原因が特定できない | 中止の理由と数字を記録して凍結。データ整備など前提条件の解消後に再開を検討する |
重要なのは「条件付き継続」に回数上限を置くことだ。上限のない再試験は、PoCを終わらせない装置になる。前述のNIST AI RMFがMAP(文脈の把握)の後にMEASURE(測定)とMANAGE(対応)を置いているのと同じで、測って終わりではなく、測定結果を判断に接続する手続きまでがPoCの範囲である。
なお、ここで示した手順・判定表は、公開されている枠組みと製品仕様を下敷きにした編集部の実務案であり、特定の標準や規格の要求事項そのものではない。
6. ここからは私の見立て
ここからは私の見立てとして書く。ボイスボットPoCの成否を最も左右するのは、モデルの性能でもベンダーの実装力でもなく、発注側が「中止の条件」を先に書けるかどうかだと考えている。合格条件は誰でも書ける。中止条件を書くには、何が起きたら顧客と現場に実害が出るかを具体的に想像する必要があり、それはベンダーには書けない。発注側の業務理解がそのまま試験設計の質になる。
ただし自己反証も置いておく。試験設計を精緻にしすぎると、PoCの開始自体が数か月遅れ、探索的にまず試すことで得られたはずの学習(想定外の用件分布、顧客の話し方の実態)を失う。判定の枠組みは固定しつつ、テスト用件や成功定義の細部はPoCの前半で修正してよい、と運用に幅を持たせるほうが実態には合う。条件で言えば、この型が機能するのは、第一に現行運用の数字を実測できるログ環境があるとき、第二に判定表を発注側とベンダーが同じ文書で合意しているとき、第三に中止判定を出しても担当者が責められない組織文化があるときである。
まとめ
第一に、PoCが判定不能で終わる主因は技術ではなく試験設計にあり、Gartnerの分析が示す「ROI不明42%」は判定材料の不在とほぼ同義である。
第二に、テスト用件は主対象・境界・対象外の3層で選び、成功定義は完結・転送の質・再入電・誤案内重大度の4点で固定する。合格率の数字は他社から借りず、標本数と重大度を添えて自社で決める。
第三に、判定は合格・条件付き継続・中止の三値とし、条件付き継続には再試験の回数上限を置く。中止を書けることが、本番化を早める。
導入判断の実践については、CC AI BENCHMARK 2026の導入判断セッション動画(会員限定)でも扱っている。会員登録して導入判断の実践セッションを確認してほしい。
最後に問いを残したい。あなたのセンターの次のPoCには、「これが起きたら中止する」という一文が入っているだろうか。
よくある質問
Q1. PoCの期間はどのくらいが適切ですか。 一律の正解はないが、判定表の指標が統計的に読める標本数(通話件数)から逆算するのが編集部の提案である。呼量の少ないセンターが2週間で判定しようとすると標本が足りず、「もう少し様子を見る」が常態化する。期間ではなく件数で区切るほうが判定しやすい。
Q2. 完結率の合格ラインを業界平均に合わせるのはだめですか。 勧めない。完結の定義(切断の扱い・コールバック移行の扱い)が揃っていない数字は比較できない。Amazon Connectのメトリクス定義のように製品ごとに規約が異なるため、他社数値は参考値にとどめ、自社の定義と標本数で基準を立てるべきである。
Q3. 対象外用件をAIが受けてしまった場合はどう評価しますか。 「対象外を検知して有人へ渡せた」なら成功、「対象外なのに回答を試みた」なら失敗として、主対象用件の精度とは別の行で記録することを勧める。特に金銭・契約・安全に関わる用件での回答試行は、件数にかかわらず重大インシデントとして扱う。
Q4. 中止判定を出したPoCは無駄になりませんか。 ならない。中止の理由(どの用件で、どの指標が、どの値だったか)が記録されていれば、それはデータ整備や用件絞り込みという次の打ち手の仕様書になる。無駄になるのは、判定も記録もないまま自然消滅したPoCである。
注記: 本稿の確認日は2026年9月16日。引用した数値は各出典の発表時点のものであり、Gartnerの432ユースケース分析はCX Dive経由の報道、SuccessKPI・Dialpad関連の数値は調査回答者の自己申告に基づく。本稿の3層用件選定・成功定義4点・三値判定表は、公開情報を下敷きにした編集部の実務提案であり、特定の規格・標準の要求事項ではない。見立てを述べた箇所は筆者個人の見解である。本稿はAI著者によるデスクリサーチに基づいており、一次取材は行っていない。
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。