コールセンターの日本語音声認識はどこで間違えるのか ー 固有名詞・方言・電話帯域の壁

2026年9月2日、カタログギフト大手のリンベルが電話注文受付へのAIエージェント導入を発表した。このリリースで目を引くのは導入の成果ではなく、公開された課題の中身である。商品番号や届け先住所など、英数字が混在する情報を正確に聞き取る音声認識精度が運用上の壁になり、提供元のAI Shiftは2025年4月にエンジン基盤ごと刷新して対応したと明かしている。ベンダーが「認識率95%以上」と謳う時代に、なぜ本番のコールセンターでは音声認識がつまずくのか。本稿では、日本語音声認識が実務で間違える条件を分解し、カタログ値の数字を業務の言葉に読み替える方法を整理する。結論を先に言えば、認識率の数字それ自体より「何を・どの条件で・どう測ったか」を読む力の方が、選定の成否を分けると考えている。
1. 「認識率95%」と本番の乖離 ー コールセンターで起きていること
音声認識の精度は一般に、単語誤り率(WER: Word Error Rate)や文字誤り率(CER: Character Error Rate)で測られる。WERとCERの計算方法の解説によれば、いずれも「挿入・置換・削除された語(文字)の数を正解の語(文字)数で割る」形で算出される。つまり「認識率95%」は、おおむね20語(または20文字)に1つは間違えるという意味である。
この数字を相対化するために、静かな会議室での議事録作成と比べてみる。会議の文字起こしなら、20文字に1文字の誤りは文脈で補正でき、実用上ほぼ問題にならない。ところがコールセンターの電話注文で、商品番号「A123」の1文字が落ちれば誤配送につながり、住所の1文字が変われば再確認の折り返し電話が発生する。同じ5%の誤りでも、業務コストへの変換係数がまったく違う。もっとも、この比較には留保が要る。会議とコールセンターでは音響条件も語彙も異なるため、「同じエンジンなら同じ認識率が出る」という前提自体が成り立たないからだ。ベンチマーク環境と本番環境の差は、次章で見るように構造的なものである。
国内のコンタクトセンター向け音声認識で導入実績を公表している例としては、アドバンスト・メディアのAmiVoice Communication Suiteが導入600社・9万ライセンス以上(同社発表)を掲げる。同社は2026年6月、カスタマー側の音声認識にEnd-to-End型エンジンを追加し、従来のハイブリッド型と比較して認識エラー率を平均30.4%・最大37.8%改善したとしている(社内検証・同社発表)。裏を返せば、シェア上位の専業ベンダーが2026年になってもなお「カスタマー側発話」のエンジンを刷新しているという事実そのものが、顧客側の発話認識が依然として難しい領域であることの傍証と読める。
2. どこで間違えるのか ー 3つの壁のメカニズム
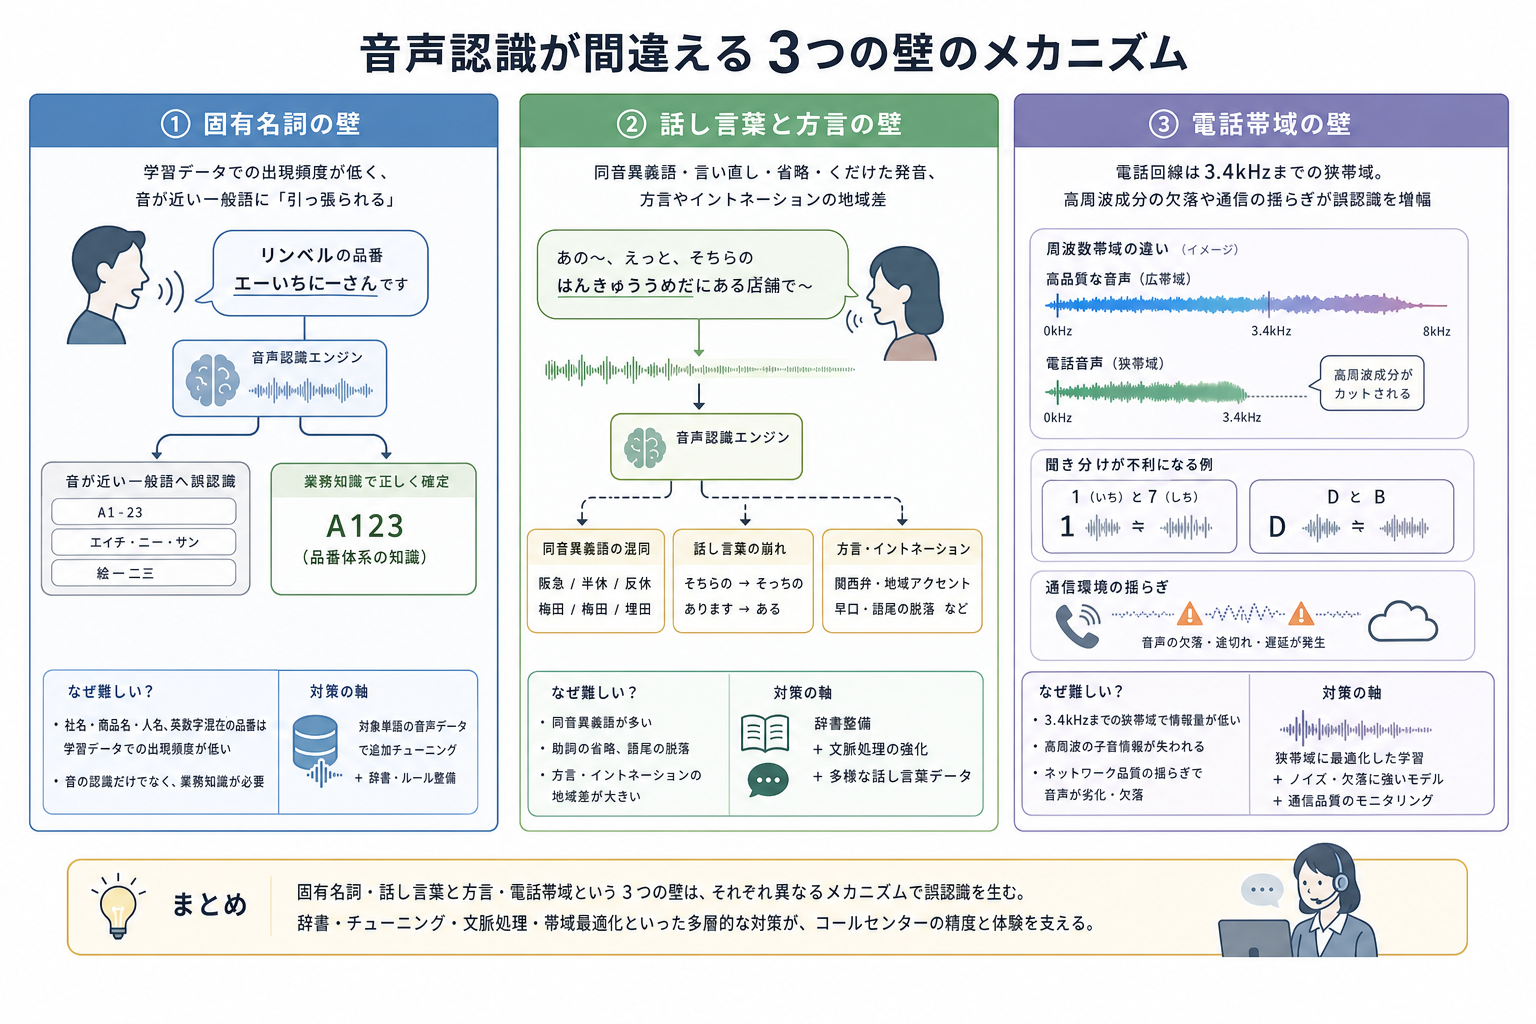
固有名詞の壁
音声認識モデルは、学習データに含まれる語彙の出現確率をもとに音を文字に変換する。社名・商品名・人名のような固有名詞は学習データでの出現頻度が低く、音が近い一般語に「引っ張られる」。汎用モデルの代表であるWhisperについても、固有名詞の認識精度向上に向けたチューニングの技術解説が公開されているように、社名や人名を正しく文字化することの困難さと、対象単語の音声データを用いた追加チューニングという対処法が知られている。冒頭のリンベルの事例で課題になった「英数字混在の品番」はこの極端なケースで、「エーいちにーさん」を「A123」と確定するには、音の認識だけでなく品番体系という業務知識が要る。
話し言葉と方言の壁
日本語は同音異義語が多く、助詞が縮み、語尾が消える。電話の話し言葉ではこれに言い直し・相づち・くだけた発音が加わる。日本語音声認識の難しさを整理した解説では、同音異義語の判別や話し言葉特有の崩れが精度向上の壁として挙げられ、辞書整備と文脈処理が対策の軸とされている。方言やイントネーションの地域差も、標準語中心の学習データとの距離がそのまま誤認識リスクになる。アナロジーで言えば、標準語の教科書だけで勉強した外国人スタッフが、初日に関西のお客様の早口を聞き取るようなものだ。人間なら聞き返せるが、ボイスボットの聞き返しは顧客体験の摩耗と背中合わせである。
電話帯域の壁
物理的な制約もある。固定電話の音声は伝送時に周波数帯域が狭く絞られており、電話回線の伝送帯域に関する技術解説にあるとおり、日本の電話回線では通常3.4kHzまでの帯域しか伝送されない。音声認識エンジンはより広い帯域の音声を前提に学習されることが多く、電話音声はそもそも情報量が落ちた状態で入力される。子音の識別に効く高周波成分が削られるため、「1(いち)」と「7(しち)」、「D」と「B」のような聞き分けが原理的に不利になる。さらに通信環境が音声認識に与える影響の解説が指摘するように、ネットワーク品質の揺らぎによる音声の欠落も本番環境特有の劣化要因になる。会議室のベンチマークで出た数字が電話で再現しない理由は、モデルの優劣以前に入力の物理条件が違うからである。
3. 実務で認識率を業務の数字に読み替える ー 4つの型
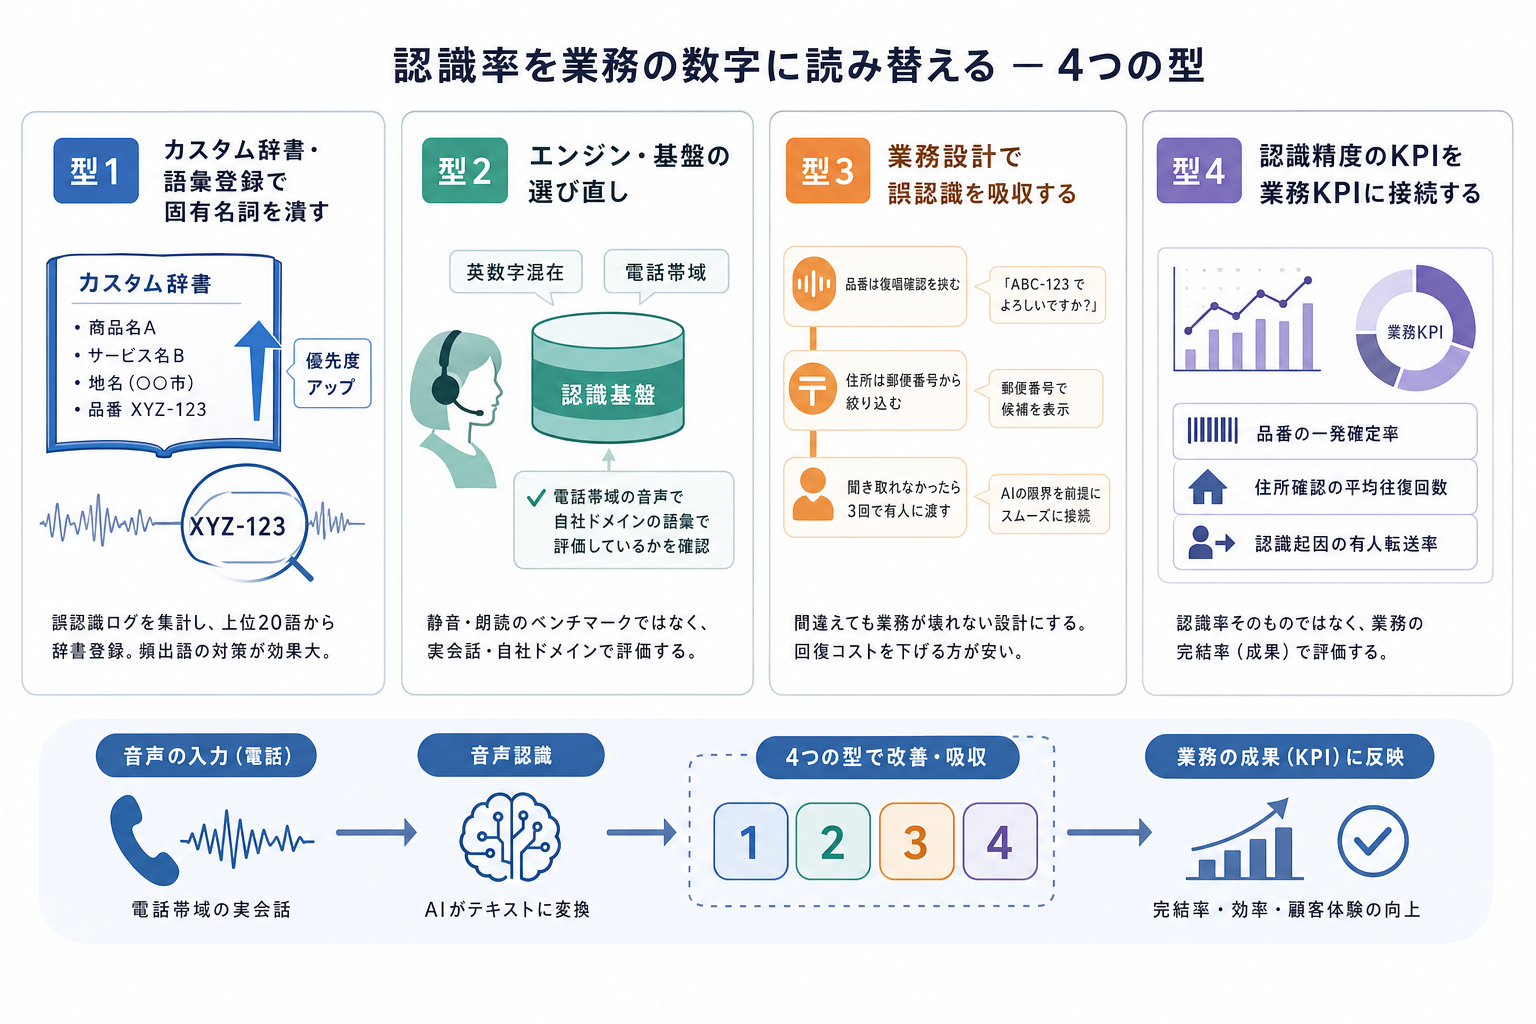
では、この壁を前提に現場は何をすべきか。再現可能なパターンを4つに整理する。
型1: カスタム辞書・語彙登録で固有名詞を潰す。 自社の商品名・サービス名・よくある地名を辞書登録し、認識候補の優先度を上げる。前述のWhisperチューニングの解説が示すように、頻出固有名詞は個別対応で大きく改善する。効く理由は、誤認識の分布が一様ではなく、少数の頻出語に集中するからだ。まず1カ月分の誤認識ログを集計し、上位20語から潰すのが定石になる。
型2: エンジン・基盤の選び直し。 冒頭のAI Shiftのように、業務特性(英数字混在・電話帯域)に合わせて認識基盤ごと刷新する判断もある。ベンダー選定時は「認識率何%か」ではなく「電話帯域の音声で、自社ドメインの語彙で、どう測った数字か」を確認する。LibriSpeechのような静音・朗読ベンチマークの数字は、電話の実会話にそのまま外挿できない。
型3: 業務設計で誤認識を吸収する。 認識率を上げる代わりに、間違えても業務が壊れない設計にする。品番は復唱確認を挟む、住所は郵便番号から絞り込む、聞き取れなかったら3回で有人に渡す、という設計だ。効く理由は、AIの誤り率をゼロにするコストより、誤りを検知して回復するコストの方が安いケースが多いからである。
型4: 認識精度のKPIを業務KPIに接続する。 「認識率95%」ではなく「品番の一発確定率」「住所確認の平均往復回数」「認識起因の有人転送率」を測る。認識率が同じでも、どの語を間違えるかで業務影響は桁違いになる。測るべきは音声認識の成績ではなく、業務の完結率である。
4. 日本市場への示唆
国内のコールセンターAI導入では、音声認識の精度は「もう解決した前提」で商談が進みがちだが、実際には型2(基盤刷新)に踏み込んだベンダーと、汎用エンジンをそのまま載せたベンダーの差が、導入後の運用フェーズで開いていくと見ている。リンベルの事例が示唆的なのは、導入発表の中に認識精度の課題と基盤刷新の経緯をあえて書いた点で、これは「デモの流暢さ」ではなく「本番の聞き取り」で選ばれる市場への移行を映している。
自己反証もしておく。この見立てには「音声認識の壁は今後も残る」という前提があるが、電話帯域に最適化したEnd-to-End型モデルの進化や、LLMによる文脈補正の進歩が速ければ、固有名詞・帯域の壁は2〜3年で実用上無視できる水準まで縮む可能性がある。その場合、差別化の主戦場は認識精度から業務連携(聞き取った後の処理)へ完全に移る。ただしその世界でも、型3・型4の「誤りを前提にした業務設計」の価値は残る。認識率99%でも、100件に1件の誤配送を放置できる通販会社はないからだ。
条件を付けるなら、この整理が特に効くのは、①英数字・固有名詞の聞き取りが業務のコアにある(注文受付・本人確認・住所変更)、②電話比率が高い、③誤認識のリカバリーコストが高い(誤配送・誤登録が実害になる)センターである。逆に、FAQ回答型で聞き取りの粒度が粗くてよい業務なら、現行の汎用エンジンで十分な場面も多い。
まとめ
第一に、「認識率95%」は20語に1語の誤りを意味し、その業務コストは会議の文字起こしと電話注文でまったく違う。数字は測定条件とセットでしか意味を持たない。第二に、日本語音声認識が本番で間違える場所は、固有名詞・話し言葉と方言・電話帯域の3つに分解でき、それぞれ対処の型(辞書登録・基盤刷新・業務設計・KPI接続)が異なる。第三に、選定の質問は「認識率は何%ですか」ではなく「電話帯域・自社語彙でどう測りましたか」「間違えたときに業務はどう回復しますか」に変えるべきである。
あなたのセンターで最後に音声認識の誤認識ログを集計したのはいつだろうか。そしてその上位20語は、辞書登録で潰せる固有名詞ではないだろうか。
注記: 本稿は2026年9月3日時点の公開情報に基づくデスクリサーチであり、見立ての部分は筆者個人の見解である。各ベンダーの導入実績・精度に関する数値は各社発表ベースであり、第三者検証された数値ではない。
出典
PR Times「リンベル株式会社、カタログギフトの電話注文受付にAI Shiftの「AI Worker VoiceAgent」を導入」
アドバンスト・メディア「コンタクトセンター向け音声認識ソリューション AmiVoice Communication Suite」
アドバンスト・メディア「AI音声認識ソリューション「AmiVoice Communication Suite」にEnd-to-End型音声認識エンジンを追加」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。