顧客がAIを信用する条件は「賢さ」より「人に代われること」か ー 2つの調査で読む有人転送・AI開示・評価指標の設計
2026年9月10日、AIエージェント「Fin」を提供するFin社(旧Intercom)が、エンドユーザー向けの意識調査「The 2026 AI Sentiment Report」を発表しました。AIエージェントとのやり取りをどう感じ、どこまで信頼しているかを尋ねた調査で、AIを信頼しやすくなる条件として回答者が選んだ上位2つは「必要なときに人へ簡単にエスカレーションできること」と「AIとやり取りしていることを最初に告げられること」でした。同じ日、SalesforceはFinの買収完了を発表しています。
その前日の9月9日には、IBIMA Publishingが発行するJournal of Marketing Research and Case Studiesに、チャットボットと人の応対を比べた定量調査の論文が掲載されました。チャットボットは顧客の手間(顧客努力)を減らすが、解決品質と信頼では人が上回る、という結果です。
当ラボは8月の対話記事で、顧客のAI受容は世代よりも用件の性質で分かれ、「人に切り替えられる保証」へのこだわりが国内外で共通していると整理しました。立てたい問いは、顧客は何があればAIを信用するのか、です。
私の仮説はこうです。回答の精度を上げるだけでは信頼は伸びにくく、「人に代われる」「AIだと分かっている」「誰かが責任を持つ」という、うまくいかなかったときの設計が効いているのかもしれない。ただし、2本ともこの因果を示したものではありません。一方はAIエージェントのベンダーによる調査、もう一方は回答者を意図して選んだ調査です。どちらも消費者心理を考える材料として扱い、断定はしません。
この記事の要点
①Finの調査で、回答者は複雑な用件ほどAIを信頼しにくく、懸念は回答の正確さより「どう解決するか」に向き、信頼しない理由は「責任を取るか」「例外を判断できるか」の2つだった。信頼の条件の上位2つは人への切り替えやすさとAIであることの明示
②論文では、チャットボットは顧客努力が有意に低く、人は解決品質と信頼で有意に高かった。満足度とロイヤルティ意向には有意差が出ていない
③AHTや自動化率は手間の側しか測らない。顧客努力・解決品質・信頼を並べて見るKPIセットと、人への導線の実測が要る
1. 数字を、性質ごとに読み分ける
2本の数字を、調査主体の表記と読み手が置く留保に分けて並べます。
数値(原文表記) | 調査主体・母集団・設問 | 読み手が置く留保 |
|---|---|---|
肯定的な体験 「Forty-nine percent」、2025年から「nine percentage points」上昇 | Fin、エンドユーザー1,026人。AIとの全体的な体験を肯定的と表現した人 | 調査国・実施時期・実施会社・設問文は公開ページに記載がない。前年調査と母集団・設問が同じかも確認できない |
動画視聴後の肯定 74% | Finのブログ・レポートページ。調査の途中で、AIエージェントが実際の問い合わせを解決する短い動画を見せ、同じ質問をもう一度尋ねた | 本人の実体験ではなく、ベンダーが用意した解決場面の映像への反応。対照群の有無は記載がない |
定型なら任せる 54% | Finのブログ・レポートページ。簡単・定型の用件ならAIを信頼するが、複雑な用件はしない | 「複雑」の中身は回答者に委ねられている |
AIが有能になった 61% | Finのレポートページ。過去1年でAIが企業とのやり取りでより有能になったと答えた人 | 能力の認知であり、実際の解決率ではない |
顧客努力 t(188) = -5.99 | 論文。有効回答291件のうち、チャットボットを評価した群と人を評価した群の比較 | 過去の体験の自己評価。同じ用件を両方で試した比較ではない |
解決品質 t(188) = -2.48、信頼 t(188) = -4.55 | 同論文。いずれも人の方が高い | 満足度・ロイヤルティ意向・総合バランスは有意差なし。相関分析の結果も因果は示さない |
留保で最も重いのは2行目です。動画を見たあとの74%は、回答者が自分でAIを使った結果ではありません。ベンダーが選んだ解決場面の映像を見た直後の反応です。映像を見せた後に同じ質問をすると肯定が増えたことは示していますが(対照群の記載はなく、再質問そのものの影響とは切り分けられません)、実際のセンターでAIに応対された顧客が同じように評価を上げるかは、この調査からは分かりません。
なお、「信頼は設計で獲得できる」という同社の結論が、AIエージェントを販売する立場と同じ方向を向いていることも前提に置きます。
2. 2本の結果を並べる。論文では手間はAI、解決品質と信頼は人
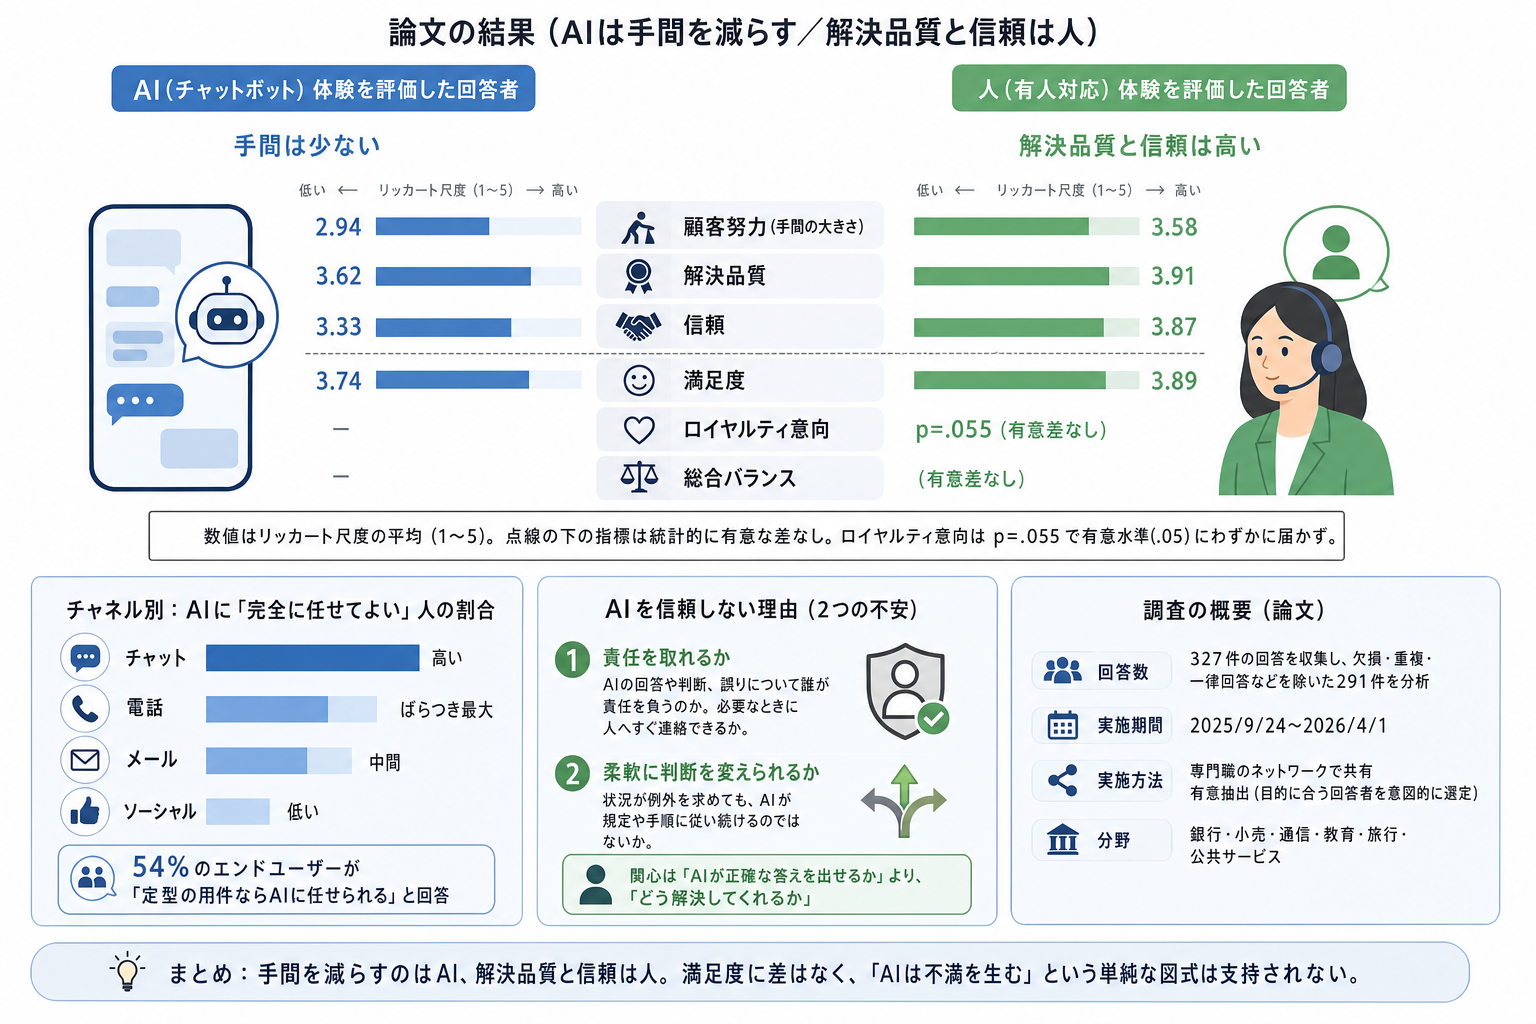
Finのレポートページによると、54%のエンドユーザーが定型の用件ならAIに任せられると答えています。ブログは、同じ54%を「簡単・定型の用件なら任せるが、複雑な用件は任せない」層と説明しています。「複雑」の中身として同社は、人のように裁量を利かせられるか、渡した個人情報がどうなるか、何回かに分かれたやり取りの中で自分が伝えたことをすべて覚えていられるか、という懸念を挙げ、回答者はAIが正確な答えを出せるかどうかよりも、どのように問題を解決するかを気にしている、と書いています。
AIを信頼しない理由は、同社によると2つに分かれます。1つは、AIが自分の行動に責任を取れるか。回答や判断や誤りについてAIが誰かに対して責任を負っていること、必要なら人にすぐ連絡できることへの安心を求めている、とあります。もう1つは、人のように判断を柔軟に変えられるか。状況が例外を求めていても、AIは規定と手順に従い続けるのではないか、という懸念です。
チャネル別では、AIに完全に任せてよいと考える人が最も多いのはチャット、最も少ないのはソーシャルで、電話は評価が最も割れたとしています。
論文の側に移ります。論文によると、著者はラトビアのRISEBA応用科学大学と米国アイオワ州のGraceland Universityに所属する研究者で、Qualtricsのオンライン調査で327件の回答を集め、欠損・重複・一律回答などを除いた291件を分析しています。実施期間は2025年9月24日から2026年4月1日、調査票は専門職のネットワークで共有されました。回答者は銀行・小売・通信・教育・旅行・公共サービスの各分野から集められたと書かれていますが、利用者としてか従事者としてかは本文から判別できません。抽出は有意抽出(目的に合う回答者を意図して選ぶ方法)です。回答者の国は本文に書かれていません。
結果の中心は群間比較です。チャットボットの体験を評価した回答者は、人の体験を評価した回答者より顧客努力が有意に低く(リッカート尺度の平均でチャットボット2.94、人3.58。数値が高いほど手間が大きい)、解決品質(3.62と3.91)と信頼(3.33と3.87)は人の方が有意に高くなりました。一方で満足度(3.74と3.89)とロイヤルティ意向、総合的な努力と成果のバランスには、統計的に有意な差が出ていません。ロイヤルティ意向はp=.055で、有意水準(.05)にわずかに届きませんでした。
相関分析では、顧客努力が高いほど解決品質・満足度・信頼・ロイヤルティ意向が低いという負の関係が、すべて有意に出ています。論文によると、総合バランスを目的変数にした重回帰分析では、満足度・信頼・解決品質・ロイヤルティ意向・顧客努力の5つで分散の76%を説明し、係数が最も大きかったのは満足度、次が信頼でした。
読むときの注意が2つあります。第一に、論文の要旨と考察にある「ハイブリッド型が全体として最も強いバランスをもたらすようだ」という主張は、直接の検定結果ではありません。回答者の34.7%はハイブリッド型の体験を評価していますが、群間比較はチャットボットと人の2群で行われており、著者はこの仮説を「結果の全体的な傾向を通じて、概念的にも実証的にも」支持されたと書いています。第二に、論文には独立した限界の節がありません。過去の体験の自己評価であること、実際のセンターでの無作為化実験ではないこと、専門職ネットワーク経由の有意抽出で、回答者の学歴が学士38.5%・修士34.7%と高学歴寄りであること(著者も「relatively well-educated」と記述)は、手法の記述から読み取れる制約です。加えて、掲載元のIBIMA Publishingは、オープンアクセス出版社の質を問う非公式の一覧(Beall's List)のうち、2016年までに作られた原リストに名前が挙がっている出版社で、査読の水準は本記事では確認できていません。
論文では、手間を減らすのはAI、解決品質と信頼は人という分担が出ました。Finの調査の「定型ならAIに任せるが、複雑な用件は任せない」という受け止めとも、方向は重なります。ただし満足度で差が出ていない点は、「AIは不満を生む」という単純な図式も支持していません。
3. 信頼の設計要素を分解する
Finが挙げた条件と懸念を、センターが設計できる要素に分けて、論文と当ラボの既往記事の枠組みに当てます。
設計要素 | Finの原文が示す懸念・条件 | 論文の記述 | 設計の論点 |
|---|---|---|---|
人への切り替えやすさ | 「easy escalation to a human when needed」 | 文献レビューで、説明の繰り返しや人にたどり着けないことが顧客努力を増やすと整理 | 導線の段数、文脈の引き継ぎ、待ちの二重化 |
AIであることの明示 | 「being told upfront」 | 透明性が信頼を支えるという先行研究を引用 | 冒頭の一文、切り替え時の名乗り直し |
責任の所在 | 回答・判断・誤りについて誰かが責任を負っていること | 扱っていない | 誤案内の訂正窓口、記録の保全 |
例外判断 | 状況が例外を求めても規定に従い続けるのではないか | 複雑で感情的な場面は人が強い | 例外が要る用件の振り分け基準 |
切り替えやすさについて、当ラボは9月にAIから人へ渡す設計を、判定の先出し・文脈の同送・待ちの二重化の禁止・経路の可視化の4つの型に分けました。Finの調査は、その導線が顧客にとって信頼の前提条件になっている可能性を示しています。
明示については、当ラボの開示をめぐる対話で、冒頭で名乗り、人へ切り替わる瞬間に名乗り直す設計を論じました。国内では、総務省・経済産業省のAI事業者ガイドライン(第1.2版)が、AI提供者が平易かつアクセスしやすい形で情報提供する事項の例として「AIを利用しているという事実、活用している範囲、適切/不適切な使用方法等」を挙げています。罰則を伴う法律ではなく、事業者の取り組みの指針です。
責任の所在と例外判断は、精度の問題ではありません。正確に答えるAIでも、返金の例外を求められて「規定ではできません」と返し続ければ、顧客はその先に人がいるかを確かめたくなります。
もう一つ、Finの料金ページの定義も参考になります。同社は課金対象の成果として、解決(最後の回答のあとにそれ以上の助けが求められなかった場合)と並べて、設定した手順どおりに人へ引き継いだ場合を挙げ、成果のないまま担当者に回っただけの会話は課金しないとしています。人への引き継ぎを失敗としてだけ扱わず、条件を満たせば成果の一つとして数える設計と読めます。
4. 評価指標をどう組み直すか
ここからは当ラボの解釈です。
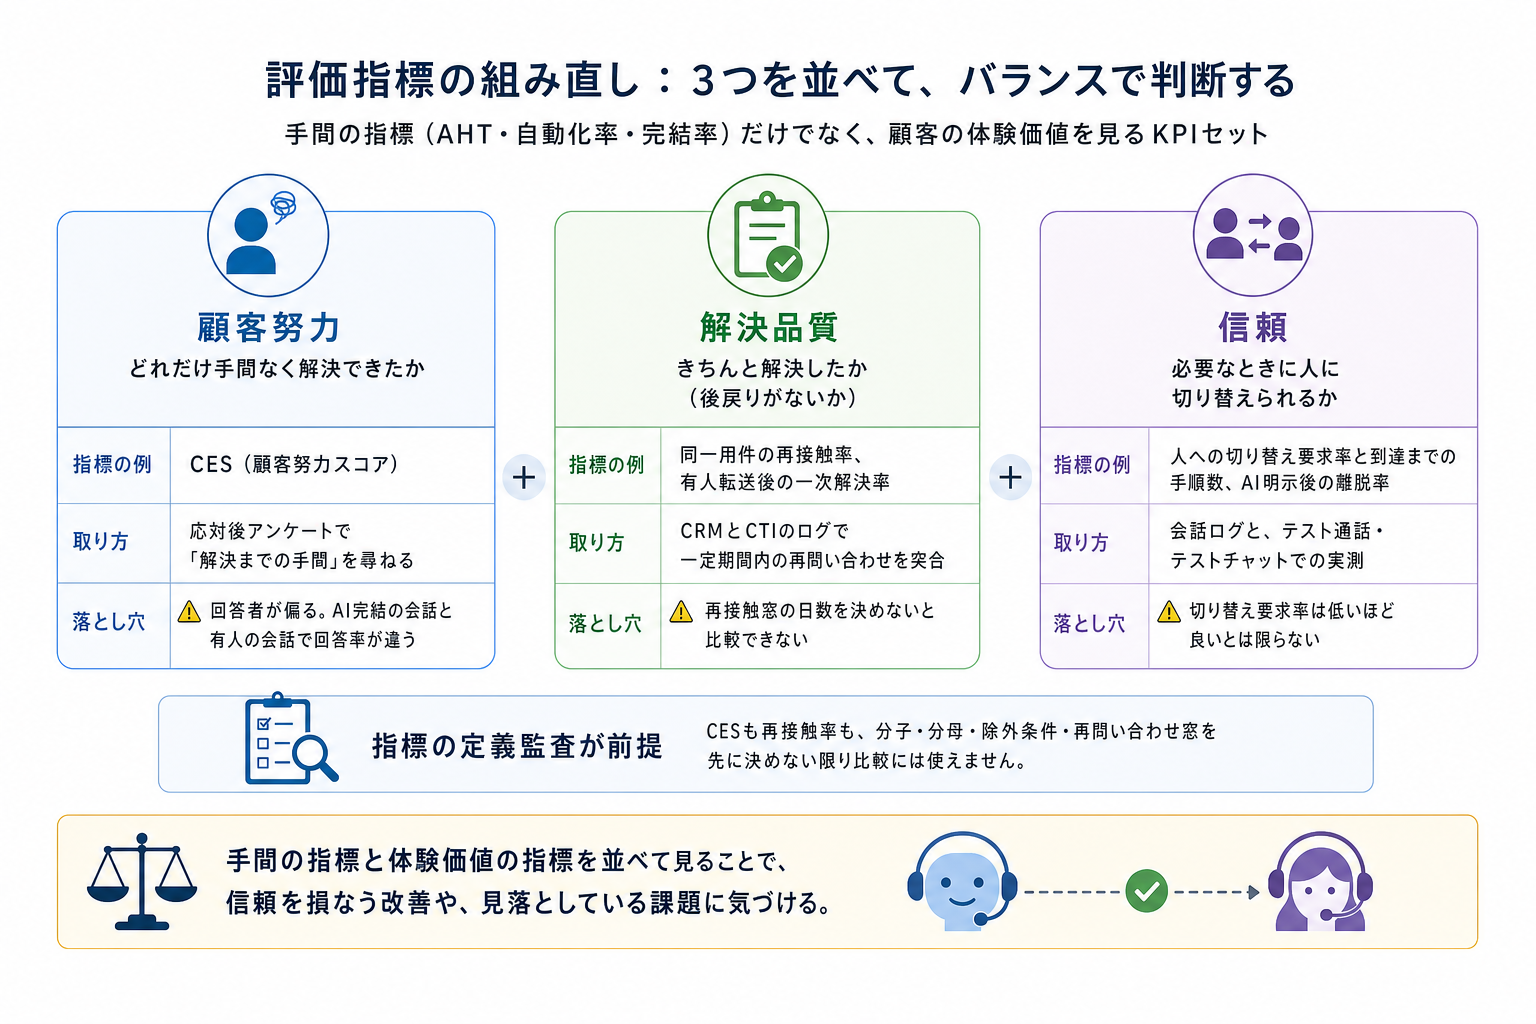
AHT(平均処理時間)や自動化率・完結率は手間の側の指標です。論文の回帰で総合的な評価を説明したのは、顧客努力だけでなく満足度・信頼・解決品質でした。手間の指標だけで改善を判断すると、信頼の側で起きている変化を見落とすおそれがあります。
そこで、次の3つを並べるKPIセットを考えます。
測りたいもの | 指標の例 | 取り方 | 落とし穴 |
|---|---|---|---|
顧客努力 | CES(顧客努力スコア) | 応対後アンケートで「解決までの手間」を尋ねる | 回答者が偏る。AI完結の会話と有人の会話で回答率が違う |
解決品質 | 同一用件の再接触率、有人転送後の一次解決率 | CRMとCTIのログで一定期間内の再問い合わせを突合 | 再接触窓の日数を決めないと比較できない |
信頼 | 人への切り替え要求率と到達までの手順数、AI明示後の離脱率 | 会話ログと、テスト通話・テストチャットでの実測 | 切り替え要求率は低いほど良いとは限らない |
当ラボの指標の定義監査で整理したとおり、CESも再接触率も、分子・分母・除外条件・再問い合わせ窓を先に決めない限り比較には使えません。
自己反証を2つ置きます。
第一に、人への切り替えを簡単にすれば、AIの完結率は下がり、コスト削減の効果は薄れます。定型の用件でも人を呼ぶ顧客が増えれば、有人の負荷はむしろ増えるかもしれません。実際に何が起きるかは今回の2本からは分からず、センターごとの試行で確かめるしかありません。
第二に、信頼は設計ではなく慣れで上がるのかもしれません。Finのブログ自身が、人はAIを使うほど受け入れるようになるが、単に触れた回数で築かれた受容は受け身のものだと書いています。動画を見ただけで肯定が74%に上がったことも、慣れや露出の効果の大きさを示すと読めます。そうであれば、設計より時間の経過の方が効くことになります。私は、慣れで上がった受容は最初の失敗で崩れやすいと見ていますが、それを検証したデータは今回の2本にはありません。
5. SV・センター長への示唆
AIエージェントの導入や見直しで、精度の議論の前に確かめたいことを4点挙げます。
第一に、人にたどり着くまでの段数を実測する。 テストチャット・テスト通話で、AIの一次受けから担当者に代わるまでに、顧客が何回操作し、何回同じことを言わされるかを、顧客側の画面と音声で数える。
第二に、冒頭の開示文言に「代われること」を入れる。 「AIがご案内します」だけでなく、担当者に代われる方法を最初の一文か二文で伝える。Finの調査で上位2つに並んだ条件を一度に満たせます。
第三に、例外が要る用件をAIに抱えさせない振り分け基準を持つ。 返金の例外、規約外の配慮、複数の用件が絡む相談など、規定どおりに答えると不満が残る用件を洗い出し、入口で人に回すか、AIが例外申請を人に渡す手順を明文化する。
第四に、AHT・自動化率の隣にCES・再接触率・切り替え指標を置く。 月次レポートで手間と信頼の指標を同じ表に並べ、片方だけが改善していないかを見る。有人への引き継ぎを失敗としてだけ数えず、正しく渡せた件数も別に数える。
6. 結び
第一に、Finの調査で顧客がAIを信頼しやすくなる条件の上位2つに選んだのは、人に代われることと、AIだと最初に分かることでした。同社によると、懸念は正確な答えを出せるかより「どう解決するか」に向き、信頼しない理由は責任と例外判断の2つでした。
第二に、論文は、手間はチャットボット、解決品質と信頼は人という分担を示しました。ただしFinの調査も論文も、性質上は仮説を補強する材料にとどまり、因果は示していません。
第三に、センターの評価指標は手間の側に偏っています。顧客努力・解決品質・信頼を並べ、人への導線を実測することが、AIの信用を測る最初の一歩になると私は考えます。
あなたのセンターでは、AIとの会話から担当者にたどり着くまでに、顧客に何回同じことを言わせているでしょうか。まずその回数を数えてみてはどうでしょうか。
注記:本記事の数値は、Finの2026年9月10日のブログおよびレポートページ、IBIMA Publishingの2026年9月9日掲載論文、各社の公開ページに基づき、2026年9月11日時点で確認したものです。Finのレポート本体(フォーム登録制)は確認しておらず、調査国・実施時期・実施会社・設問文は公開ページの範囲では分かりません。論文の群別平均値はPDF版の表から引いています。見立てに関する部分は筆者個人の見解です。本記事は公開情報をもとにした筆者の分析であり、記事作成にはAIによるリサーチ支援を活用しています。
参考リンク
元になった調査・論文
Fin「Announcing the 2026 AI Sentiment Report: How end users feel about AI Agents」(2026年9月10日) https://fin.ai/blog/announcing-2026-ai-sentiment-report
Fin「The 2026 AI Sentiment Report」レポートページ https://fin.ai/ai-sentiment-report
Ioseb Gabelaia, Samuel Steiner「Balancing Customer Effort and Communication Outcomes in Chatbot and Human-Agent Customer Interactions: A Quantitative Study」Journal of Marketing Research and Case Studies(2026年9月9日) https://ibimapublishing.com/articles/JMRCS/2026/132473/
同論文 PDF版 https://ibimapublishing.com/articles/JMRCS/2026/132473/132473.pdf
当ラボの関連記事
コールセンターでAIから人へ渡す設計 ー エスカレーションの遅れが不満を生む https://ccai-lab.com/articles/2026-09-02-escalation-design-ai
AIだと名乗るべきか ー 音声AI応対の「開示」をめぐる対話 https://ccai-lab.com/articles/2026-08-05-dialogue-ai-disclosure
完結率・自己解決率・自動化率は各社で定義がずれている ー 指標を突合するチェックリスト https://ccai-lab.com/articles/2026-08-11-metrics-definition-audit
顧客はAI応対をどう受け止めているのか ー 満足度調査データを読み解く対話 https://ccai-lab.com/articles/2026-08-21-dialogue-customer-perception
AIの誤答は誰の責任か? ベンダー・導入企業・現場の分界点を掘り下げる https://ccai-lab.com/articles/2026-08-07-dialogue-error-liability
外部出典
Beall's List「Potential predatory scholarly open-access publishers」 https://beallslist.net/
Fin「Salesforce completes acquisition of Fin」(2026年9月10日) https://fin.ai/blog/salesforce-completes-acquisition-of-fin
Fin「Fin AI Agent Pricing」 https://fin.ai/pricing
総務省・経済産業省「AI事業者ガイドライン(第1.2版)」(2026年3月31日) https://www.meti.go.jp/shingikai/mono_info_service/ai_shakai_jisso/pdf/20260331_1.pdf
よくある質問
顧客はどんな条件ならAIエージェントを信頼しやすくなりますか
Finの2026年の調査では、AIを信頼しやすくなる条件として回答者が選んだ上位2つは「必要なときに人へ簡単にエスカレーションできること」と「AIとやり取りしていることを最初に告げられること」でした。比率は公開ページに記載がなく、ベンダーによる調査のため、自センターの顧客に当てはまるかは導線や開示文言を変えたときの反応で確かめる必要があります。
チャットボットと人の応対では、顧客の評価はどう違いますか
2026年9月に掲載された論文によると、291件の回答の分析では、チャットボットを評価した回答者は顧客努力(手間)が有意に低く、人を評価した回答者は解決品質と信頼が有意に高い結果でした。満足度とロイヤルティ意向には有意差が出ていません。過去の体験の自己評価で、回答者を意図して選んだ調査である点に留意が要ります。
AIの評価をAHTや自動化率だけで見ると、何が問題ですか
AHTや自動化率は手間や効率の側を測る指標で、顧客が解決したと感じたか、次もAIに任せてよいと思ったかは測れません。顧客努力スコア(CES)、同一用件の再接触率、人への切り替え要求率と到達までの手順数を並べると、手間が減った裏で信頼が下がっていないかを確認できます。
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
 この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。