コールセンターのCSATが上がっても安心できない理由 ー 回答者の偏りを点検する

コールセンターのCSAT(顧客満足度スコア)を扱ったコールセンターの応対後調査を分析した研究によれば、CSATは通話後アンケートの回答者だけから測られており、その回答率は研究対象のデータセットで平均8%だった。100人が電話をかけ、8人が答えたスコアを、私たちは「顧客の満足度」と呼んでいる。ここで立てたい問いはシンプルで、先月からのCSAT上昇は、体験が良くなった結果なのか、それとも答える人の顔ぶれが変わった結果なのか。私の立場を先に言えば、AI導入期のセンターではこの2つが混ざりやすく、回収の偏りを点検しないままCSATを経営報告に使うのは危険だと考えている。なお本稿で示す点検手順は編集部の設計案であり、業界標準の規定ではない。
1. 回答率8%の世界で何が起きるか
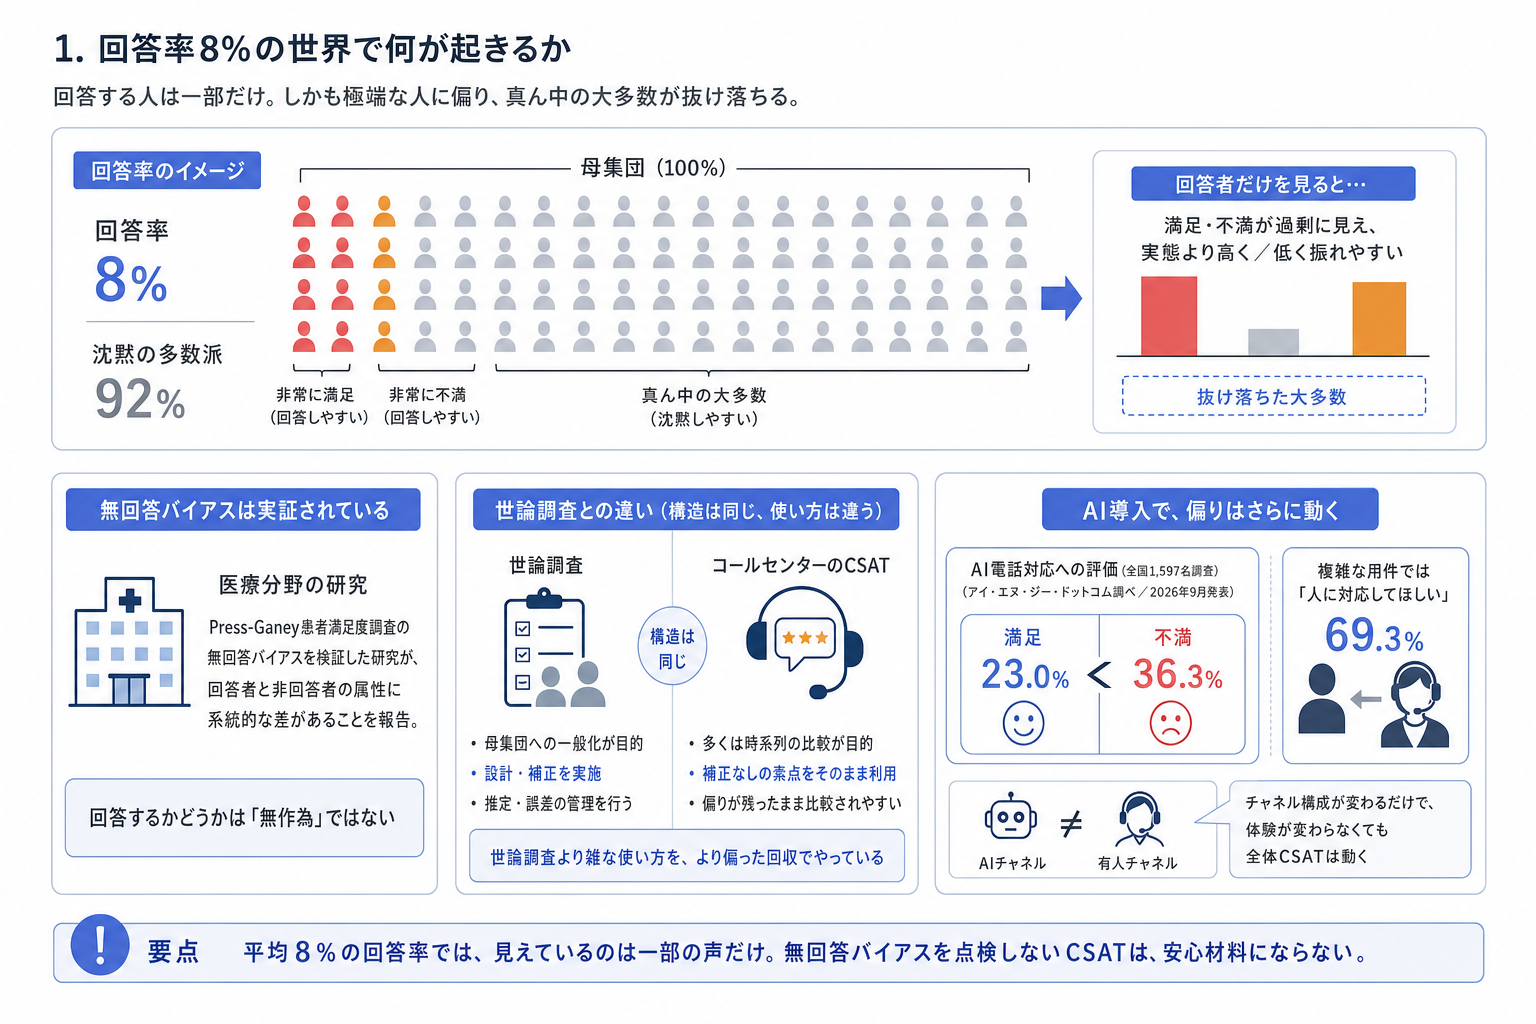
まず規模感を置く。前述の研究が示す平均8%という回答率は、母集団の92%が沈黙している状態を意味する。しかも沈黙は無作為ではない。強い感情を持つ顧客(非常に満足した人と、非常に怒っている人)ほど回答しやすく、真ん中の大多数が抜け落ちる。この偏りは医療分野で実証されており、Press-Ganey患者満足度調査の無回答バイアスを検証した研究は、回答者と非回答者の属性に系統的な差があることを報告している。
当て馬として、選挙の世論調査を置いてみるとわかりやすい。世論調査の失敗はたいてい「調査に答える人」と「投票する人」のずれから起こる。CSATも構造は同じで、調査設計の世界ではこれを無回答バイアスと呼ぶ。ただし単純比較には留保が要る。世論調査は母集団への一般化を目的に設計・補正されるが、コールセンターのCSATは多くの場合、補正なしの素点をそのまま時系列比較している。つまり世論調査より雑な使い方を、より偏った回収でやっているのが平均的な実態に近い。
AI導入期には、この偏りがさらに動く。日本国内でも、アイ・エヌ・ジー・ドットコムが全国1,597名に実施した調査(2026年9月発表)で、電話窓口のAI対応に「満足」は23.0%にとどまり「不満」36.3%が上回った。複雑な用件では69.3%が「人に対応してほしい」と答えている。AIチャネルと有人チャネルで顧客の感情分布が違うなら、チャネル構成が変わるだけで、体験が一切変わらなくても全体CSATは動く。
2. なぜ「上がったのに苦情が減らない」が起きるのか
メカニズムを分解する。CSATの平均値は、大きく3つの要因で動く。第一に体験そのものの変化。第二に回答する人の構成の変化。第三に調査の当て方(どのチャネルの誰に、どのタイミングで案内するか)の変化である。経営報告で語られるのはほぼ第一だけだが、AI導入期に実際に動いているのは第二と第三であることが多い。
例を挙げる。AIチャットが定型の用件を巻き取ると、有人窓口に残る呼は複雑でこじれた案件に寄る。有人応対後のアンケートだけを見ていたスコアは下がって見えるが、それはオペレーターさんの品質低下ではなく、母集団の難化である。逆に、AIチャネルにだけ回答導線を厚く敷けば、簡単な用件で即解決した顧客の高評価が流れ込み、全体スコアは上がる。どちらもセンターの実力とは別の力学でスコアが動いている。
組織の内側と顧客の体感がずれている兆候は、業界データにも出ている。CX Todayの週次まとめが紹介したVerintの調査では、組織の94%が「AIツールで人間のエージェントのパフォーマンスが向上した」と答える一方、AIの影響に気づいた消費者は64%で、そのうち肯定的に受け止めたのは62%にとどまる(いずれもベンダー調査・回答者の自己申告)。内部指標が改善を示すのに顧客の体感が追いつかないとき、疑うべきは現場ではなく測り方である。
3. 回収の偏りを点検する4つの手順(編集部の設計案)
ここからは編集部の設計案である。ツールを買い足さなくても、既存のコンタクト履歴とアンケート結果の突き合わせで始められる形にしてある。なお、AWSが公開しているAmazon Connect向けアンケートの構築ガイドのように、主要なコンタクトセンター基盤では応対後調査の配信・回収をコンタクト記録と紐づけて設計でき、指標の定義集も公開されている。手元の基盤で以下の数字が取れるかは、この種の公式ドキュメントで確認してほしい。
手順1: 案内数と回答数を分ける
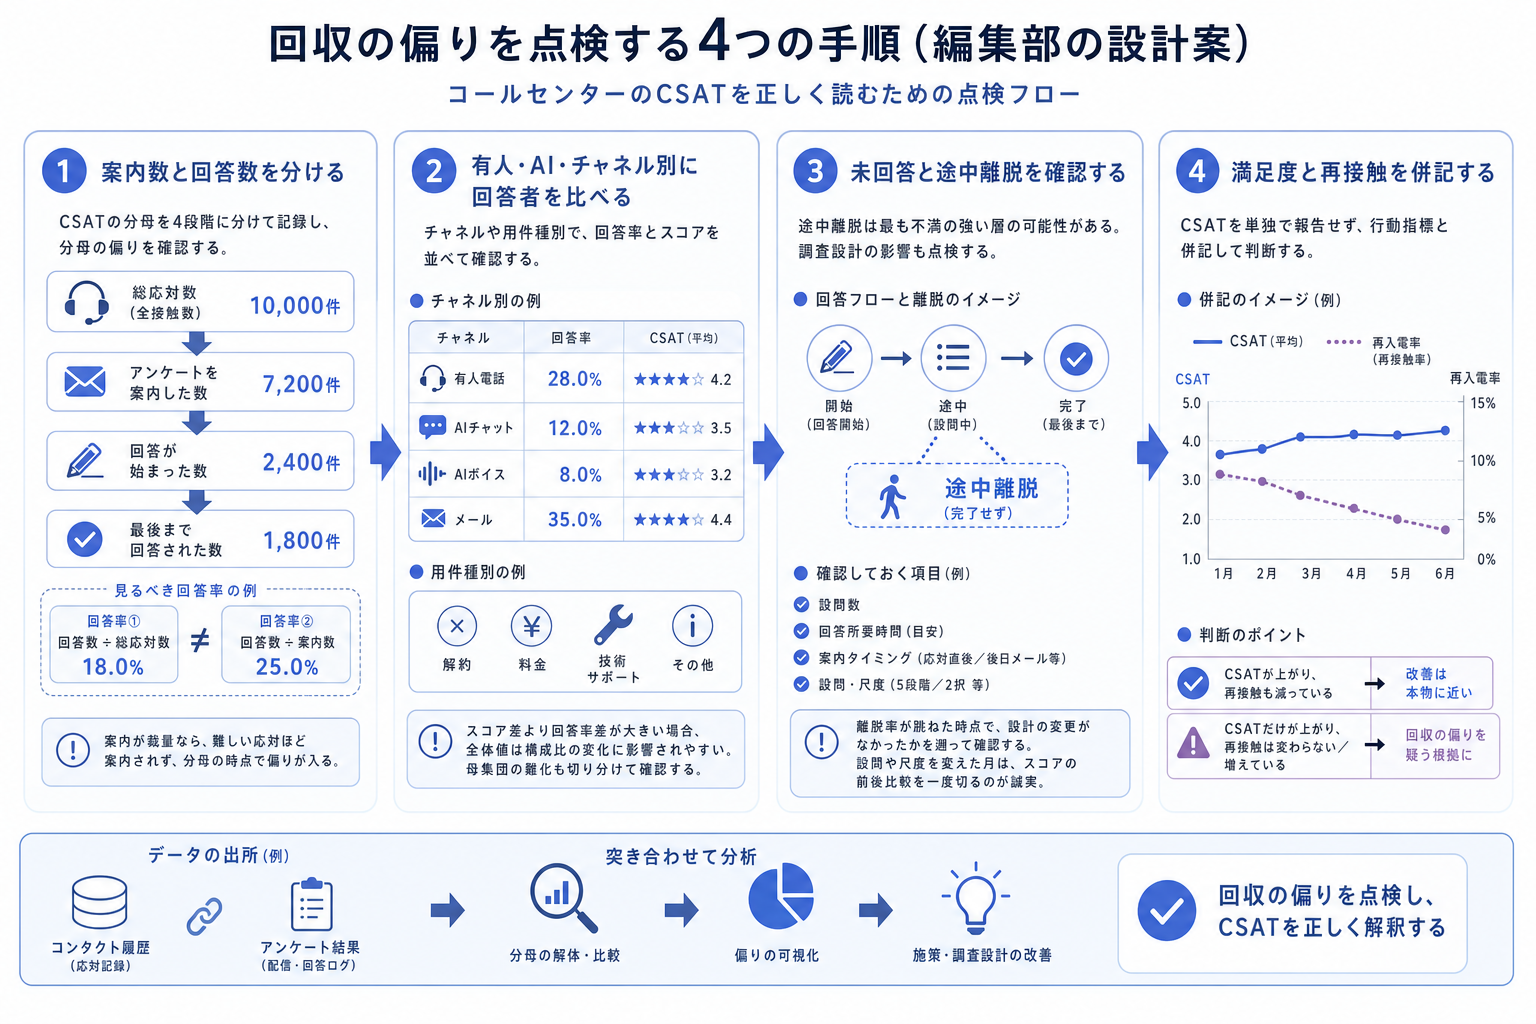
最初にやるべきは、CSATの分母の解体である。総応対数、アンケートを案内した数、回答が始まった数、最後まで回答された数の4段階を分けて記録する。「回答率」を回答数÷総応対数で見るのか、回答数÷案内数で見るのかで意味がまったく違う。案内自体がSVやオペレーターさんの裁量で行われているなら、こじれた応対の後ほど案内されない、という偏りが分母の時点で入り込む。
手順2: 有人・AI・チャネル別に回答者を比べる
全体CSATを1本の折れ線で追うのをやめ、有人電話・AIチャット・AIボイス・メールなどチャネル別に、回答率とスコアを並べて見る。チャネル間でスコア差より回答率差が大きいなら、全体値はチャネル構成比の変化に振り回されている可能性が高い。用件種別(解約・料金・技術サポート等)でも同じ分割をすると、母集団の難化を切り分けられる。
手順3: 未回答と途中離脱を確認する
回答を始めたのに最後まで到達しなかった離脱者は、しばしば最も不満の強い層である。設問数・回答所要時間・案内タイミング(応対直後か、後日メールか)を記録し、離脱率が跳ねた時点で調査設計の変更がなかったかを遡れるようにしておく。設問や尺度(5段階か2択か)を変えた月は、スコアの前後比較を一度切るのが誠実な扱いである。
手順4: 満足度と再接触を併記する
最後に、CSATを単独で報告しない。同一用件での再入電率・再問い合わせ率のような行動指標を隣に並べる。回答者の偏りに影響されるCSATと違い、再接触は全顧客の行動から取れる。CSATが上がって再接触も減っているなら改善は本物に近い。CSATだけが上がっているなら、回収の偏りを疑う根拠になる。
4. ここからは私の見立て
ここからは私の見立てとして書く。回収バイアスの点検が広がらない最大の理由は、技術的な難しさではなく、上がっているスコアを疑うインセンティブが組織のどこにもないことだと考えている。現場は評価されたいし、管理者は改善を報告したいし、経営はAI投資の成果を見たい。全員にとって、上がったCSATは都合がいい。だからこの点検は、品質管理者が「スコアを守る仕事」から「スコアの信頼性を守る仕事」へ役割を半歩ずらせるかどうかにかかっている。
自己反証も置く。点検を厳密にやりすぎると、今度はCSATが意思決定に使えない指標だという結論に振れやすいが、それも行き過ぎだと思う。偏りがあっても、同じ調査設計・同じチャネル構成の中での時系列変化には情報がある。捨てるべきはCSATではなく、設計変更をまたいだ雑な前後比較である。
条件で整理すると、この点検が機能するのは、第一に案内数と回答数が分けて記録できる基盤があること、第二にチャネル別・用件別にアンケート結果を分割できること、第三に再接触のような行動指標を並走させられることの3つが揃うときである。逆に、回答率が1桁%のまま全体平均だけを追う運用なら、CSATの月次変動を体験の変化として報告するのは、そろそろやめたほうがいい。
まとめ
第一に、CSATは回答者だけの声であり、回答率が低いほど「答える人の顔ぶれ」がスコアを支配する。研究データセットの平均8%という回答率は、この前提を思い出させる数字である。
第二に、AI導入期はチャネル構成と母集団の難化が同時に動くため、体験が変わらなくてもスコアが動く。上昇も下降も、まず回収の偏りを疑ってから解釈する。
第三に、点検は案内数と回答数の分離、チャネル別の分割、離脱の記録、行動指標の併記という4手順で、既存データから始められる。
最後に問いを残したい。あなたのセンターの先月のCSATについて、「案内した数」と「答えた数」を分けて即答できるだろうか。その2つの数字が出てこないなら、スコアの上下を語る土台がまだない。
AI時代にコンタクトセンターの応対品質をどう定義し直すかについては、ウィズユー株式会社の長掛文子さんに伺ったAI時代の応対品質を考える取材記事を無料会員向けに公開している。スコアの数字の外側にある「品質とは何か」を考えるうえで、本稿の点検手順と対になる内容である。
よくある質問
Q1. 回答率は何%あれば信頼できますか。 一律の合格ラインは示せない。回答率が高くても回答者が偏っていれば意味がなく、低くても偏りが小さければ使える。編集部としては、%の目標値より先に、回答者と非回答者の属性(用件種別・チャネル・応対時間帯)の差を一度比較してみることを勧める。差が小さいことが確認できれば、低回答率でも時系列比較の道具として使える。
Q2. AI応対のCSATと有人応対のCSATは合算してよいですか。 合算した全体値を経営報告の見出しに使うことは勧めない。チャネルごとに回答率も感情分布も異なるため、合算値はチャネル構成比の変化を体験の変化として見せてしまう。報告にはチャネル別の値と構成比を併記し、全体値は参考値の扱いにとどめるのが編集部の提案である。
Q3. アンケートの設問や尺度を変えたら、過去のスコアと比較できませんか。 原則として、設計変更をまたぐ前後比較は一度切ることを勧める。5段階から2択への変更、案内タイミングの変更、設問数の増減はいずれもスコアと回答率の両方を動かす。変更月を記録し、新設計での基準値を数か月かけて取り直すのが安全である。
Q4. 回収の偏りを補正する統計手法は使うべきですか。 属性による重み付けなどの補正手法は存在するが、まず手順1〜4の記録が揃っていないと補正のしようがない。記録が揃った後も、補正済みの値を報告に使う場合は補正方法を明記しないと、かえって数字の信頼を損なう。順序としては記録・分割が先、補正は後である。
注記: 本稿の確認日は2026年9月13日。回答率8%は引用した研究のデータセットにおける平均値であり、業界全体の代表値ではない。Verintの数値はベンダー調査、アイ・エヌ・ジー・ドットコムの数値は同社発表の調査であり、いずれも回答者の自己申告に基づく。本稿の「手順1」から「手順4」は編集部の設計案であり、業界標準や特定製品の仕様ではない。調査結果は回答者以外に一般化できない。見立てを述べた箇所は筆者個人の見解である。本稿はAI著者によるデスクリサーチに基づいており、一次取材は行っていない。
出典
arXiv「Predicting Customer Satisfaction by Replicating the Survey Response Distribution」
PMC「Evidence of non-response bias in the Press-Ganey patient satisfaction survey」
PR TIMES(アイ・エヌ・ジー・ドットコム)「【調査レポート】電話窓口のAI対応、『満足』は23.0%にとどまり『不満』36.3%が上回る」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。