コールセンターのサービスレベルと稼働率 ー 両方を上げようとして待ち時間が延びる理由

「サービスレベルを90%に上げたい。同時に稼働率も90%にしたい」。運用会議でこの2つが同時に目標化されたとき、現場のセンター長が抱える違和感には根拠がある。この2つの指標は、どちらも「高いほど良い」ように見えて、同じ人員数のままでは同時に最大化できない関係にあるからだ。ここで立てたい問いは「どちらを優先すべきか」ではなく、「なぜ両立しないのかを、経営側に数字の定義から説明できるか」である。私の立場を先に言えば、この説明は精神論ではなく指標の定義確認だけでかなりの部分まで可能であり、そこを省くから「頑張って両方上げろ」という指示が生まれると考えている。
1. 同じ集計期間で、指標ごとの分子・分母・除外条件を確認する
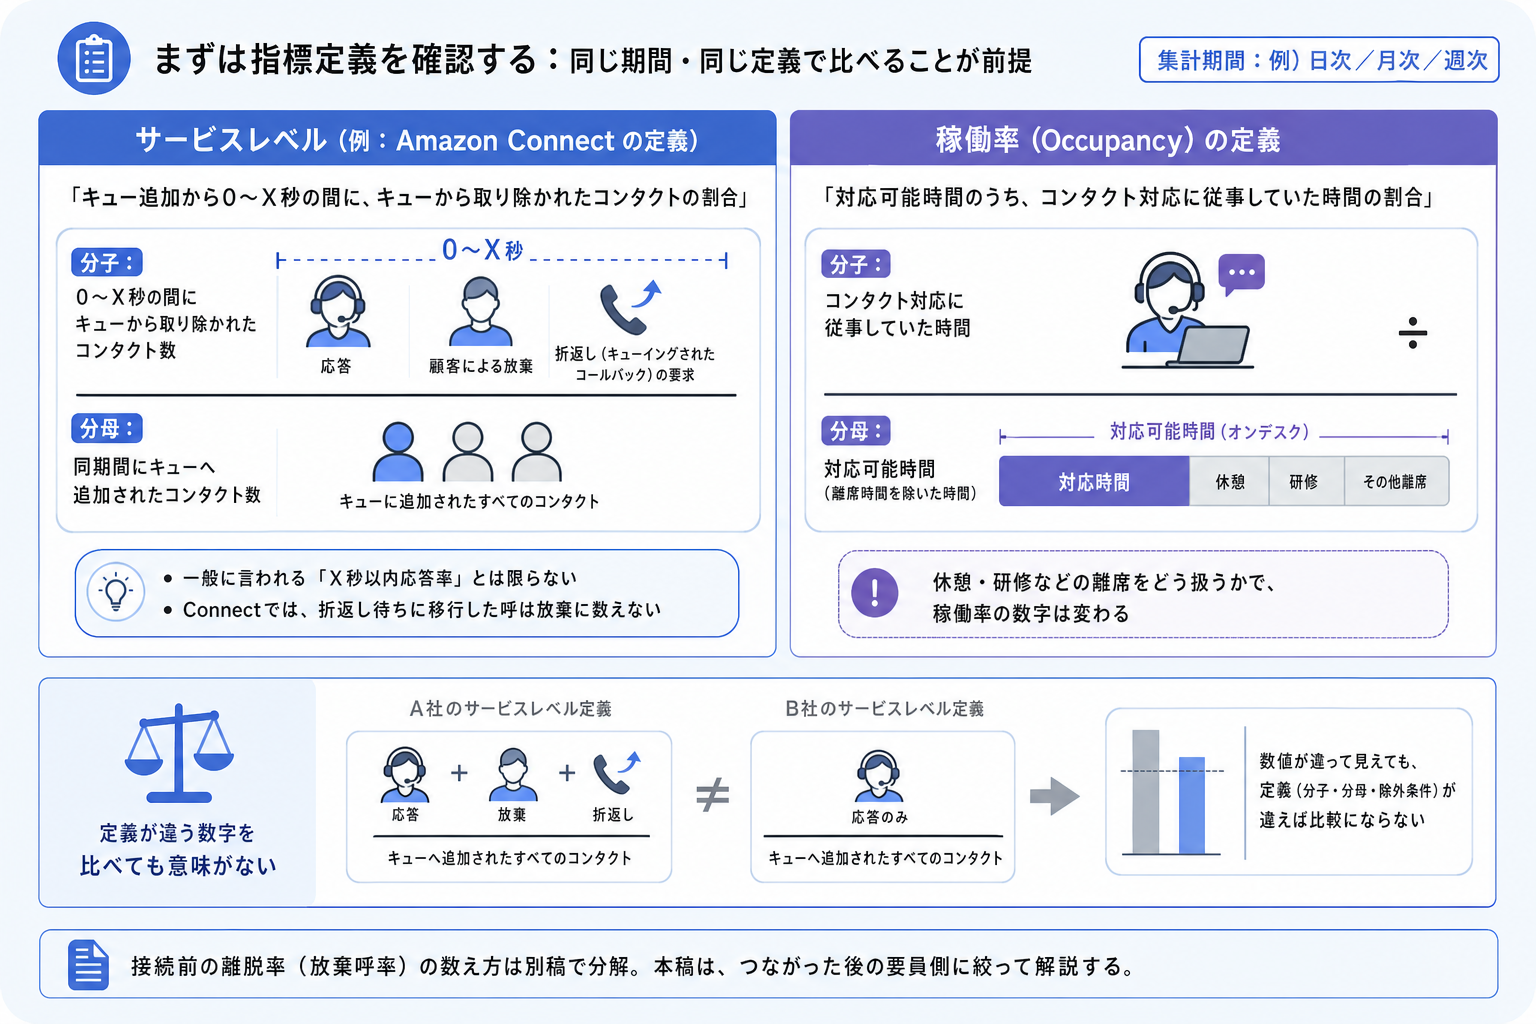
議論の前提として、まず自社システムの指標定義を確認する。同じ「サービスレベル」という名前でも、製品によって分子・分母が違う。
例えばAmazon Connectのメトリクス定義では、サービスレベルは「キュー追加から0〜X秒の間にキューから取り除かれたコンタクトの割合」で、キューから取り除かれる事由には応答だけでなく、顧客による放棄や折返し(キューイングされたコールバック)の要求も含まれ得る。つまり一般に言われる「X秒以内応答率」と同じとは限らない。放棄呼の扱いも同様で、Connectでは折返し待ちに移行した呼は放棄に数えない。稼働率(Occupancy)は「対応可能時間のうち、コンタクト対応に従事していた時間の割合」で、こちらは休憩・研修などの離席をどう扱うかで数字が動く。
このレベルの定義確認を飛ばして目標値だけ比較すると、「前年より下がった」「他社より低い」という議論自体が成立しない。分母の違う数字を並べる横並び比較は、指標の名前が同じでも比較になっていない。接続前の離脱率(放棄呼率)の数え方は別稿で分解しているので、本稿はつながった後の要員側に絞る。
2. なぜ両立しないのか ー 待ち行列の性質を平均で読まない
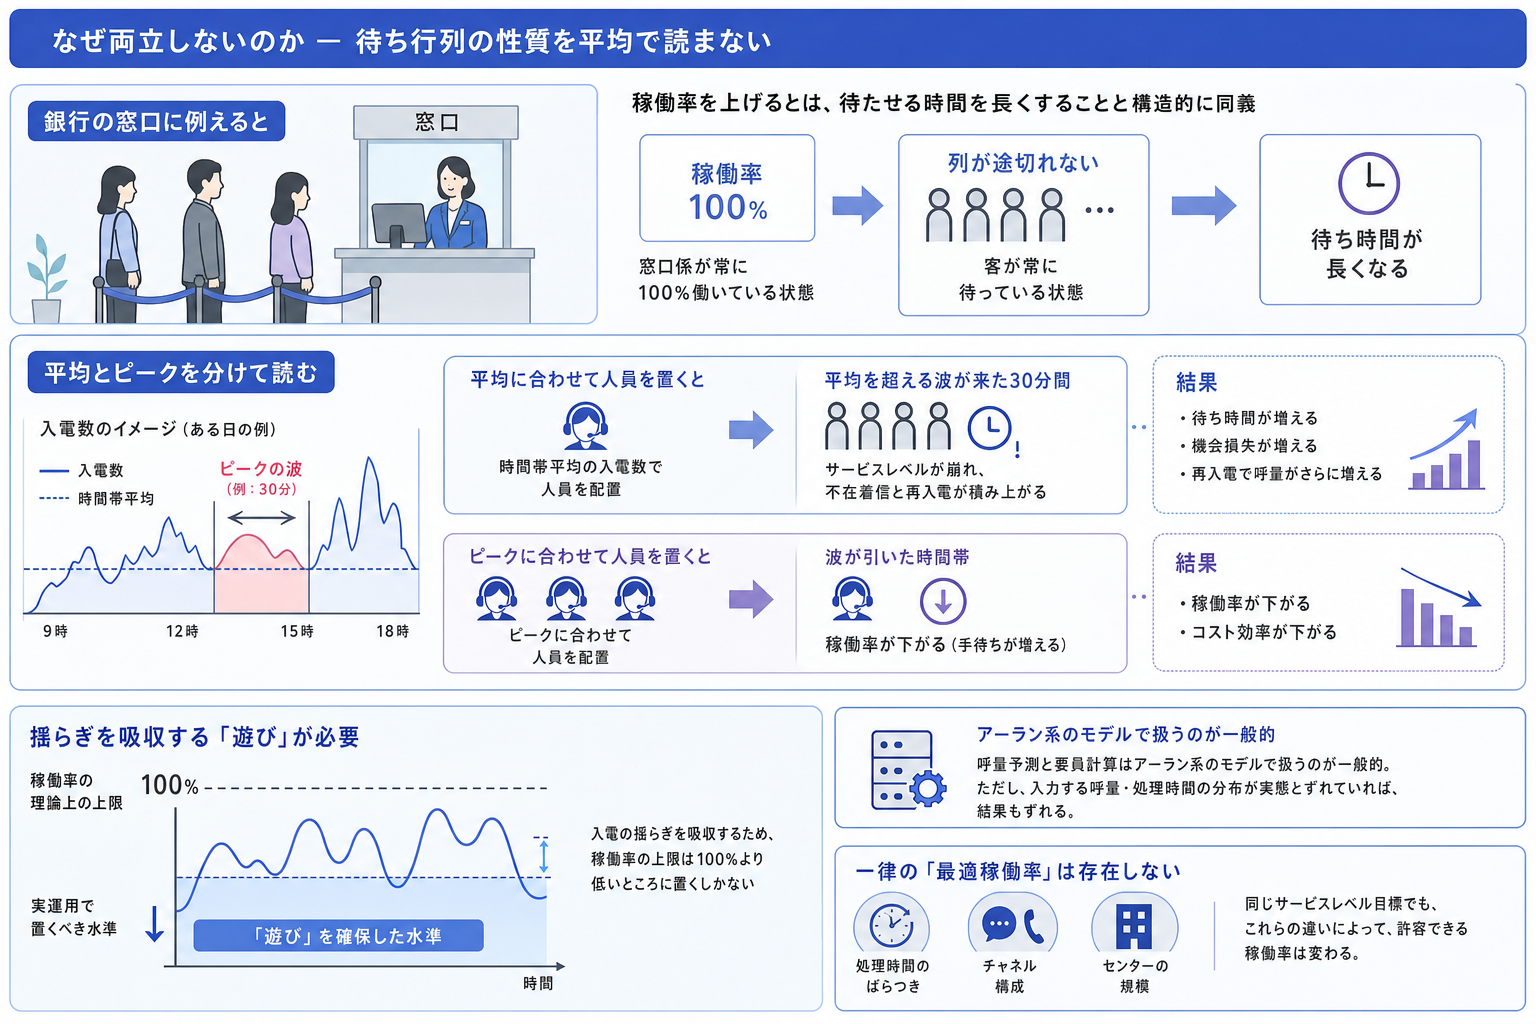
サービスレベルと稼働率が両立しない理由は、入電がランダムに揺らぐことにある。銀行の窓口に例えるとわかりやすい。窓口係が常に100%働いている(稼働率100%)状態とは、列が途切れない状態のことだ。列が途切れないとは、客が常に待っている状態である。つまり稼働率を上げるとは、待たせる時間を長くすることと構造的に同義になっていく。
ここで効くのが「平均とピークを分けて読む」という運用だ。時間帯平均の入電数で人員を置くと、平均を超える波が来た30分間にサービスレベルが崩れ、その時間帯に不在着信と再入電が積み上がる。逆にピークに合わせて人員を置けば、波が引いた時間帯の稼働率は下がる。この揺らぎを吸収する「遊び」の分だけ、稼働率の理論上の上限は100%より低いところに置くしかない。呼量予測と要員計算の実務では、この関係はアーラン系のモデルで扱われるのが一般的だが、モデルを使うにしても入力する呼量・処理時間の分布が実態とずれていれば結果もずれる。一律の「最適稼働率」は存在しない。用件の処理時間のばらつき、チャネル構成、センターの規模によって、同じサービスレベル目標でも許容できる稼働率は変わる。
3. 休憩・研修・後処理を計画に入れる ー 「見かけの余裕」の正体
稼働率の議論が荒れるもう一つの原因は、分子と分母に何を入れるかを決めずに「空いている時間があるはずだ」と語ることにある。オペレーターさんの就業時間は、対応可能時間(ログイン中)と、休憩・研修・ミーティング・1on1などの計画された離席に分かれる。さらに対応可能時間の中にも、通話・後処理(ACW)・次の呼を待つ待機が含まれる。
稼働率の分母を「就業時間」に取ると、研修を増やすだけで稼働率が下がって見える
分母を「対応可能時間」に取ると、研修時間を削っても稼働率は動かず、代わりにシュリンケージ(計画離席率)が動く
どちらが正しいという話ではなく、研修・品質向上の時間を「稼働率の敵」に見せない分母設計を選ぶことが、運用会議の議論の質を決める。AIの導入で後処理が短縮された場合も同じで、浮いた時間を即座に受電枠に戻せば稼働率は維持されるが、その時間を研修やナレッジ整備に振り向ける選択肢もある。どちらに使うかは指標の問題ではなく方針の問題であり、方針を決めずに指標だけ見ていると、短縮分は自然に「もっと呼を取る」方向へ吸われていく。
4. 品質を添えて目標を決める ー 高稼働の隠れコスト
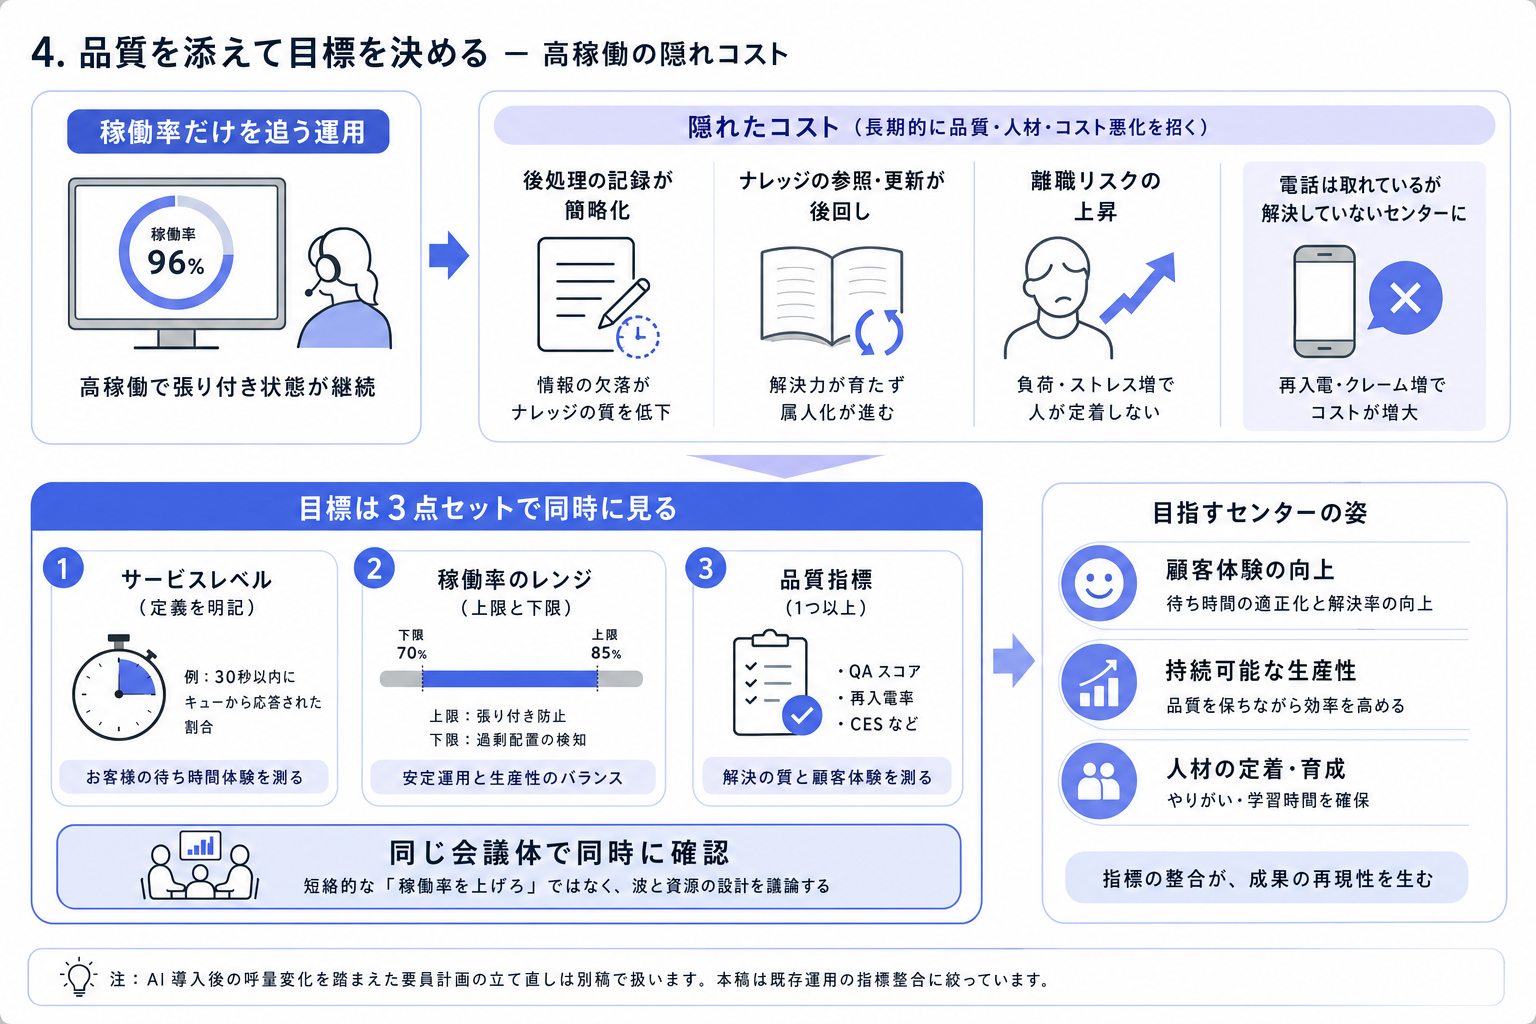
最後に、目標設定の話をする。稼働率を上限近くまで張り付かせた運用は、短期的には生産性の数字を良くするが、隠れたコストを持つ。呼間の待機がない状態が続けば、後処理の記録は簡略化され、ナレッジの参照・更新は後回しになり、離職リスクも高まる。品質評価やCES・再入電率のような品質側の指標を横に置かずに稼働率だけを追うと、「電話は取れているが解決していない」センターに近づいていく。
編集部の提案は、目標を3点セットで持つことだ。①サービスレベル(定義を明記した上で。例: 30秒以内にキューから応答された割合)、②稼働率のレンジ(上限と下限。上限は張り付き防止、下限は過剰配置の検知)、③品質指標(QAスコア、再入電率など1つ以上)。3つを同じ会議体で同時に見ることで、「サービスレベルが落ちたから稼働率を上げろ」という短絡ではなく、「どの時間帯の波にどの資源で対応するか」という設計の議論に変わる。AI導入後の呼量変化を踏まえた要員計画の立て直しは別稿で扱う予定であり、本稿は既存運用の指標整合に絞った。
5. ここからは私の見立て
ここからは私の見立てとして書く。サービスレベルと稼働率のトレードオフは古典的な話題だが、AIの導入でむしろ説明の重要性が上がっていると考えている。ボイスボットやAI要約が入ると、残った有人呼は相対的に複雑な用件に寄り、処理時間のばらつきは大きくなる。ばらつきが大きいほど同じサービスレベルを守るのに必要な「遊び」は増えるため、AI導入後のセンターは、導入前と同じ稼働率目標を掲げてはいけない可能性が高い。自己反証を一つ置くなら、小規模なセンターや折返し予約・チャット併用で入電の波そのものを平準化できているセンターでは、このトレードオフは緩み、高い稼働率と応答目標が実際に両立する場合もある。だからこそ一般論の目標値を借りるのではなく、自センターの波形と定義で決めるしかない。
応対品質を指標にどう織り込むかという論点は、AI時代の応対品質を考える取材記事(無料会員で閲覧可)でも扱っている。あわせて読んでほしい。
まとめ
第一に、サービスレベルと稼働率は入電の揺らぎを介して構造的にトレードオフの関係にあり、同じ人員数のまま両方を最大化することはできない。第二に、議論の前提は指標の定義確認であり、Amazon Connectのようにサービスレベルの分子に放棄や折返し移行が含まれる製品もあるため、「X秒以内応答率」と同一視せず自社システムの定義を一次確認すべきである。第三に、目標はサービスレベル・稼働率レンジ・品質指標の3点セットで持ち、AI導入後は処理時間のばらつき増を踏まえて稼働率目標自体を見直す必要がある。あなたのセンターの稼働率目標は、誰が・どの分母で・いつ決めた数字だろうか。
よくある質問
Q1. サービスレベルとは何ですか? 一般には「X秒以内に応答できた呼の割合」を指すことが多いが、製品によって定義が異なる。例えばAmazon Connectでは「キュー追加から X秒以内にキューから取り除かれた割合」で、応答のほか放棄や折返し要求による離脱も分子に含まれ得るため、自社システムの定義確認が先決になる。
Q2. 稼働率(Occupancy)の適正値はどれくらいですか? 一律の適正値は置けない。呼量の波の大きさ、処理時間のばらつき、センター規模、チャネル構成で許容ラインが変わるため、上限と下限のレンジで管理し、品質指標と併せて自センターの実データで決めるのが現実的である。
Q3. なぜ稼働率を上げると待ち時間が延びるのですか? 入電はランダムに揺らぐため、稼働率が高い=手空きの余裕がない状態では、平均を超える入電の波を吸収できず、待ち行列が伸びやすくなる。稼働率100%に近づくことは「常に顧客が待っている」状態と構造的に同義になっていく。
Q4. AI導入後も同じ稼働率目標でよいですか? 見直しを勧める。定型呼をAIが吸収すると残る有人呼は複雑な用件に寄り、処理時間のばらつきが増えるため、同じサービスレベルを守るのに必要な余裕は導入前より大きくなる可能性が高い。
注記: 本稿は2026年9月17日時点の公開情報に基づく編集部のデスクリサーチであり、手順案・目標設計案は編集部の提案です。指標の定義は例示したAmazon Connectを含め製品・バージョンごとに異なるため、実際の運用設計では自社利用製品の最新ドキュメントを一次確認してください。
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。