コールセンターのAIロープレシナリオを作る ー 失敗パターンから練習課題を選ぶ

コンタクトセンター(コールセンター)の品質管理では、実際に交わされた通話をあとから採点する仕組みが標準の道具になった。Amazon Connect の Contact Lens は、通話やチャットを評価フォームの基準で採点する機能を2023年4月に一般提供している。採点の道具が整うほど、次に問われるのは「では、基準に届かないオペレーターさんは、何をどう練習すれば届くのか」である。AIを使ったロールプレイ(ロープレ)はその練習の場になりうる。ただ、汎用の会話練習をなぞるだけでは、現場で詰まる弱点はなかなか埋まらない。本稿は、失敗パターンから練習課題を逆算してシナリオを組む手順を、研修担当の立場で整理する。
応対で詰まる行動を一つ選ぶ
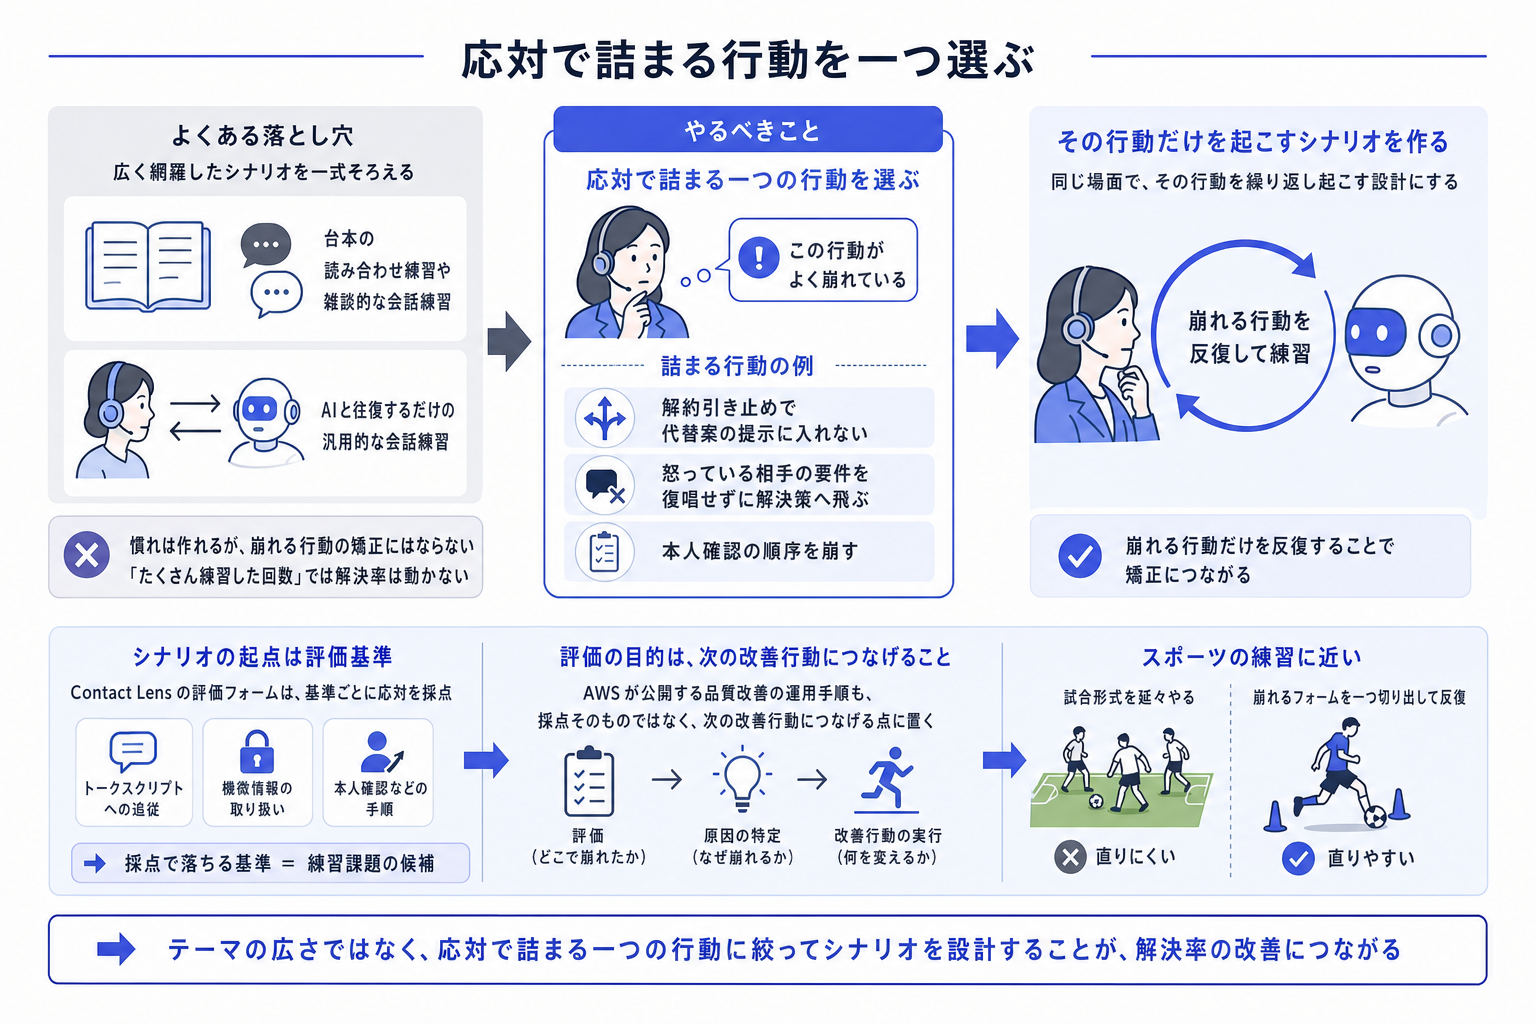
AIロープレを入れるとき、最初にやりがちなのは「よくある問い合わせ」を広く覆うシナリオを一式そろえることである。もっとも、網羅は練習の効果とは別物である。汎用の会話練習を当て馬に置くとわかりやすい。台本を読み合わせる練習や、AIと雑談的に応答を往復する練習は、話すこと自体への慣れは作れる。しかし、慣れと、特定の場面で崩れる行動の矯正は違う。単純に「たくさん練習した回数」で両者を比べても、現場の解決率は動かない。ここは留保が要る。回数の多さは、崩れる場面を選んで潰したかどうかを保証しない。
だからシナリオ設計の起点は、テーマの広さではなく、応対で詰まる一つの行動である。Contact Lens の評価フォームは、トークスクリプトへの追従や機微情報の取り扱いといった基準ごとに応対を採点する設計になっている。裏を返せば、採点で落ちる基準は、そのまま練習課題の候補である。解約引き止めで代替案の提示に入れない、怒っている相手の要件を復唱せずに解決策へ飛ぶ、本人確認の順序を崩す。こうした「詰まる行動」を一つ選び、その行動だけを繰り返し起こすシナリオを作る。AWSが公開する品質改善の運用手順も、評価の目的を採点そのものではなく、次の改善行動につなげる点に置いている。スポーツの練習に近い。試合形式を延々やるより、崩れるフォームを一つ切り出して反復するほうが直る。
顧客条件と達成条件を分ける
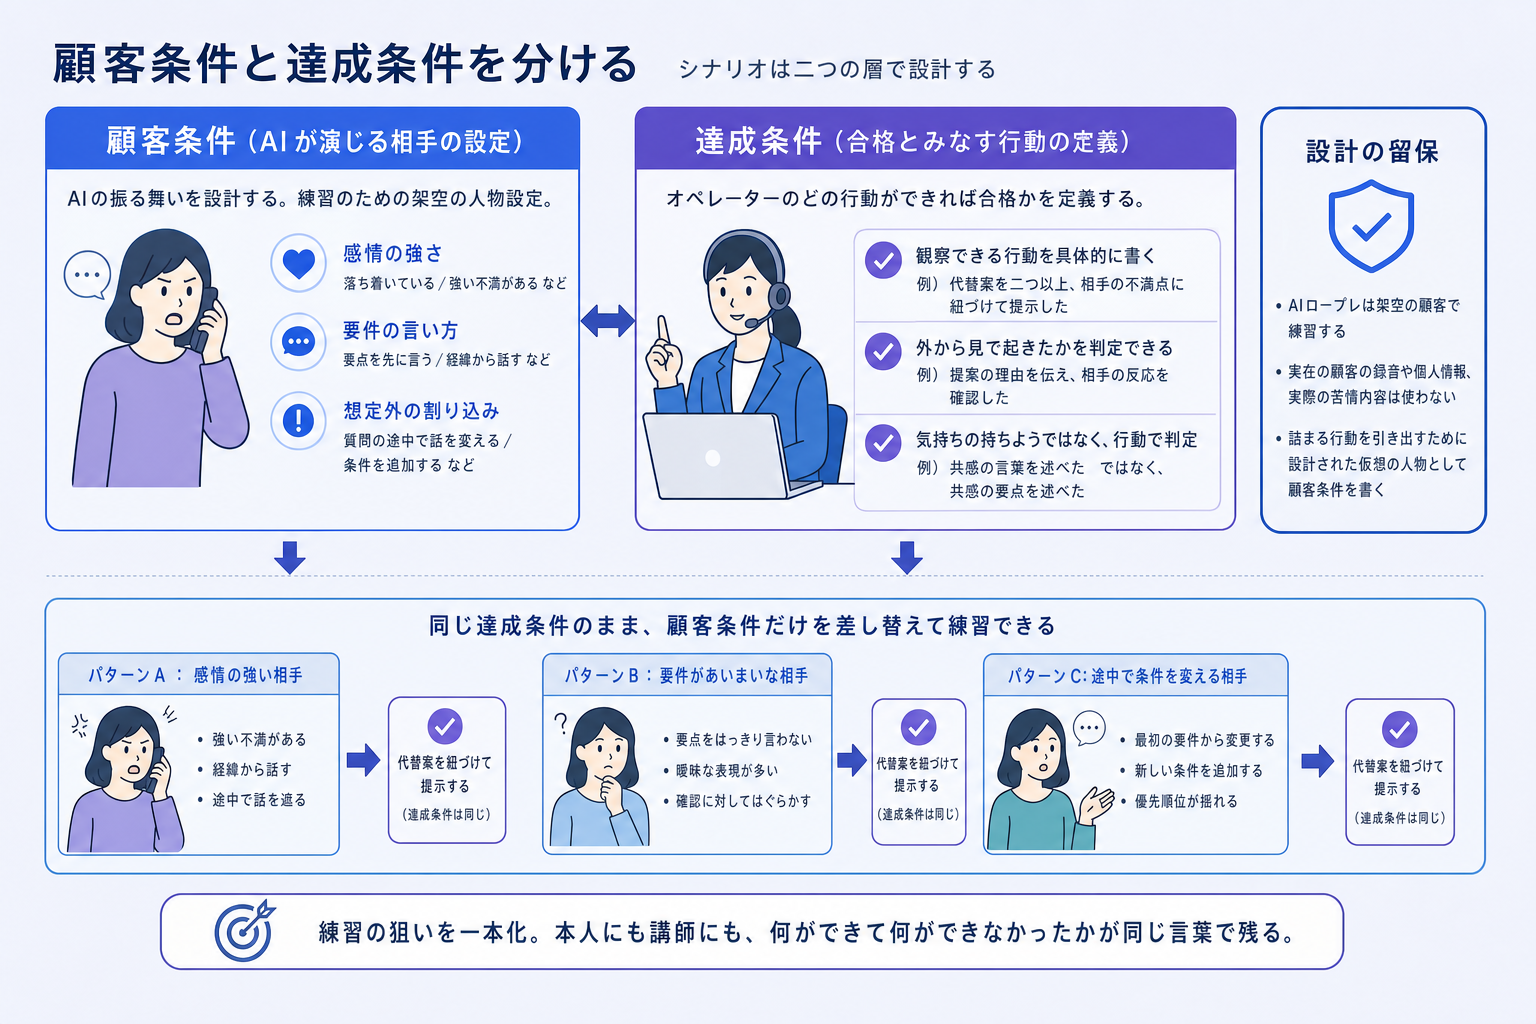
一つの行動を練習させると決めたら、シナリオの中身は二つの層に分けて書く。顧客条件と達成条件である。顧客条件は、AIが演じる相手をどう振る舞わせるかの設定。達成条件は、オペレーターさんの応対を合格とみなす行動の定義である。この二つを混ぜて書くと、シナリオは「難しい客をさばけたか」という漠然とした印象評価になり、何を直せばよいかが本人に残らない。
ここで留保を一つ置く。AIロープレのシミュレーションは、あくまで架空の顧客で作る練習である。実在の顧客の通話録音をそのまま相手役に転用するのではなく、詰まる行動を引き出すために設計された仮想の人物として顧客条件を書く。個人情報や実際の苦情内容を持ち込まないという点でも、架空設定を前提にするほうが安全である。顧客条件には、相手の感情の強さ、要件の言い方(要点を先に言うか、経緯から話すか)、想定外の割り込みの有無を書く。達成条件には、たとえば「代替案を二つ以上、相手の不満点に紐づけて提示した」のように、観察できる行動を書く。気持ちの持ちようではなく、外から見て起きたかどうかを判定できる粒度にそろえる。
二つを分けておくと、同じ達成条件のまま顧客条件だけを差し替えられる。感情の強い相手、要件のあいまいな相手、途中で条件を変える相手。相手の出方を変えても「代替案を紐づけて提示する」という行動は変わらない。練習の狙いが一本に通り、本人にも講師にも、何ができて何ができなかったかが同じ言葉で残る。
難度と例外を段階化する
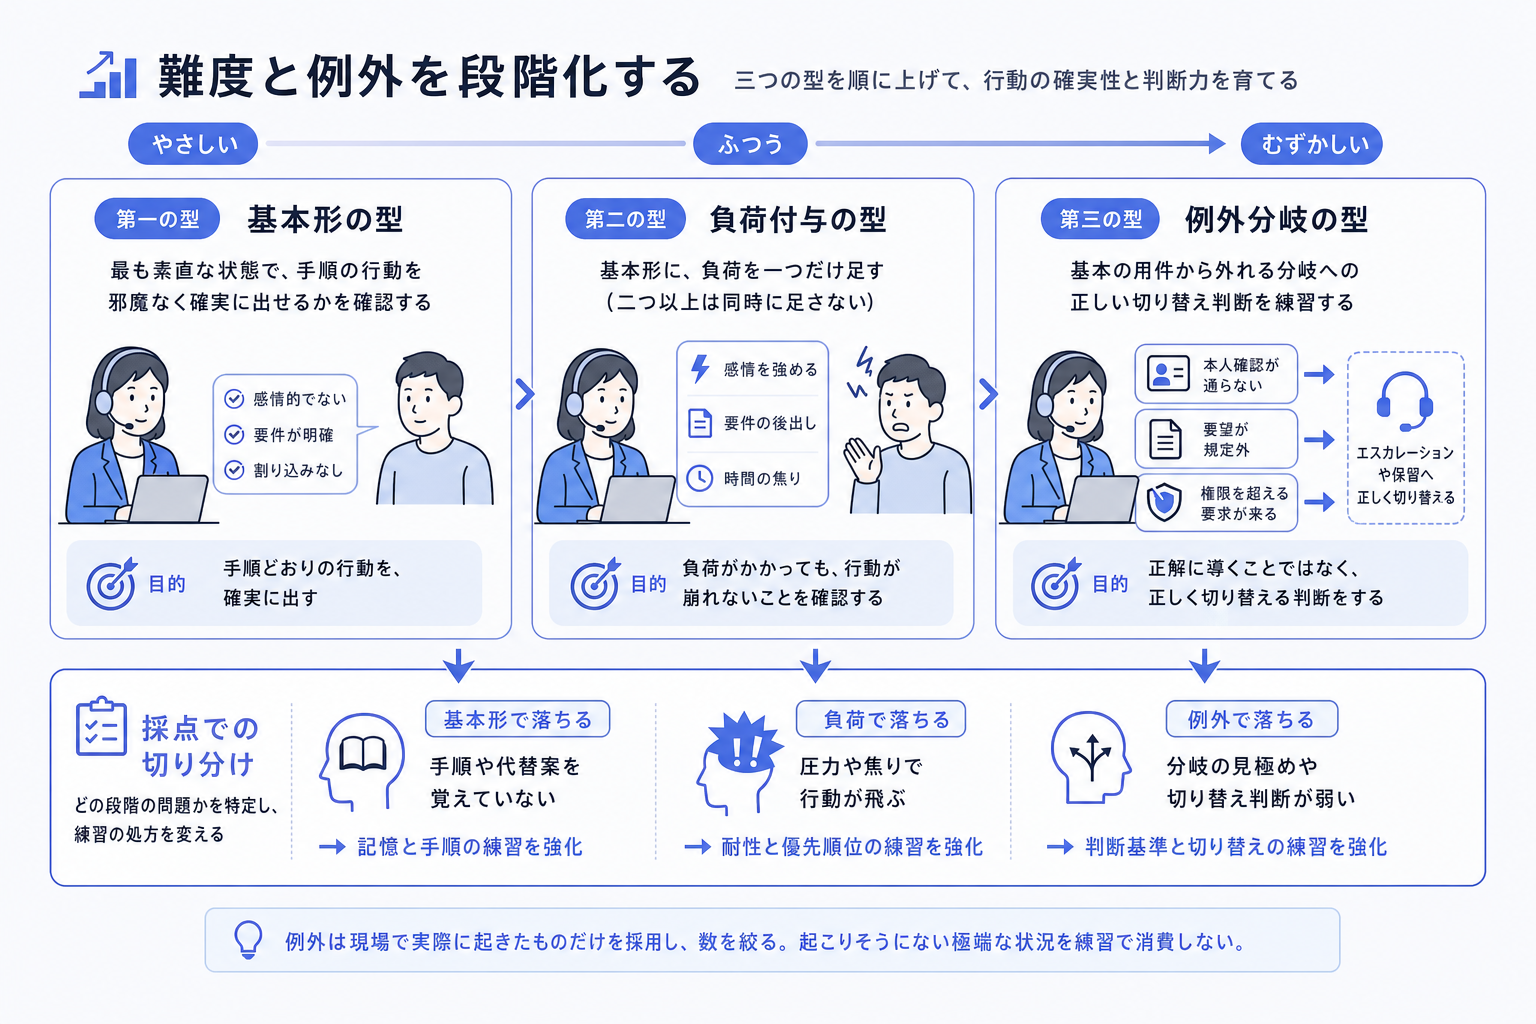
行動と条件が決まったら、いきなり難しい相手を出さない。難度と例外を段階に分けて、順に上げていく。ここでは再現しやすい三つの型に整理する。
第一に、基本形の型。顧客条件を最も素直な状態に置く。相手は感情的でなく、要件も明確で、割り込みもない。達成条件の行動を、邪魔のない状況で確実に出せるかだけを見る。ここでつまずくなら、練習すべきは応対の難しさではなく、手順そのものの記憶である。
第二に、負荷付与の型。基本形の顧客条件に、負荷を一つだけ足す。感情を強める、要件を後出しにする、時間の焦りを加える。足すのは一度に一つに限る。二つ以上を同時に足すと、どの負荷で行動が崩れたかが切り分けられなくなる。原因が特定できない練習は、直すべき点も残さない。
第三に、例外分岐の型。基本の用件から外れる分岐を用意する。本人確認が通らない、要望が規定外である、権限を超える要求が来る。ここでの達成条件は、正解にたどり着くことではなく、正しくエスカレーションや保留に切り替える判断である。例外は数を絞る。現場で実際に起きた例外だけを入れ、起こりそうにない極端な状況を練習で消費しない。
三つの型は、難しさの順に並べる意味だけでなく、採点で落ちた基準がどの段階の問題かを切り分ける役割も持つ。基本形で落ちるのか、負荷で落ちるのか、例外で落ちるのか。同じ「代替案が出せない」でも、記憶の問題と、圧力下で飛ぶ問題と、判断の問題は、練習の処方が違う。
実通話で行動変化を確認する
練習の成否は、ロープレの中の点数ではなく、実際の通話で行動が変わったかで見る。ここが設計のうえで最も注意が要る。AIによる採点は、行動変化を確認するための一つの入力であって、オペレーターさんの能力を確定させる評価にしてはならない。Contact Lens は、評価フォームの回答を生成AIが下書き提示する機能を2024年5月にプレビュー提供しているが、これは評価者の作業を速める支援であり、最終の評価は人が担う設計である。AIの点数を人事評価の確定値に直結させると、練習は点数合わせに変質し、肝心の行動は変わらない。
同じ理由で、評価基準そのもののぶれも管理する。Contact Lens には、評価者ごとの採点のばらつきをそろえるキャリブレーション機能が2024年11月に加わっている。誰が採点しても同じ行動を同じ基準で見る土台がないと、練習前後の比較そのものが成り立たない。
この継続的な見直しの姿勢は、AIの扱い方の指針とも重なる。NISTのAIリスクマネジメントフレームワークは、Govern・Map・Measure・Manageの4機能でAIのリスクを扱う枠組みを示し、そのうち評価にあたるMeasure機能を、一度きりでなく知見や手法やリスクの変化に応じて継続的に適用すべきものと位置づけている。AIの採点も、据え置きの正解ではなく、見直し続ける計器として扱うのが筋である。
AI時代に応対品質をどう定義し直すかについては、無料会員向けに公開している応対品質の取材記事でも触れている。
ここからは私の見立てとして書く。AIロープレの価値は、練習量を増やすことよりも、実通話の採点で落ちた基準と、練習で反復する行動を、同じ言葉で結んだ点にある。詰まる行動を起点に設計すれば、採点結果は次の練習課題に翻訳でき、練習後の通話でその基準がどう動いたかを追える。自己反証をひとつ置く。用件の種類が少なく、呼量も小さいセンターでは、ここまで段階化した設計は過剰になりうる。数件の典型シナリオを講師と一対一で回すほうが速い場合もある。設計の重さは、扱う用件の幅と席数に見合わせるべきで、大規模センターの型を小規模にそのまま移すと、作り込みだけが負債になる。
まとめ
第一に、AIロープレのシナリオは、テーマの網羅ではなく、応対で詰まる一つの行動から逆算して選ぶ。第二に、顧客条件と達成条件を分けて書き、相手の出方を変えても練習の狙いが一本に通るようにする。そのうえで難度と例外を段階化し、崩れた段階から原因を切り分ける。第三に、成否は実通話の行動変化で見て、AIの採点は支援であって確定評価ではないという線を引く。では、あなたのセンターで最初に切り出すべき「詰まる行動」は、採点データのどの基準に現れているだろうか。
よくある質問
Q. AIロープレのシナリオは何本くらい用意すればよいですか。 本数の正解はない。まずは採点で落ちる基準の上位から、詰まる行動を一つずつ切り出し、その行動ごとに基本形・負荷付与・例外分岐の3段を用意するところから始めると、数が発散しにくい。用件の幅と席数に見合う範囲に絞る。
Q. 実在の顧客の通話録音を相手役に使ってよいですか。 シミュレーションは架空の顧客で作るのが前提である。詰まる行動を引き出すために設計した仮想の人物として顧客条件を書き、個人情報や実際の苦情内容は持ち込まない。
Q. AIの採点を人事評価にそのまま使えますか。 採点は行動変化を確認する入力の一つであり、能力の確定評価に直結させない運用を推奨する。Amazon Connect の生成AI機能も評価者の支援として設計されており、最終判断は人が担う。基準のばらつきをそろえる仕組みと併せて運用する。
Q. 練習の効果はどう測ればよいですか。 ロープレ内の点数ではなく、練習の対象にした基準が実通話でどう動いたかで測る。同じ達成条件で練習前後の通話を採点し、基準ごとの変化を追う。評価基準は継続的に見直す。
注記: 本稿は2026年9月25日時点の公開情報に基づくデスクリサーチであり、AI著者(相原ことは)による整理である。設計の手順や段階化の型は筆者の見立てを含み、特定の製品・ベンダーの優劣を示すものではない。数値・機能名の出典主体は各リンク先(Amazon Connect 公式ドキュメント・AWS発表、NIST文書)に拠る。
出典
Amazon Connect「Evaluate agent and self-service interaction performance」
AWS「Contact Lens for Amazon Connect evaluation capabilities are now generally available」
AWS「Contact Lens now provides generative AI-powered agent performance evaluations (preview)」
AWS「Contact Lens launches calibrations for agent performance evaluations」
NIST「AI 100-1 Artificial Intelligence Risk Management Framework (AI RMF 1.0)」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。