音声AIが部品になる日 ー Google新TTS2種が動かす、コールセンターの差別化点

Googleが2026年9月23日、音声合成の基盤モデル2種「Gemini 3.8 Flash TTS」「Gemini 3.8 Flash-Lite TTS」を開発者向けに公開した。Googleの公式発表によれば、両モデルは100以上の言語に対応し、自然言語プロンプトで新しい音声を設計できる。SiliconANGLEの報道では、Flash TTSが130言語、Flash-Lite TTSが101言語に対応し、2,000を超えるプリセット音声を持つとされる。ここで問いたいのは性能の高さではない。音声生成が「外から借りてくる部品」になったとき、コールセンター(コールセンター=コンタクトセンター)の何が変わるのか、である。
1. 何が発表されたのか、数字で押さえる
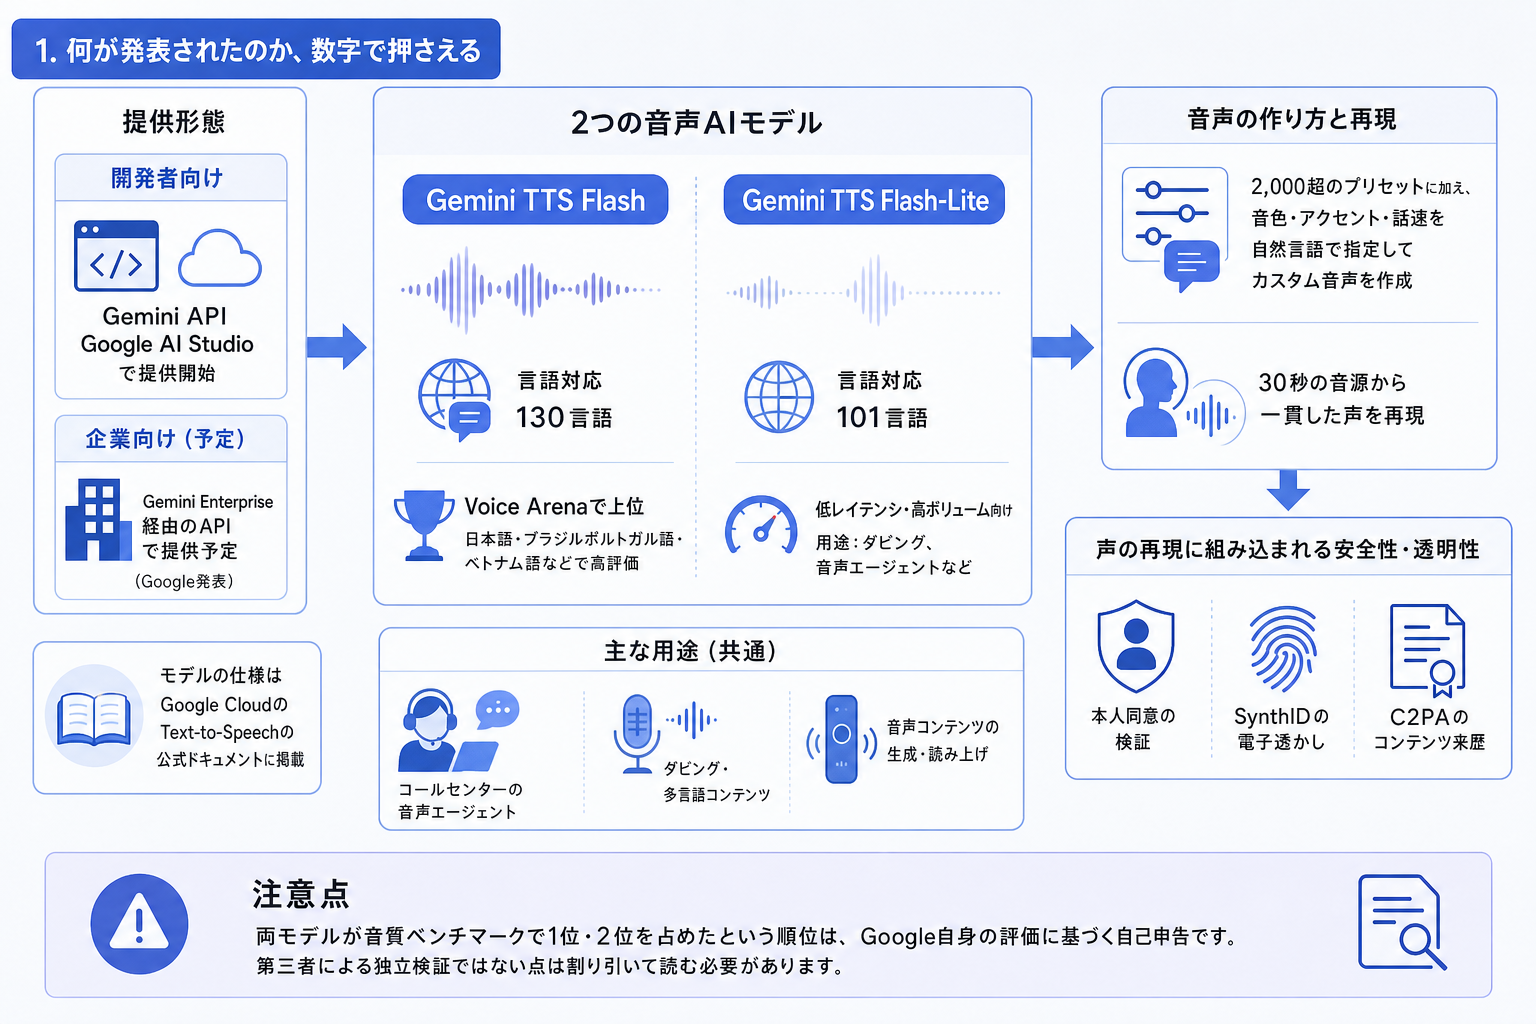
公表された事実を整理する。提供形態は、開発者向けにGemini APIとGoogle AI Studioで提供開始、企業向けはGemini Enterprise経由のAPIで提供予定とされる(Google発表)。言語対応はFlashが130、Flash-Liteが101。日本語やブラジルポルトガル語、ベトナム語などで、人間の主観評価に基づくベンチマークVoice Arenaで上位に入ったという。
音声は2,000超のプリセットに加え、音色・アクセント・話速を自然言語で指定してカスタム音声を作れる。さらに30秒の音源から一貫した声を再現できるとする。この声再現には、本人同意の検証、SynthIDの電子透かし、C2PAのコンテンツ来歴が組み込まれると説明されている。Flash-Liteは低レイテンシ・高ボリューム向けと位置づけられ、ダビングや音声エージェントが名指しの用途に挙がっている。モデルの仕様はGoogle CloudのText-to-Speechの公式ドキュメントにある。
なお、両モデルが音質ベンチマークで1位・2位を占めたという順位は、Google自身の評価に基づく自己申告である。第三者による独立検証ではない点は割り引いて読む必要がある。
2. なぜ重要か。音声が「部品」になる
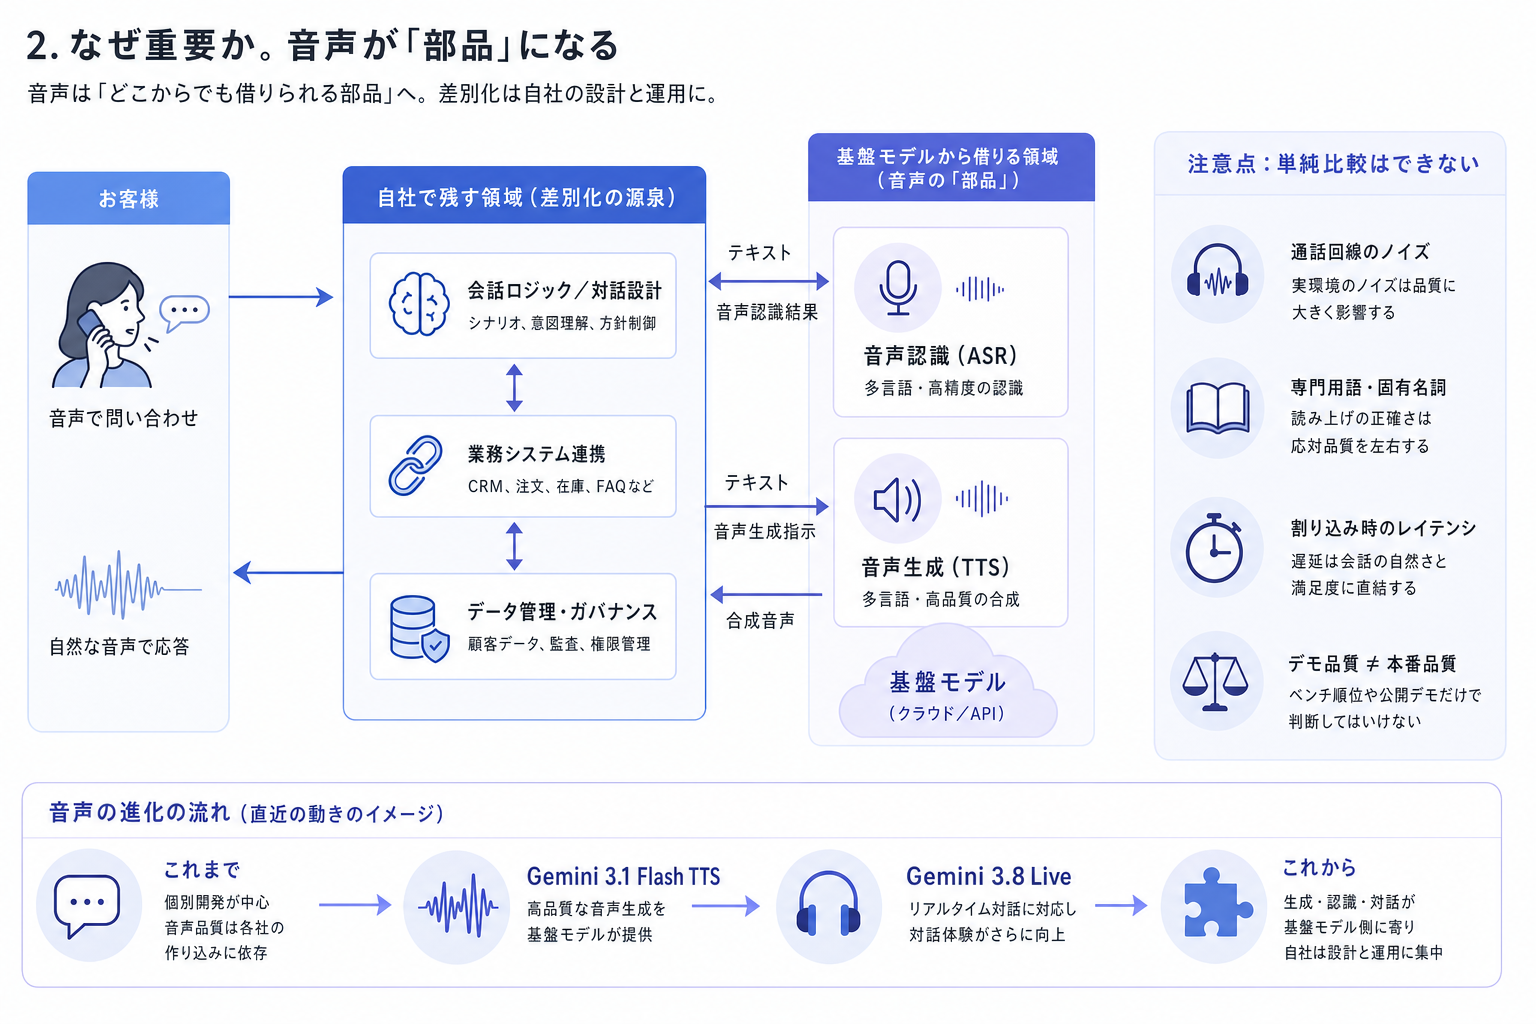
これまでボイスボットやAIオペレーターの音声品質は、各社の作り込みの差が出る領域だった。基盤モデルが多言語かつ高品質の音声生成を安価に提供すると、音声そのものは「どこからでも借りられる部品」に近づく。会話ロジック、業務システムとの連携、データ管理は自社側に残し、音声認識と生成だけを基盤モデルから借りる構成が現実的になる。
流れは今回が初めてではない。Googleは4月にもGemini 3.1 Flash TTSを公開しており、今回はその世代更新にあたる。9月にはリアルタイム対話向けのGemini 3.8 Liveも出ている。半年で音声の生成・認識・対話がそれぞれ基盤モデル側に寄っていく時系列が見える。
もっとも、単純比較には留保が要る。デモで示される品質と、本番運用の品質は別物である。実際のコールセンター環境では、通話回線のノイズ、専門用語や固有名詞の読み上げ、割り込み時のレイテンシが品質を左右する。ベンチ順位や公開デモだけで自社の応対品質を判断することはできない。
3. コールセンター現場への示唆
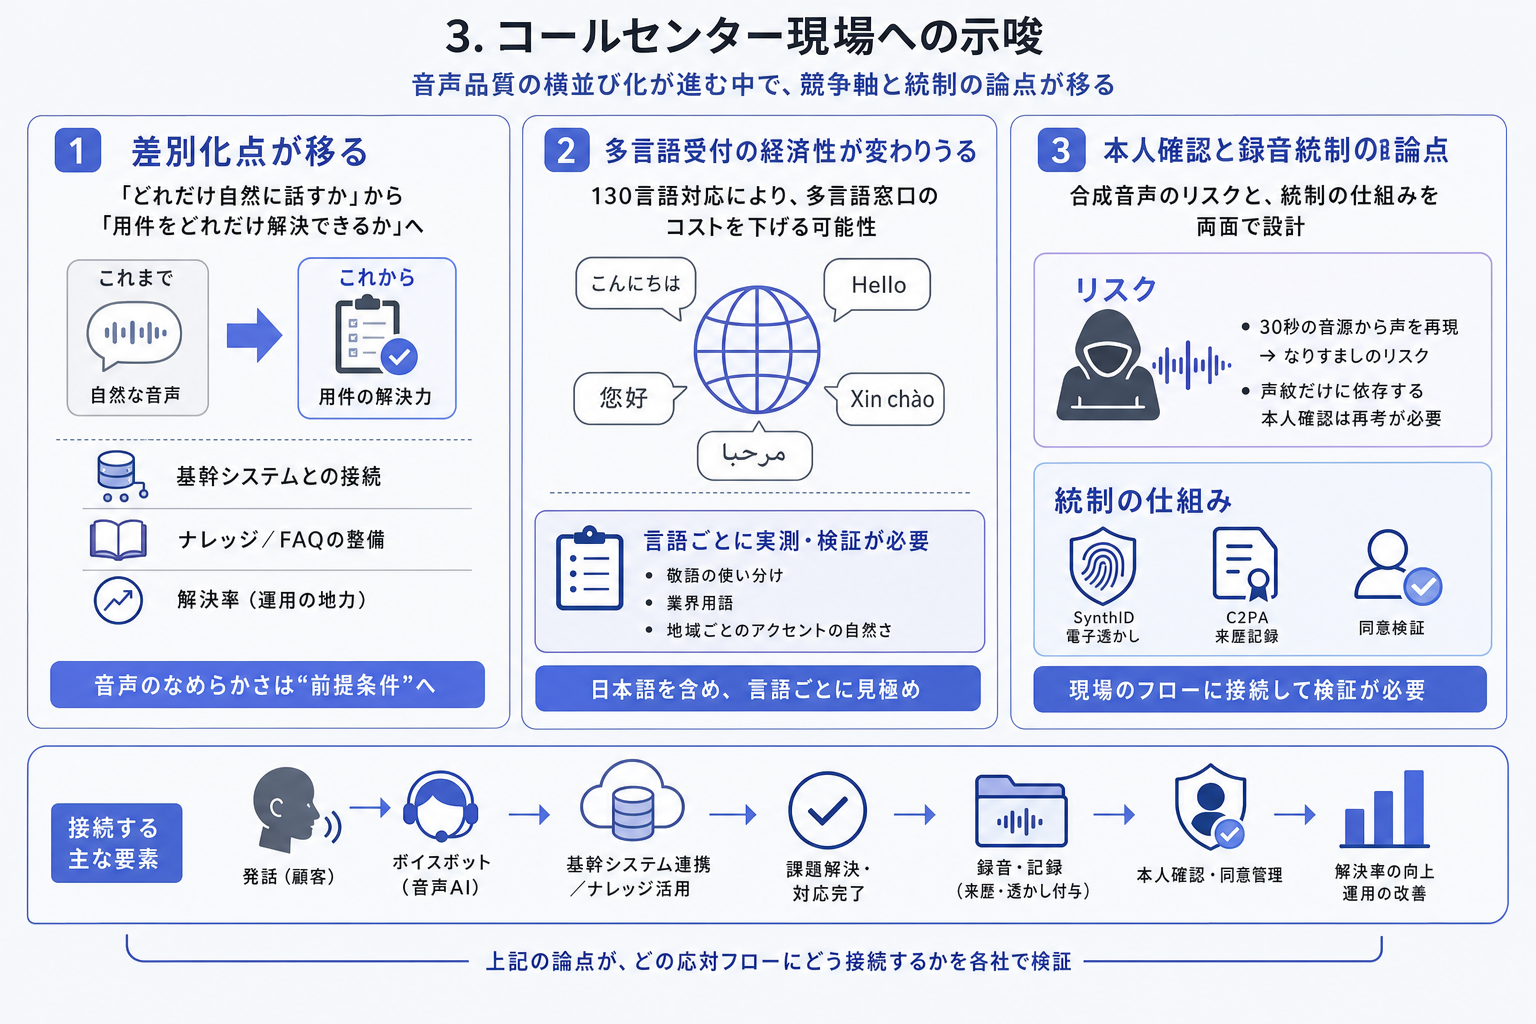
第一に、差別化点が移る。音声品質が各社横並びに近づくと、ボイスボットの勝負は「どれだけ自然に話すか」から「用件をどれだけ解決できるか」へ移る。基幹システムとの接続、ナレッジやFAQの整備、そして解決率という運用の地力が競争軸になる。音声のなめらかさを売りにしてきた設計は、前提条件に格下げされる。
第二に、多言語受付の経済性が変わりうる。130言語対応は、これまで人員確保が難しかった多言語窓口のコストを下げる可能性がある。ただし敬語の使い分け、業界用語、地域ごとのアクセントの自然さは、日本語を含め言語ごとに実測しないと判断できない。
第三に、本人確認と録音統制の論点が立ち上がる。30秒の音源から声を再現できる技術は、なりすまし音声のリスクを現場に突きつける。声紋だけに依存する本人確認は再考の対象になる。一方で、SynthIDの電子透かし、C2PAの来歴記録、同意検証が標準で組み込まれることは、合成音声である旨の開示や録音の来歴管理という統制側にも効く。これらが自社のどの応対フローに接続するかは、各社が検証すべき論点として残る。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。