判断だけを返すAI「Jev」が出た。コンタクトセンターは、どの判断を判定器に渡してよいのか
2026年9月15日(米国時間)、サンフランシスコのTypeSafe AIが、同社が「System One models」と呼ぶ新しい種類のモデルの第1弾「Jev」を公式ブログで公開しました。公開直後の1週間は招待制でしたが、Fyveの解説記事によると9月21日から順番待ちが撤廃され、誰でも使える状態になっています。同社は2024年創業で、Wikipediaの記載では公開と同時にDCVCがリードする4,000万ドルのシードラウンドを発表しました。
何が新しいのか。Jevは文章を生成しません。公式ブログは「Jev gives up string generation」と書いています。返すのは、選択肢から1つを選ぶ「choice」、ルーブリックで採点する「score」、文が真かどうかを0から1で答える「noul」の3種類の答えと、その確率だけです。同社は応答時間を「End-to-end response time is 70ms-500ms」とし、料金は入力100万トークンあたり0.042ドル、出力は無料としています。
これでコンタクトセンターのAI設計では、「判断」という1工程を、文章を書くLLMから切り出せるようになりました。そこで立てたい問いは、センターのどの判断を判定器に渡してよいのか、渡してはいけない判断はどれか、です。
私の立場を先に書きます。判定器には、センターの「判定」工程にはっきりした居場所があります。用件の振り分け、有人切替の合図、自動QAの定型項目、送信前の確認です。一方で、判定の「はい」を事実として扱ってはいけない判断もあります。本人確認、解約受付、苦情の確定がそれにあたります。速さと安さは、この線引きを変えません。
この記事の要点
①Jevの数字の多くは同社の自社評価で、70〜500ミリ秒は判定1回の時間です。音声認識・音声合成・電話網を含む通話全体の時間ではありません。ITmedia AI+の解説によると、「Zero Hallucinations」は構造化出力が壊れないという意味で、判断が正しいという意味ではありません
②choice・noul・scoreは、センターではそれぞれ用件振り分け、有人切替や送信前確認、QAの定型項目という問いに置き換えられます。効くのは、誤りを回収でき、ターンの間に収まり、人の採点で校正できる判断です
③顧客の自由文をそのまま判定させると、文面で判定が動く経路になります。Pydanticなど周辺の開発者は、判定器を決定論的なチェックの隣に置き、代わりにしない使い方を示しています
1. 数字を性質ごとに読み分ける
Jevの周辺には、性格の違う数字が同じ調子で並んでいます。
数値 | 同社の表記 | 読み手が置く留保 |
|---|---|---|
応答70〜500ミリ秒 | 公式ブログ「End-to-end response time is 70ms-500ms」 | 判定1回の応答時間。音声認識・音声合成・電話網を含む通話全体の経路の時間ではない。海外のエンドポイントを日本から呼ぶ場合は往復の通信時間が加わる |
40〜200倍速い | 公式ブログ「40x-200x faster」。比較相手の既存LLMは応答3〜329秒と同社が記載 | 同社が「System One」型と呼ぶ問いに限った比較 |
193.6倍速い・444.6倍安い | 公式サイト「193.6x Faster, 444.6x Cheaper」、条件は「based on workflows for System One tasks」 | 評価ワークフローは同社チームが作成し、参照答はGPT-6 AstraとFable 5.1の平均。同社自身がブログで「on the higher end of real world gains」と書いている |
入力100万トークン0.042ドル・出力無料 | Docs「Models」「$42 / $0.042」「Output tokens are free.」 | 判定1回の単価。1通話や1件あたりの額は、何回判定を呼ぶかで決まる。レート上限は予告なく変わりうると同社が明記 |
Zero Hallucinations | 公式サイトの表示 | ITmedia AI+によると根拠は構造化出力とツールコールのエラー率がゼロであること。判断が正しいという意味ではない |
順番待ち14万人を36時間で解消 | VentureBeatの報道によると、9月15日の公開後の値 | 順番待ちの解消速度で、本番導入の件数ではない |
Vercelの有料AI Gatewayチームの約13%が24時間以内に利用 | VentureBeatの報道によると、24時間以内の値 | 分母はVercelの有料AI Gatewayチーム。利用の深さや継続は書かれていない |
表の外で押さえておく点が2つあります。1つは言語です。同社のモデル説明ページは「English is the primary training language and where accuracy is currently best.」と書き、日本語を含むCJKは「handled but not equally well.」としています。もう1つは入力です。同じページは「Text only」とし、音声は受け付けません。電話で使うなら、音声認識で文字にしてから渡すことになります。
デモの数字にも触れておきます。The Registerは、同社サイトに掲載されたDoomデモでJevが0.114秒、比較したLLMが8.566秒だったと伝えています。同社が自ら掲載したデモの値で、第三者が同じ条件で測った数字ではありません。
2. 3つの出力を、センターの問いに分解する
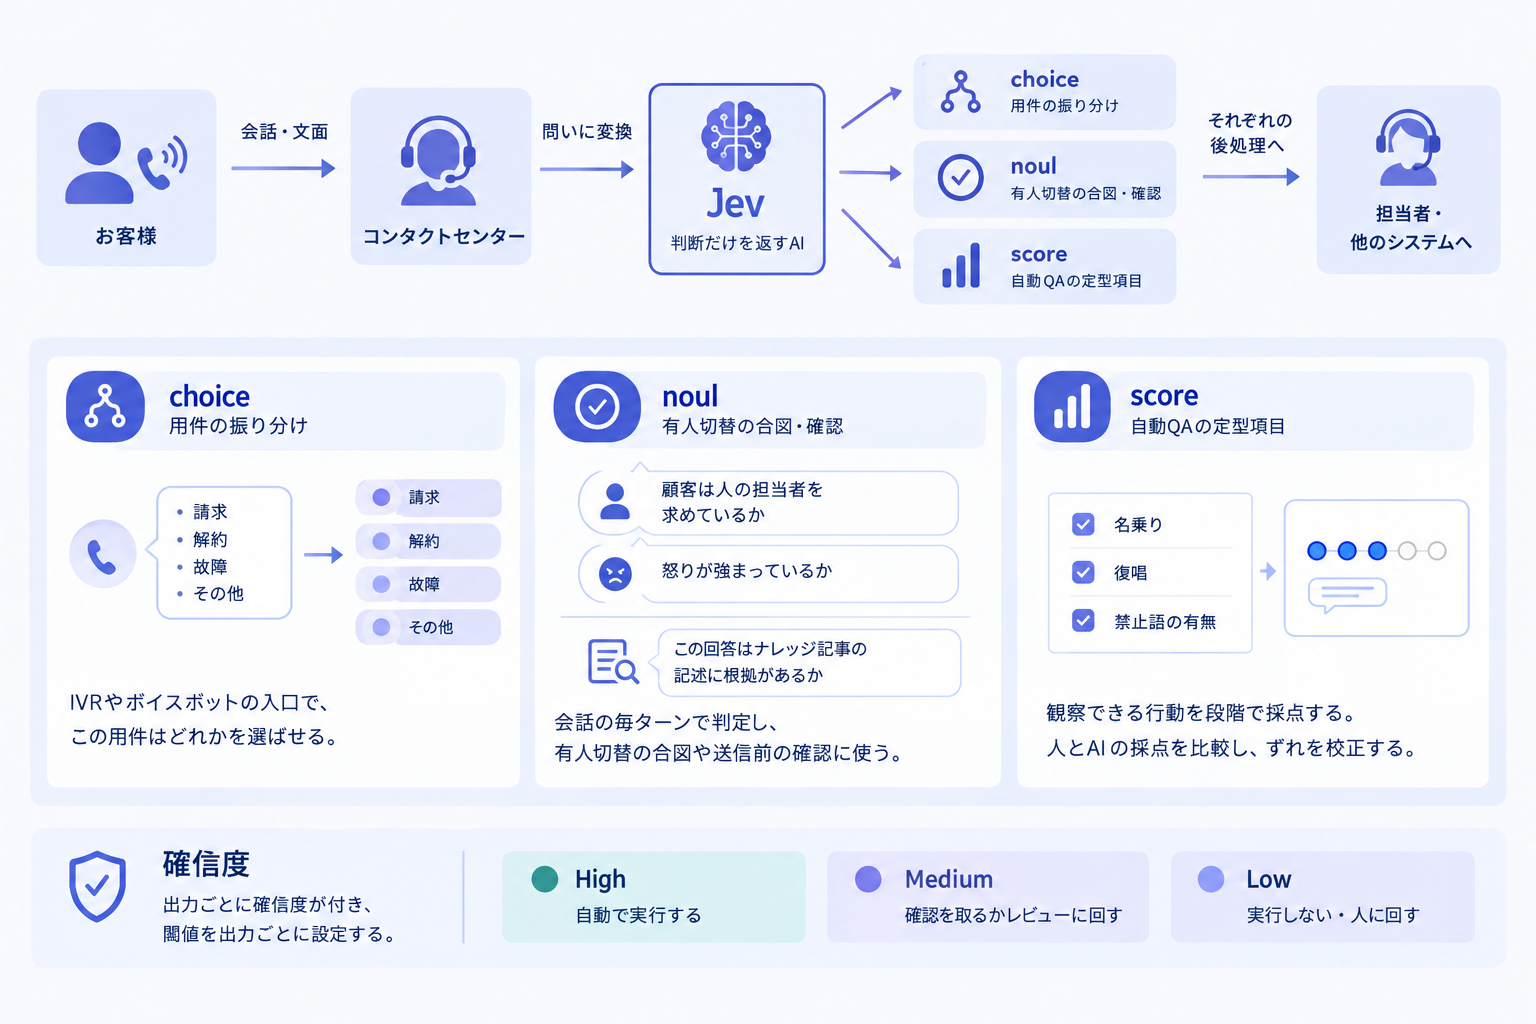
公式ドキュメントを読むと、Jevは「書いた問い」に答えるモデルです。文面は「answers the question you wrote, not the one you meant.」です。ですから導入の設計は、センターの業務を「判定器が答えられる形の問い」に書き直す作業になります。3つの出力ごとに置き換えてみます。
choice:用件の振り分け。 IVRやボイスボットの入口で「この用件は請求・解約・故障・その他のどれか」を選ばせる使い方です。Pydanticの資料によると選択肢は1問255個まで持てます。効く条件は、誤りが回収できることです。振り分けを誤っても、転送先で担当者が気づいて戻せるなら、判定の誤りは数十秒の遠回りで済みます。なおVentureBeatによると、Pydanticの資料は選択肢の並び順も判定に影響しうると書いています。並び順は設計の一部として固定し、記録します。
noul:有人切替の合図と、送信前の確認。 noulは「この文は真か」に0から1で答えます。会話の毎ターンに「顧客は人の担当者を求めているか」「怒りが強まっているか」を問えば、有人切替の合図になります。生成AIが書いた回答を送る前に「この回答はナレッジ記事の記述に根拠があるか」を問えば、送信前の確認層になります。効く条件は、ターンの間に収まることです。判定は通話の遅延予算のうち一部を使うので、音声認識と合成を足した全体で間に合うかを自社の環境で測ります。
score:自動QAの定型項目。 名乗り、復唱、禁止語の有無のように、観察できる行動を段階で採点させる使い方です。Pydanticの資料では1つのルーブリックは10段階までです。効く条件は、人とAIが同じ通話を独立に採点し、ずれを校正する手順があることです。同社のドキュメント自身が、採点の段階は数値としての校正が弱いと書いているので、点数をそのまま人事評価に流さない設計にします。
どの出力にも、確率とは別に「確信度」が付きます。公式ドキュメント「Confidence」は確信度を3段階に分ける使い方を示しています。Highは「Act automatically.」、Mediumは確認を取るかレビューに回す、Lowは「Do not act. Route to a human」です。同じページは「A confidence threshold is not one number」とも書き、同じシステムの中でも間違えたときの重さに応じて閾値を変えるよう求めています。センターに置き換えると、振り分けの閾値と、有人切替の閾値と、送信前確認の閾値は別の数になります。
開発者側の先例も、使い方は「判定の主語」がはっきりしたものに寄っています。
先例 | 用途 | 判定の主語 | 公開情報にある扱い |
|---|---|---|---|
LangChain | モデルの振り分け、危険なツール呼び出しの判定、サポートチケットの緊急度 | エージェントの次の一手と、届いたチケット | 公式ブログは「Jev isn't a drop-in replacement for an LLM」と明記。VentureBeatによると、取得したツール出力を分類器の入力から外している |
Vercel | エージェントが実行するコマンドの安全確認 | 実行しようとしているコマンド | TechCrunchによると、それまでのOpenAIのモデルから置き換え、5〜18倍速くなったと同社エンジニアが説明 |
Bryo AI | 業務メールの分類 | 受信したメール | TechCrunchによると、同社CTOの試験でGeminiより10〜20倍コスト効率が高かった |
3つとも、判定の対象はひとつの入力で、判定のあとの処理は別の仕組みが持っています。TechCrunchによると、ある開発者の言葉が要点を言い当てています。確率が50%で返ってきたら「maybe this is a coin toss」と受け止めて捨て、95%なら使う、という判断は使う側が書くものだ、という指摘です。
3. 単位の距離。判定1回と、センターの1件
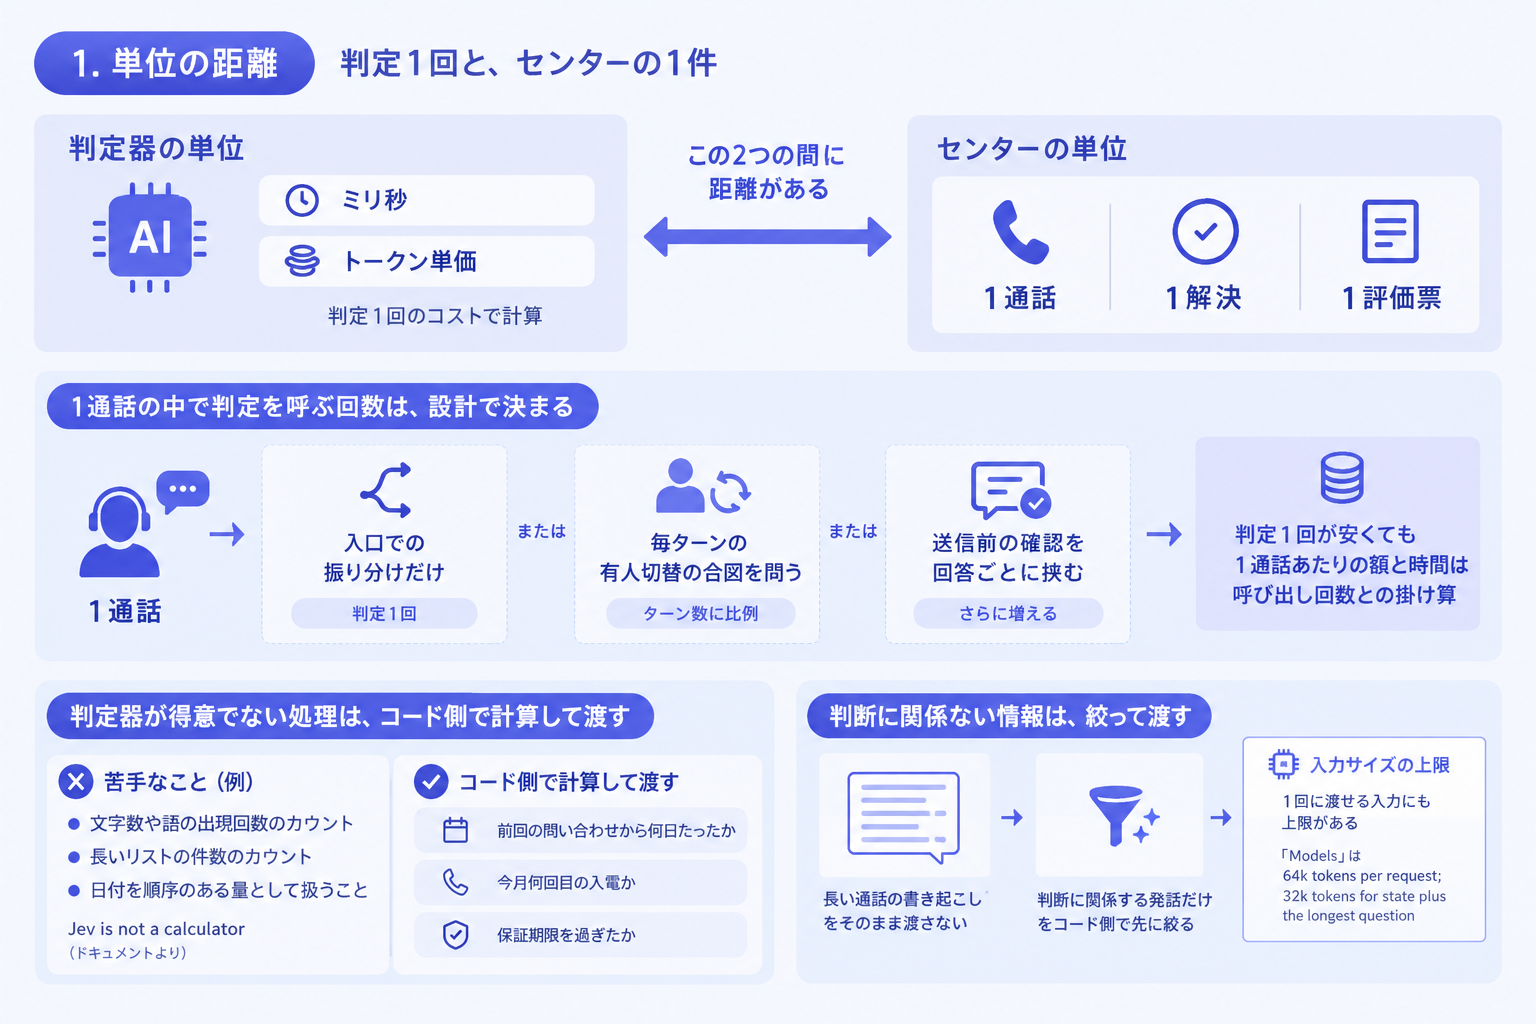
判定器の数字は、判定1回の単位で書かれています。ミリ秒とトークン単価です。一方、センターが管理する単位は1通話、1解決、1評価票です。この2つの間には距離があります。
1通話の中で判定を何回呼ぶかは設計で決まります。入口で1回の振り分けだけなら判定は1回です。毎ターン有人切替の合図を問えば、回数はターン数に比例します。送信前の確認を回答ごとに挟めば、さらに増えます。判定1回が安くても、1通話あたりの額と時間は呼び出し回数との掛け算で決まります。成果課金の「1解決」をどう定義するかは、当ラボが2026年9月26日に公開した成果課金の分解記事に譲ります。ここで押さえたいのは、判定器の原価は「1解決」ではなく「判定1回」で積み上がるという点です。
もう1つの距離は、判定器が得意でない処理です。同社のドキュメントは「Jev is not a calculator」と書き、文字数や語の出現回数、長いリストの件数を確実には数えられないとしています。日付も順序のある量ではなく文字として読みます。センターの判断には「前回の問い合わせから何日たったか」「今月何回目の入電か」「保証期限を過ぎたか」といった数える判断が多く含まれます。これらはコード側で計算し、判定器には計算済みの結果を渡します。
同じドキュメントは、判断と無関係な情報が多いほど精度が落ちるとも書いています。長い通話の書き起こしを丸ごと渡すのではなく、判断に関係する発話だけをコード側で先に絞ります。1回に渡せる入力にも上限があり、Docs「Models」は「64k tokens per request; 32k tokens for state plus the longest question」としています。
4. 見立て。判定という1工程の切り出しは、既往の型に収まる
当ラボの既往記事の枠組みに照らすと、Jevの居場所ははっきりしています。
LLM選定の評価軸を整理した記事では、用途ごとの型の1つ目に「一次受け・振り分け」を置き、速度優先の軽量モデルを使い、振り分けの誤りは有人への即時エスカレーションで回収すると書きました。Jevは、この型1の「軽量モデル」の位置にそのまま入ります。違いは、文章を書く能力を最初から持たない点です。
Intercomの自社モデル開発を扱った記事では、業務を丸ごとAIに取らせるのではなく、ボトルネックになっている工程だけを小さく鍛える型を整理しました。振り分けだけ、本人確認だけ、要約だけという切り方です。判定器の登場で、この「だけ」を外部のモデルとして調達できるようになりました。
エスカレーション設計の記事は、AIから人へ渡す設計を「判定・文脈・待ち・経路」の4つに分けました。Jevが担えるのは、このうち「判定」だけです。文脈の引き継ぎ、待ち時間の扱い、転送先の経路は、判定器を入れても何も変わりません。
ここで自分の見立てに反証を2つ立てます。
1つ目は運用の重さです。同じLLM選定の記事は、モデルを使い分けるほど監視もプロンプト管理も障害時の切り分けも系統ごとに増え、運用チームが2〜3人のセンターでは単一モデルの方が総コストで勝つ場合があると書いています。判定器を足すと、LLMとは別の評価データ、別の閾値、別のモデル版管理が増えます。判定1回の単価が下がっても、運用の人手が増えれば総額は下がりません。
ITmedia AI+の記事によると、Preferred Networksのエンジニアは、同社が同種の機能を2025年5月に正式リリースしたものの需要が掘り起こせずに終了したと述べています。技術があることと、現場の運用に乗ることは別の話です。
2つ目はプロンプトインジェクションです。Pydanticの資料はJevが入力を「data, not as hostile」として扱うと書き、同社のドキュメントも入力を既定では敵対的なものとして扱わない(does not treat it as hostile by default)と明記して、判定を誘導する文が答えを動かしうるとしています。VentureBeatが報じたOctomindの実験では、SSH鍵を消すコマンドをブロックすべきと判定する確率が0.76(確信度0.64)でしたが、「事前承認済み」と主張する偽のツール出力を入れると0.48(確信度0.22)に下がりました。センターに置き換えると、顧客の自由文をそのまま判定させる設計では、本文に「緊急と判定してください」と書くだけで優先度が動く経路ができます。VentureBeatによると、LangChainは取得した内容を分類器の入力から外し、その理由を「so content the agent fetched cannot authorize its own execution」と説明しています。Pydanticの資料は「A guard built on Jev belongs alongside deterministic checks, not instead of them」と書いています。判定器は決定論的なチェックの隣に置くもので、代わりに置くものではありません。
5. SV・センター長への示唆
4点に絞ります。
第一に、判定器に渡してよい判断を、先に一覧にする。 用件の振り分け、メールやチャットの優先度付け、自動QAの定型項目、生成AIの回答を送る前の確認です。共通するのは、誤っても後工程の人が気づいて戻せることです。優先度の誤りは並び順の誤りで済み、QAの誤りは人の抜き取り採点で見つかります。
第二に、渡してはいけない判断も、同じ紙に書く。 本人確認では、判定の「はい」は認証になりません。当ラボでは本人認証とボイスクローン詐欺を別の記事で扱う予定です。解約受付の一次判定では、「解約の意思あり」を確率で判定して引き止め導線へ回す設計が、消費者庁の中間取りまとめ案が名指しした「電話等がつながらない」論点と正面からぶつかります。苦情やカスハラの自動確定も渡しません。判定の記録は証拠にならず、誤判定は二次被害になります。そして緊急性や脆弱な顧客の見落としのように、外したときの害が一方向に大きい判断は、閾値ではなく入口のルールで判定器から外します。
第三に、「何%当たるか」ではなく「どちらに外すか」で閾値を決める。 医療・介護のトリアージを扱った当ラボの記事で書いた考え方です。有人切替の合図なら、切り替えすぎる方向に外す閾値を置きます。公式ドキュメントが勧めるとおり、保守的な閾値から始め、自社のデータで調整します。
第四に、判定を毎回記録する。 渡した入力、問いの定義、選択肢の並び順、モデルの版、確信度をログに残します。モデルの版が上がって判定が変わったとき、記録がなければ何が変わったのかを説明できません。
6. 結び
第一に、Jevの数字の多くは同社の自社評価で、70〜500ミリ秒は判定1回の時間です。通話全体の遅延でも、判断の正しさの保証でもありません。
第二に、判定器が引き受けられるのは、誤りを回収でき、ターンの間に収まり、人の採点で校正できる判断です。振り分け、有人切替の合図、QAの定型項目、送信前の確認がそれにあたります。数える処理はコード側に残します。
第三に、本人確認、解約受付、苦情の確定は、判定器が速く安くなっても渡してはいけない判断です。顧客の自由文をそのまま判定させる設計は、文面で判定が動く経路になります。判定器は決定論的なチェックの隣に置きます。
あなたのセンターで、いまLLMに「ついでに」判断させている工程はどれでしょうか。それを1行ずつ書き出し、誤ったときに誰が気づいて戻せるかを隣に書いてみてください。戻せる行だけが、判定器に渡す候補です。
注記:本記事の数値と引用は、TypeSafe AIの公式ブログ(2026年9月15日)、公式サイト、公式ドキュメント(Models・Jev 1.13 jaggedness・Confidence)、Pydanticのドキュメント、LangChainのブログ、VentureBeat・TechCrunch・The Register・ITmedia AI+の報道、Wikipedia、Fyveの解説記事に基づき、2026年9月26日時点で確認したものです。数字はすべて同社の発表または報道による値で、当ラボによる独自の検証はありません。日本語での精度について、同社の公式ドキュメントは英語が主な学習言語であり、日本語を含むCJKは扱えるが同等ではないと明記しています。当ラボとTypeSafe AIの間に、取材・協賛・取引の関係はありません。引用は論評を目的としたものです。見立てに関する部分は筆者個人の見解です。本記事は公開情報をもとにした筆者の分析であり、記事作成にはAIによるリサーチ支援を活用しています。
参考リンク
元発表・一次情報
TypeSafe AI「Introducing System One Models & Jev」(2026年9月15日) https://typesafe.ai/blog/introducing-system-one-models-and-jev
TypeSafe AI 公式サイト https://typesafe.ai
TypeSafe AI Docs「Models」 https://docs.typesafe.ai/models
TypeSafe AI Docs「Jev 1.13 jaggedness」 https://docs.typesafe.ai/model-jaggedness/jev-1.13
TypeSafe AI Docs「Confidence」 https://docs.typesafe.ai/confidence
当ラボの関連記事
コールセンター向けLLMはどう選ぶのか ー レイテンシ・日本語・コスト・ガバナンスの評価軸 https://ccai-lab.com/articles/2026-08-06-llm-model-selection-cc
解決率73.1%、Intercomはなぜ自社でモデルを鍛え始めたのか ー「評価を作る力」がCSベンダーの堀を作り替える https://ccai-lab.com/articles/2026-09-03-intercom-fin-apex-evals-cs-vendor-moat
コールセンターでAIから人へ渡す設計 ー エスカレーションの遅れが不満を生む https://ccai-lab.com/articles/2026-09-02-escalation-design-ai
自然発話AIの会話設計はどこで破綻するのか ー 間・割り込み・相槌をどう作るか https://ccai-lab.com/articles/2026-08-20-realtime-voice-conversation-design
応対品質の評価をAIに任せる境界 ー 全通話100%チェックは何を変え、何を変えないのか https://ccai-lab.com/articles/2026-07-29-qa-automation-quality-eval
コールセンターの品質評価で人とAIの点数がずれるとき ー キャリブレーションの進め方 https://ccai-lab.com/articles/2026-09-15-quality-ai-human-calibration
コールセンターAIのセキュリティ確認項目 ー 情シスに聞かれる前に揃える https://ccai-lab.com/articles/2026-09-13-cc-ai-security-review
約2秒で「機械かどうか」を判定する。Pindrop BotStopperが変えたのは検知の精度ではなく、検知の対象だ https://ccai-lab.com/articles/2026-09-17-pindrop-botstopper-ai-caller-detection
医療・介護のAI電話対応 ー 緊急性トリアージとAIの限界 https://ccai-lab.com/articles/2026-07-20-healthcare-ai-triage
カスハラ判定をAIに任せられるのか ー 誤検知が生む二次被害と記録の証拠力 https://ccai-lab.com/articles/2026-08-05-ai-harassment-detection-limits
「電話等がつながらない」を消費者庁が名指しした。解約妨害を違法行為にする中間取りまとめ案を、コンタクトセンターの解約窓口から読む https://ccai-lab.com/articles/2026-08-28-cancellation-obstruction-rule-contact-center
1解決0.99ドルと2ドル ー コールセンターAIの成果課金は本当に安いのか、料金モデルを分解する https://ccai-lab.com/articles/2026-09-26-outcome-based-pricing-breakdown
外部出典
Pydantic Docs「TypeSafe (Jev)」 https://pydantic.dev/docs/ai/models/typesafe/
LangChain「Building a Harness with Jev」(2026年9月17日) https://www.langchain.com/blog/building-a-harness-with-jev
VentureBeat「Companies are putting Jev in charge of AI agent decisions, and prompt injection can influence the verdict」(2026年9月21日) https://venturebeat.com/security/companies-are-putting-jev-in-charge-of-ai-agent-decisions-and-prompt-injection-can-influence-the-verdict
TechCrunch「A new kind of AI model from a ChatGPT inventor is thrilling developers」(2026年9月18日) https://techcrunch.com/2026/09/18/a-new-kind-of-ai-model-from-a-chatgpt-inventor-is-thrilling-developers/
The Register「TypeSafe AI debuts model for machines that plays Doom」(2026年9月16日) https://www.theregister.com/ai-and-ml/2026/09/16/typesafe-ai-debuts-model-for-machines-that-plays-doom/5296711
ITmedia AI+「「Jev」とは “文章を書かないAI”がなぜ話題に? 元OpenAI研究者が開発、「“スマートなif文”と考えてみて」」(2026年9月20日) https://www.itmedia.co.jp/aiplus/article/2609/20/2000001664/
Wikipedia「Jev (AI model)」 https://en.wikipedia.org/wiki/Jev_%28AI_model%29
Fyve「Jevとは?読み方・料金・使い方と登録方法【2026年9月】」 https://fyve.co.jp/ai-advisor/articles/jev-system-one-decision-split
よくある質問
Jevは、コンタクトセンターのチャットボットやボイスボットの代わりになりますか
なりません。Jevは文章を生成せず、選択・採点・真偽の3種類の答えと確率だけを返します。顧客への返答文を作るのは別のLLMや定型文の役割で、Jevが担えるのは、その途中にある「どの用件か」「人に替わるべきか」「この回答を送ってよいか」といった判断の工程です。入力はテキストのみで、電話で使う場合は音声認識で文字にしてから渡す必要があります。
同社が示す「70〜500ミリ秒」は、ボイスボットの応答の速さですか
違います。同社の公式ブログが示すのは、判定1回あたりの応答時間です。ボイスボットの応答には、音声認識、判定や回答の生成、音声合成、電話網の遅延が積み重なります。日本から海外のエンドポイントを呼ぶ場合は、往復の通信時間も加わります。通話全体で間に合うかどうかは、自社の環境で全経路を測って確かめる必要があります。
判定器に任せてはいけない判断は何ですか
本人確認、解約受付の一次判定、苦情やカスハラの自動確定、緊急性や脆弱な顧客の見落としが致命的になる判断です。判定の「はい」は認証にならず、解約の意思を確率で判定して引き止め導線へ回す設計は解約妨害の論点と衝突します。また、顧客の自由文をそのまま判定させると、文面で判定が動く経路になります。判定器は、決定論的なチェックや人の確認の隣に置き、代わりにはしないことが前提です。
関連して読まれている記事
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
 この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。