コールセンターAIのベンダーデモは何を見れば比べられるのか

「AIベンダー数社のデモを見たが、正直どこも良く見えて違いが分からない」。ベンダー選定の相談で最も多く聞く言葉のひとつです。先に結論を書くと、各社が自分で用意したシナリオのデモは、そもそも比べるための材料になっていません。比べたいなら、自社の代表的な用件を匿名化した共通の質問と条件をこちらから渡し、成功だけでなく失敗と手直しまで記録する。この一手間が要ります。Gartnerの2025年6月の予測では、エージェント型AIプロジェクトの4割超が2027年末までに中止されるとされており、理由にはコスト増と並んで「ビジネス価値が不明確」が挙がっています。価値が不明確なまま契約に進む入口が、比べられないデモだと私は見ています。
なぜ各社が用意したデモでは比べられないのか
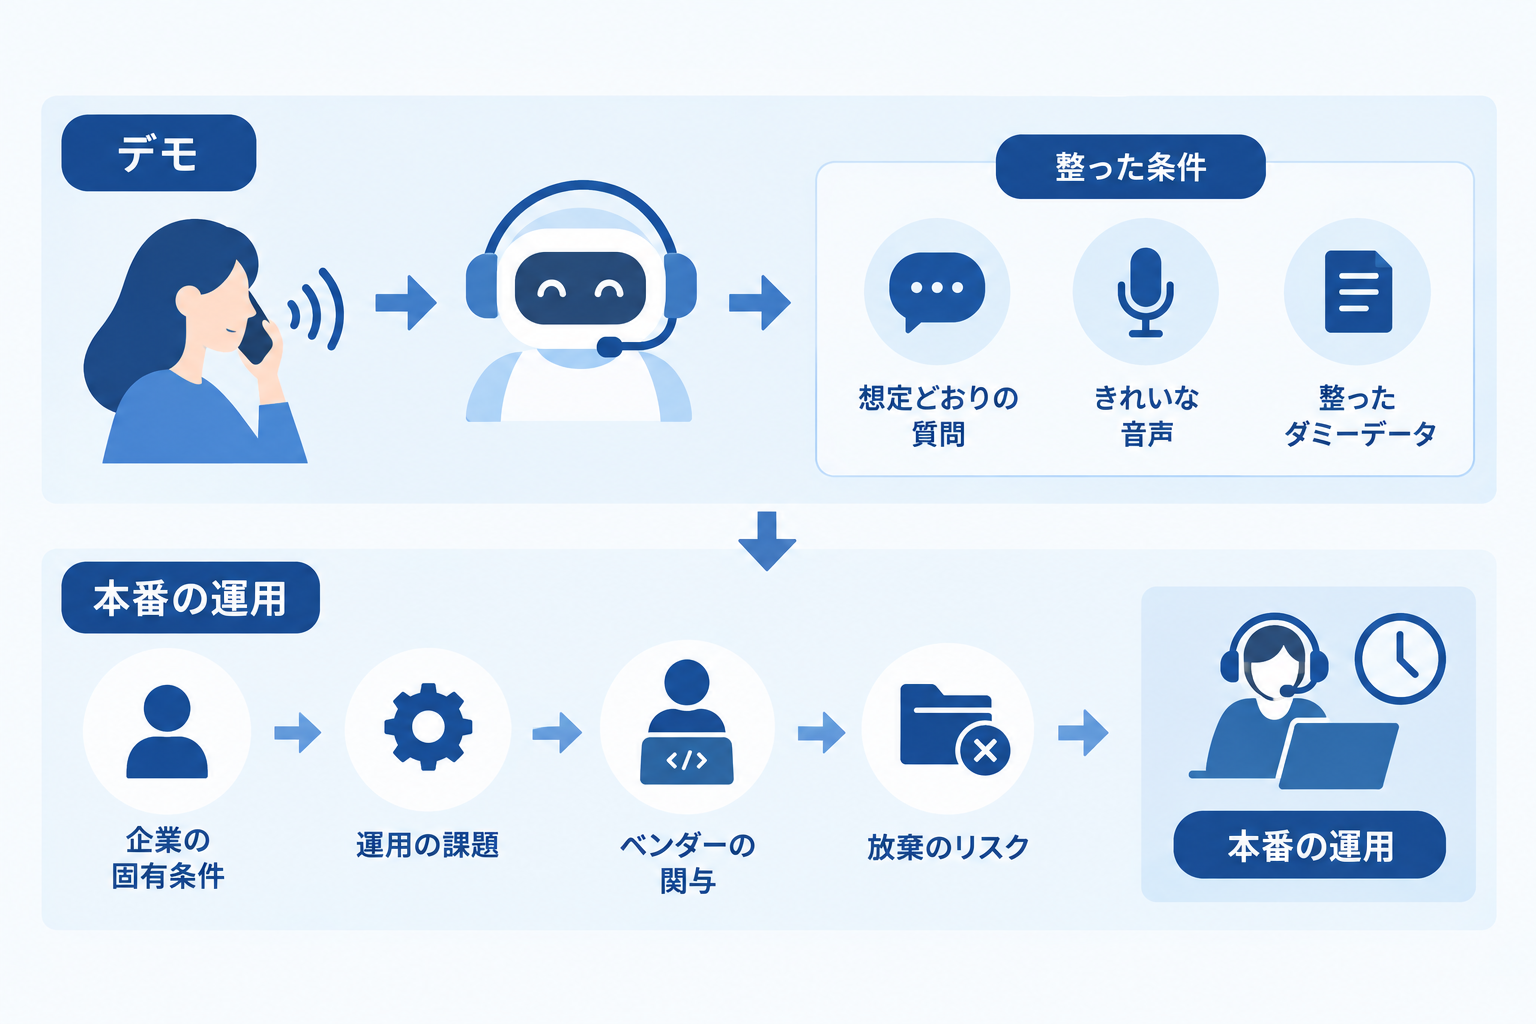
デモは各社の得意な場面だけを通る道で作られています。想定どおりの質問、きれいな音声、整ったダミーデータ。この条件なら、どのベンダーの製品もよどみなく答えます。国内でAIオペレーター基盤を手がけるRightTouchの長崎大都氏は、ASCIIの2026年4月の記事で「デモ映えするそれっぽいAIオペレーターは誰でも作れる」と言い切り、差が出るのは運用だと指摘しています。
デモの出来と本番の成果が別物であることは、数字にも出ています。MITの研究チームが2025年8月に出した調査では、企業の生成AIパイロットのうち損益への効果を出せたのは約5%にとどまりました。デモからPoC、PoCから本番へと進むたびに、デモでは見えなかった自社固有の条件が効いてくるためです。
もうひとつ、デモの作り手の問題があります。Gartnerは2026年9月の予測で、ベンダーのエンジニアが企業側に入り込んで作ったエージェント型AIの7割が2028年までに放棄されると見ています。ベンダーの手がどこまで入ったデモかを確かめずに「動いた」と評価すると、その手が抜けた後の運用で同じものは動きません。営業資料の確認点を以前整理しましたが、デモはその資料よりさらに演出の自由度が高い媒体です。
共通の質問と条件をどう渡すのか
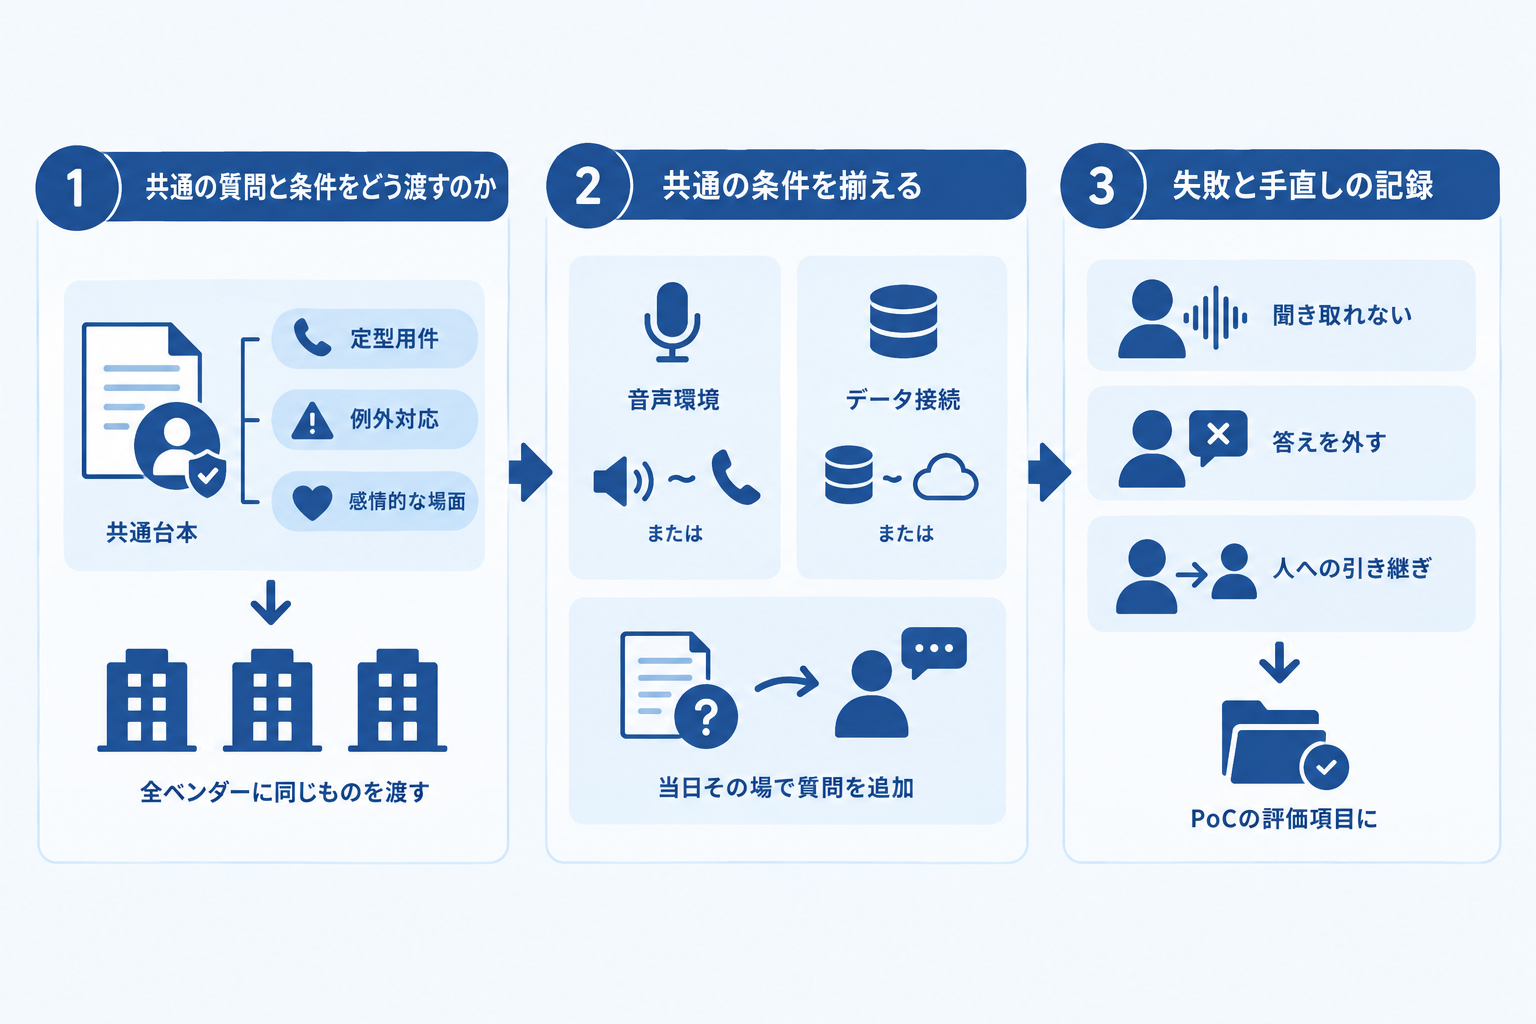
やることは3つだけです。
1つ目は、自社の代表用件を匿名化した共通台本にすることです。呼量の多い定型用件を2〜3問、例外対応を2〜3問、言い直しや割り込みが起きる感情的な場面を1〜2問。実際の問い合わせから顧客情報を外して作り、全ベンダーに同じものを事前に渡します。各社のシナリオの土俵ではなく、自社の用件の土俵で揃えるためです。ボイスボットの評価軸の整理で完結率だけで決めると失敗すると書きましたが、台本を自社用件にしないと、その完結率すらデモでは各社バラバラの分母で示されます。
2つ目は、条件を揃えることです。音声なら同じ環境(スピーカー越しか、電話回線経由か)、データ接続なら同じ前提(ダミーCRMに接続するのか、しないのか)を指定します。そのうえで、台本にない質問を当日その場で1〜2問足す。事前に渡した台本だけだと、台本への作り込み合戦になるからです。
3つ目は、失敗と手直しの記録です。ここが一番の差になります。聞き取れなかったとき、答えを外したとき、人への引き継ぎが要るとき、それぞれどう振る舞ったか。外したこと自体は減点ではありません。むしろ全問正解のデモの方が、台本が事前に漏れていたか、作り込まれていたかを疑う材料になります。記録した挙動は、そのままPoCの評価項目と合格基準の下書きになります。
実演のない提案はどう扱うのか
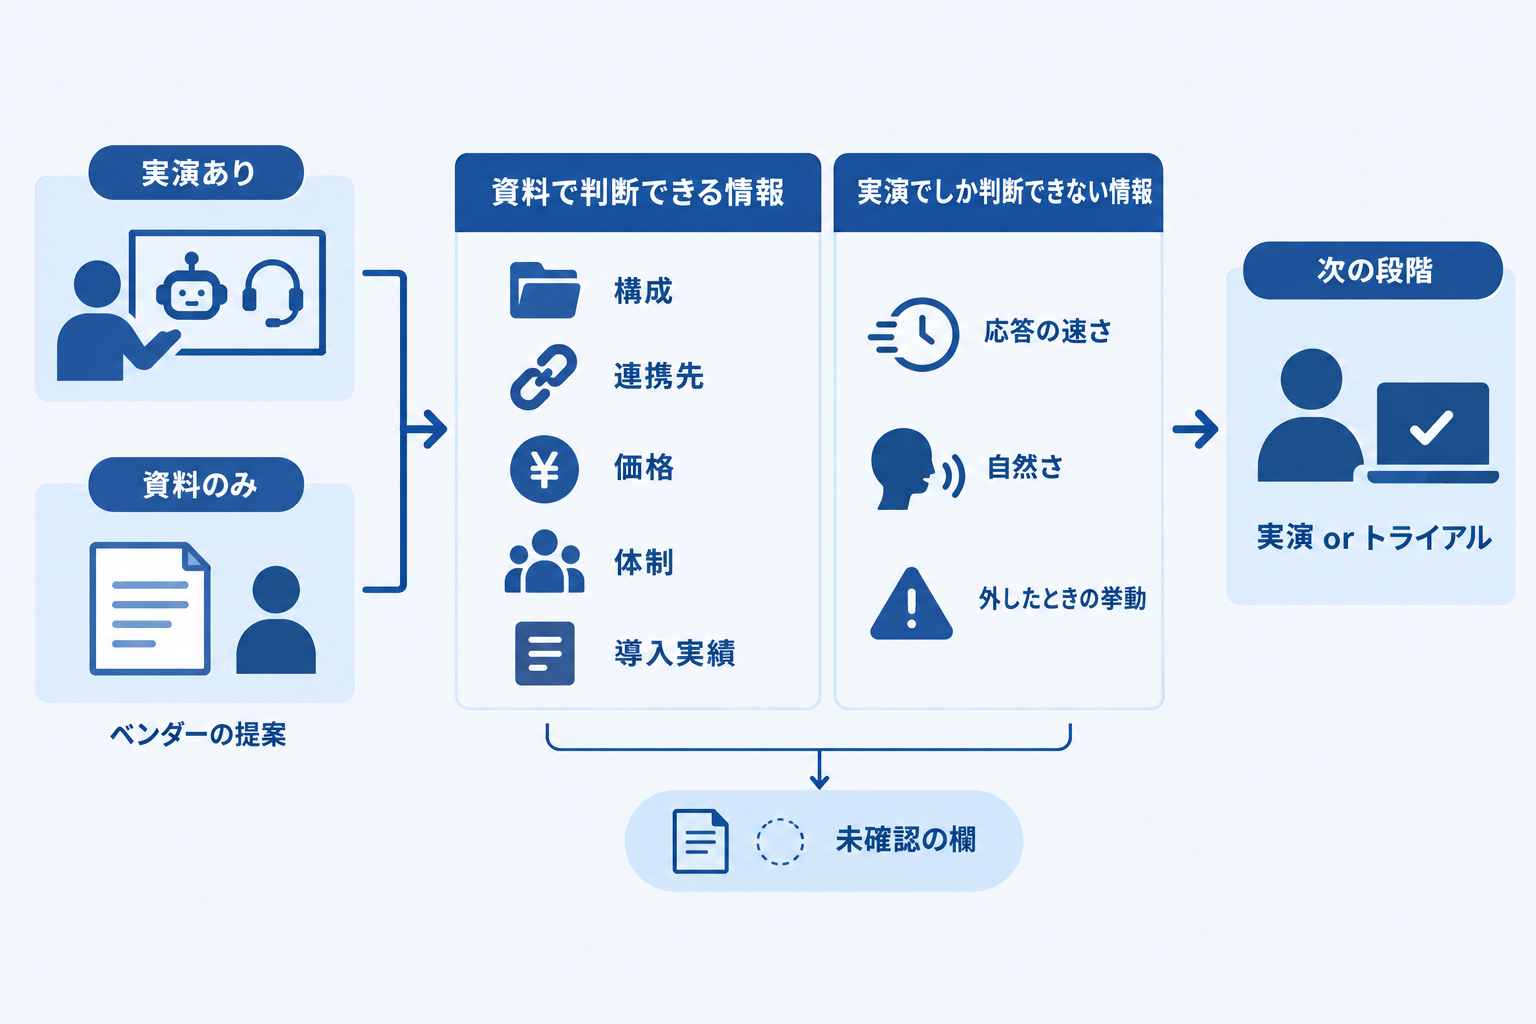
比較の席に、デモなしの資料提案が混ざることがあります。このとき「実演がない=機能がない」と読むのは誤りです。提案のタイミングや商談の段取りで実演を省くベンダーは普通にあり、ある時点のセッションで実演がなかったという事実は、現在その機能がないことを意味しません。
扱い方は、提案を2つに分けることです。資料で判断できるのは、構成、連携先、価格、体制、導入実績といった構造の情報。実演でしか判断できないのは、応答の速さや自然さ、外したときの挙動といった体験の情報です。前者は資料で評価し、後者は「未確認」として空欄のまま残す。未確認の欄が埋まらないベンダーには、次の段階で実演かトライアルを条件にすれば済みます。空欄を印象で埋めた瞬間に、比較表は事実の表ではなくなります。
自社のセンターで確かめること
デモ比較は選定の入口にすぎず、ここで決め切る必要はありません。ただ、共通台本と失敗の記録を入口でやっておくと、PoCの設計も本番後の評価も同じ物差しで続けられます。逆に入口が各社シナリオのままだと、PoCの合格基準も各社の得意分野に引きずられると見ています。
自己反証をひとつ書いておくと、台本を固めすぎると各社の設計思想の違いから生まれる発見を潰す面はあります。台本8割、当日の自由質問2割くらいの余白は残した方がよいでしょう。この進め方が割に合うのは、複数社を同時に比較する選定で、かつ電話やチャットの一次対応のように用件の型が書き出せる業務の場合です。用件が書き出せないほど非定型な業務なら、デモ比較より先に業務の整理が要ります。
まとめ
各社が用意したシナリオのデモは比較の材料にならない。自社の代表用件を匿名化した共通の質問と条件を事前に渡す
評価するのは成功よりも失敗と手直しの挙動。全問正解のデモはむしろ疑う
実演のない提案は、資料で分かる構造と実演でしか分からない体験を分け、後者を未確認のまま残す
あなたのセンターの比較表で、「未確認」のまま残せている欄はいくつあるでしょうか。
よくある質問
Q1. 共通の質問台本は何問くらい用意すればよいですか。 定型用件2〜3問、例外対応2〜3問、感情的な場面1〜2問の計5〜8問が目安です。多すぎると各社の負担が増えて実演の質が下がり、少なすぎると定型用件しか見られません。
Q2. ベンダーに台本を事前に渡したら、対策されてしまいませんか。 事前に渡す台本への対策は、そのまま自社用件への作り込みなので歓迎すべきものです。作り込み合戦を避けたい部分は、当日その場で足す自由質問1〜2問で確かめます。
Q3. デモで良かったベンダーが本番でも良いとは限らないのはなぜですか。 デモは整った条件で動き、本番は自社のデータ・システム連携・例外用件の上で動くためです。企業の生成AIパイロットで損益への効果を出せたのは約5%という調査もあり、デモと本番の間にはPoCでの検証が必要です。
Q4. 実演を断られた場合はどう評価すればよいですか。 その時点では体験に関わる項目を未確認として残し、次の選定段階へ進む条件に実演またはトライアルを入れます。実演がないことを機能がない証拠として扱うのは誤読です。
注記: 本記事は2026年10月19日時点の公開情報をもとにしたデスクリサーチであり、見立ての部分は筆者個人の見解です。特定ベンダーの推奨・順位付けは行っていません。
出典
Gartner「Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027」
Fortune「MIT report: 95% of generative AI pilots at companies are failing」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。