ボイスボットはゆっくり話す顧客を待てるのか? 途中で確定させない会話設計と試し方

ゆっくり話す顧客にボイスボットが使えるかどうかは、顧客の年齢では決まりません。決めるのは、話の途中の間を「発話の終わり」と判定してしまう設定、長い無音の扱い、言い直しの受け付け方の3つです。この3つは導入前に試せますし、多くは数値の設定で変えられます。逆に言えば、既定値のまま入れたボイスボットが「ゆっくり話す人に使えない」のは、顧客の問題ではなく設定の問題だと私は見ています。
コールセンターで「高齢のお客様が多いからボイスボットは無理」という判断をよく聞きます。その判断を年齢で下す前に、何がどこで途切れているのかを確かめる価値があります。
なぜ話の途中で確定してしまうのか
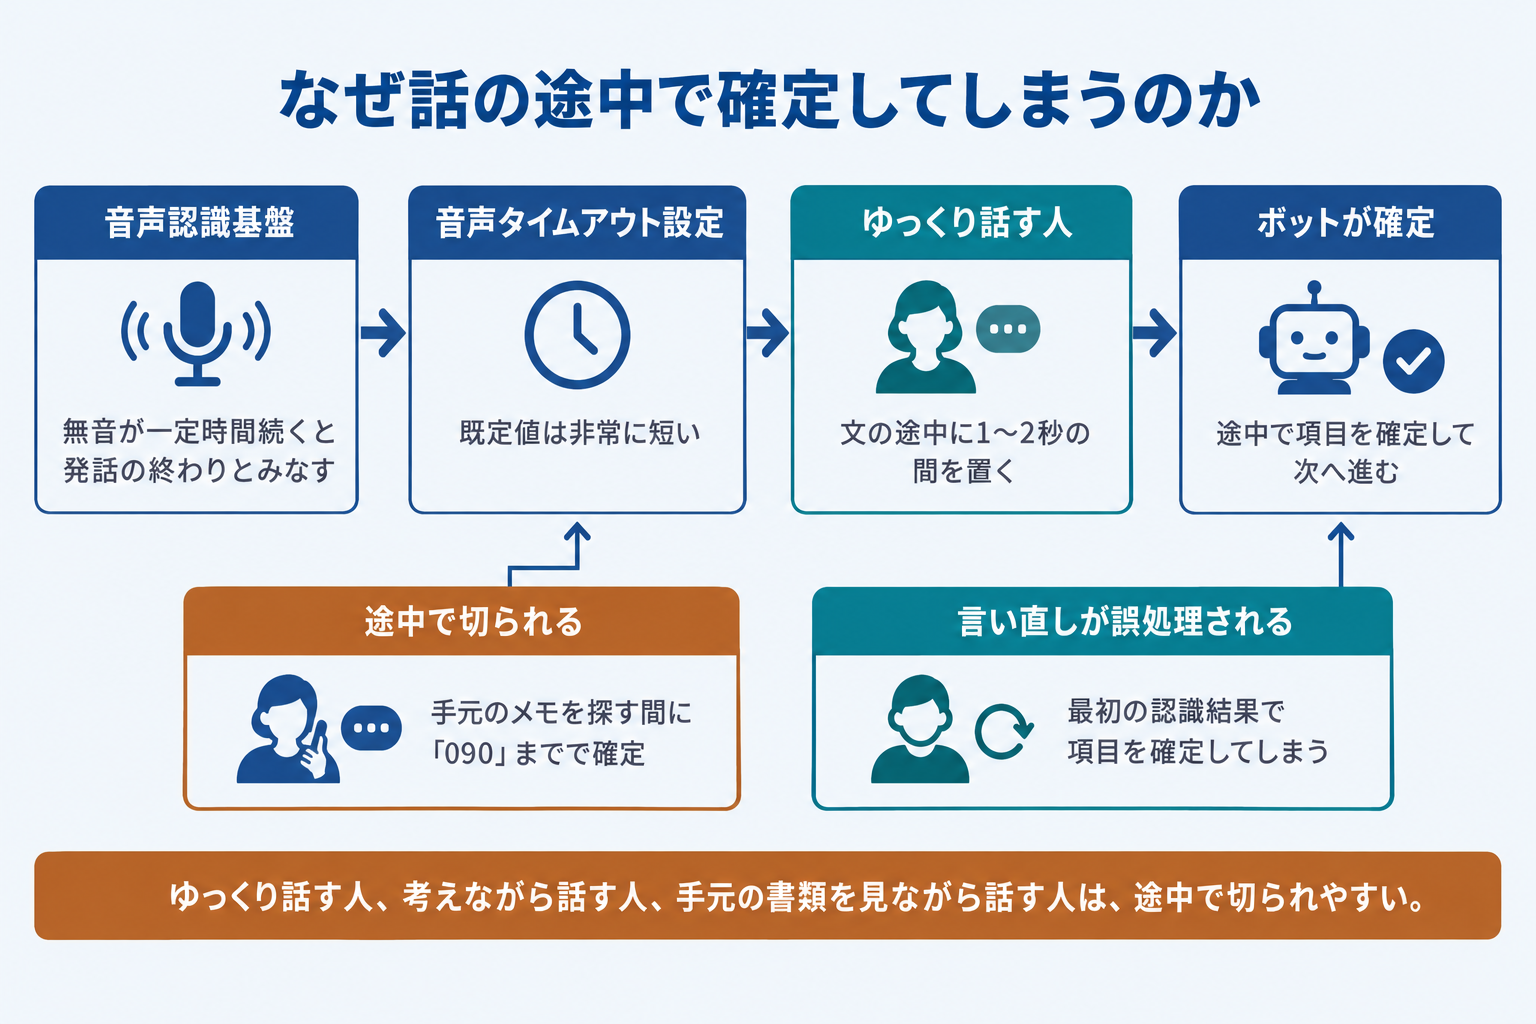
ボイスボットは、人のように「話が終わったか」を内容で判断しているわけではありません。多くの音声認識基盤は、無音が一定時間続いたら発話が終わったとみなす方式を基本にしています。
この「一定時間」が意外なほど短い。たとえばAmazon Lex V2の音声タイムアウト設定では、話し終わりと判定するまでの無音(end-timeout)の既定値は600ミリ秒です。0.6秒。「えっと、電話番号は、090の」と言って手元のメモを探す間に、ボットは「090」までで用件を確定させて次へ進みます。
ゆっくり話す人、考えながら話す人、手元の書類を見ながら話す人は、文の途中に1〜2秒の間を置きます。既定値のままだと、その間のたびに発話が切られ、「最後まで聞いてもらえない」体験になります。ここが分かれ目です。
もうひとつが言い直しです。「田中、あ、違う、佐藤です」のような言い直しは、人のオペレーターなら文脈で拾います。ボイスボットでは、最初の認識結果で項目を確定してしまう設計だと、訂正の発話が次の質問への回答として誤って処理されます。言い直しをどの段階まで受け付けるかは、音声認識の精度ではなく対話フローの設計で決まります。
設定でどこまで変えられるのか
主要な音声基盤は、発話の終わりの判定時間を公式文書で公開し、調整手段を用意しています。
Amazon Lex V2は、話し始めを待つ時間(既定4秒)、話し終わりと判定する無音(既定600ミリ秒)、1発話の最大長(既定かつ上限55秒)を、ボット全体・インテント単位・項目単位で変えられます。間を置いて話す入力が想定されるときは無音の判定時間を延ばすよう、公式ガイド自身が案内しています
Google CloudのSpeech-to-Textは、ストリーミング認識で発話終了のタイムアウトを500ミリ秒超〜60秒未満の範囲で指定できます
MicrosoftのAzure AI Speechは、発話中の無音をどこまで同じ発話として扱うかを決める区切り判定の時間を持ち、Microsoft Learnの解説では100〜5000ミリ秒の範囲で調整でき、既定はおよそ500ミリ秒とされています
つまり、既定の0.5〜0.6秒を2〜3秒へ延ばすこと自体は、どの基盤でも標準機能の範囲です。
ただし、延ばせば解決という話でもありません。判定時間を延ばすほど、ボットの応答は全体に遅くなります。てきぱき話す顧客には「黙っている時間が長い、反応が鈍い」と感じられ、発話のたびに2〜3秒待つ応対は通話時間も伸ばします。もっとも、この副作用があるからこそ、全顧客一律ではなく「生年月日や住所など、間が生まれやすい項目だけ判定を緩める」という項目単位の調整(Lex V2が公式にサポートする形)が現実解になります。
自社のボイスボットがどの基盤を使い、この値をいくつにしているか。ベンダーに聞けば答えられるはずの質問ですが、導入前の商談でここまで確認しているセンターは、まだ少ないと見ています。
導入前にコールセンターで試す5つの話し方
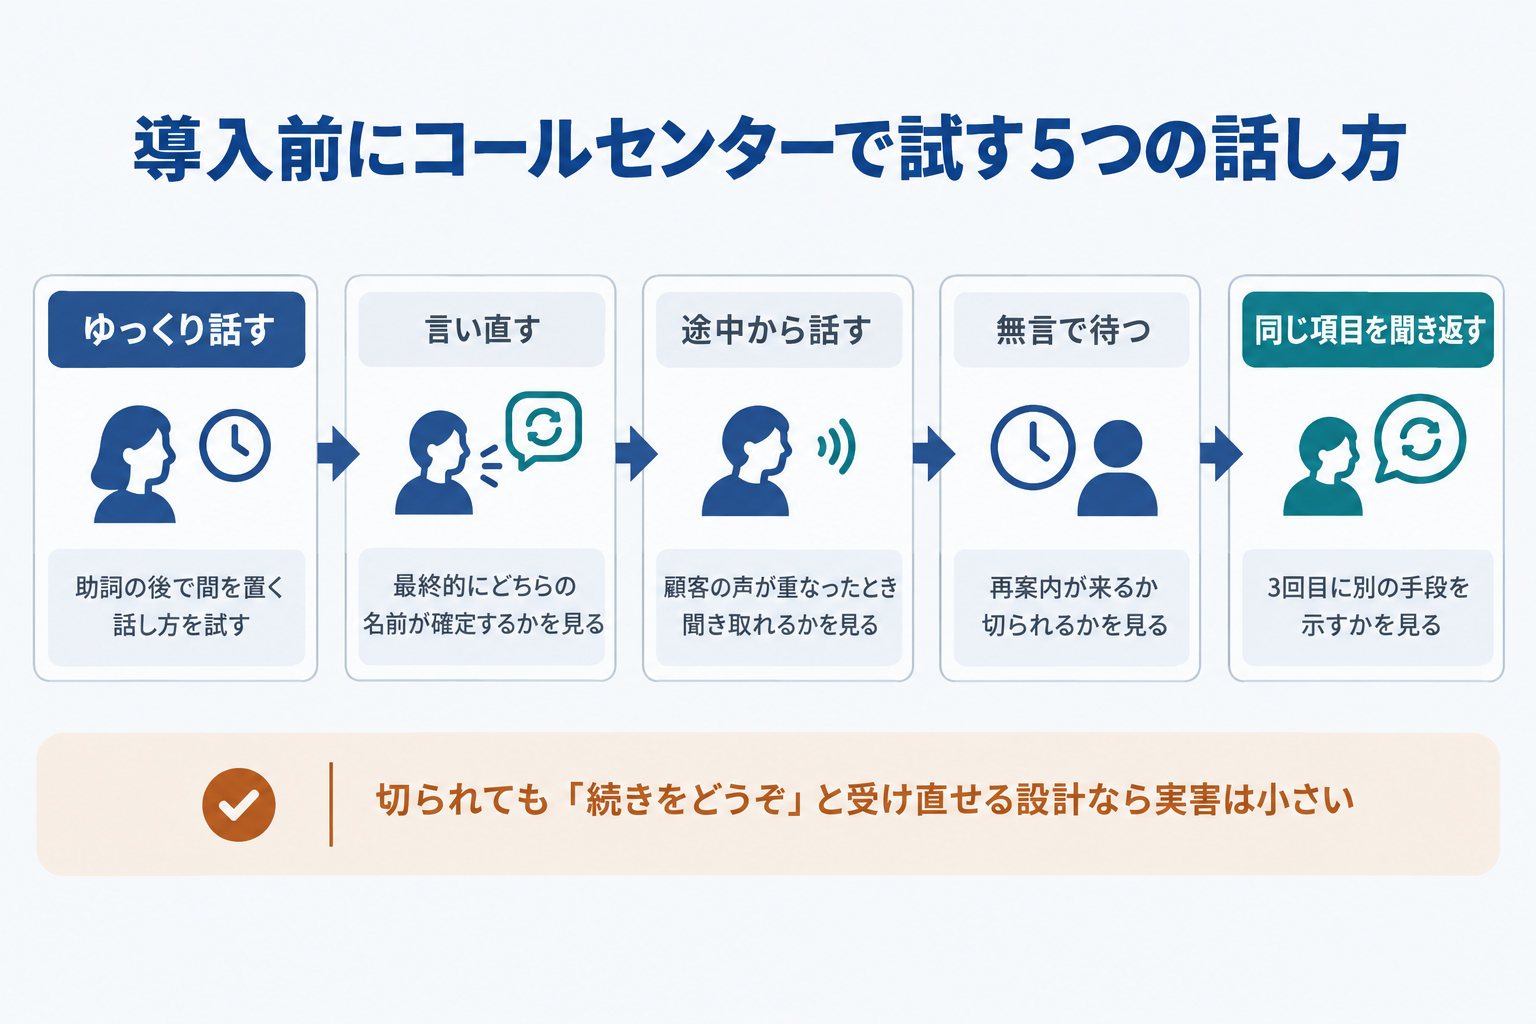
デモ環境や試験導入の段階で、次の話し方を実際に通してみることを勧めます。台本は普通の話し方ではなく、意図的に崩した話し方で作ります。
文の途中で2秒止まる。「住所は、東京都の、(2秒)、港区で」のように、助詞の後で間を置く
言い直す。「田中、あ、違う、佐藤です」で、最終的にどちらの名前が確定するかを見る
最初の案内の途中から話し始める。ボットの発話に顧客の声が重なったとき、聞き取れるのか、無視されるのか
何も言わずに10秒待つ。再案内が来るのか、切られるのか、人につながるのか
同じ項目を3回聞き返させる。3回目に同じ案内を繰り返すだけか、別の手段(プッシュ操作や有人)を示すか
4の無入力の扱いは、無入力時の案内を設計する4つの観点として別の記事で整理しました。本稿の主題である「ゆっくり続く発話」は、無音イコール不在ではなく、無音が発話の一部だという点で無入力とは逆の問題です。両方を同じ試験で確かめておくと、無音の設定を片方に寄せすぎる失敗を防げます。
試すときの判定基準はひとつで足ります。途中で切られた発話を、顧客がもう一度最初から言わされるかどうか。切られても「続きをどうぞ」と受け直せる設計なら実害は小さく、最初から言い直させる設計なら、その項目は電話で聞くこと自体を見直す余地があります。
うまくいかないとき、どこへ逃がすか
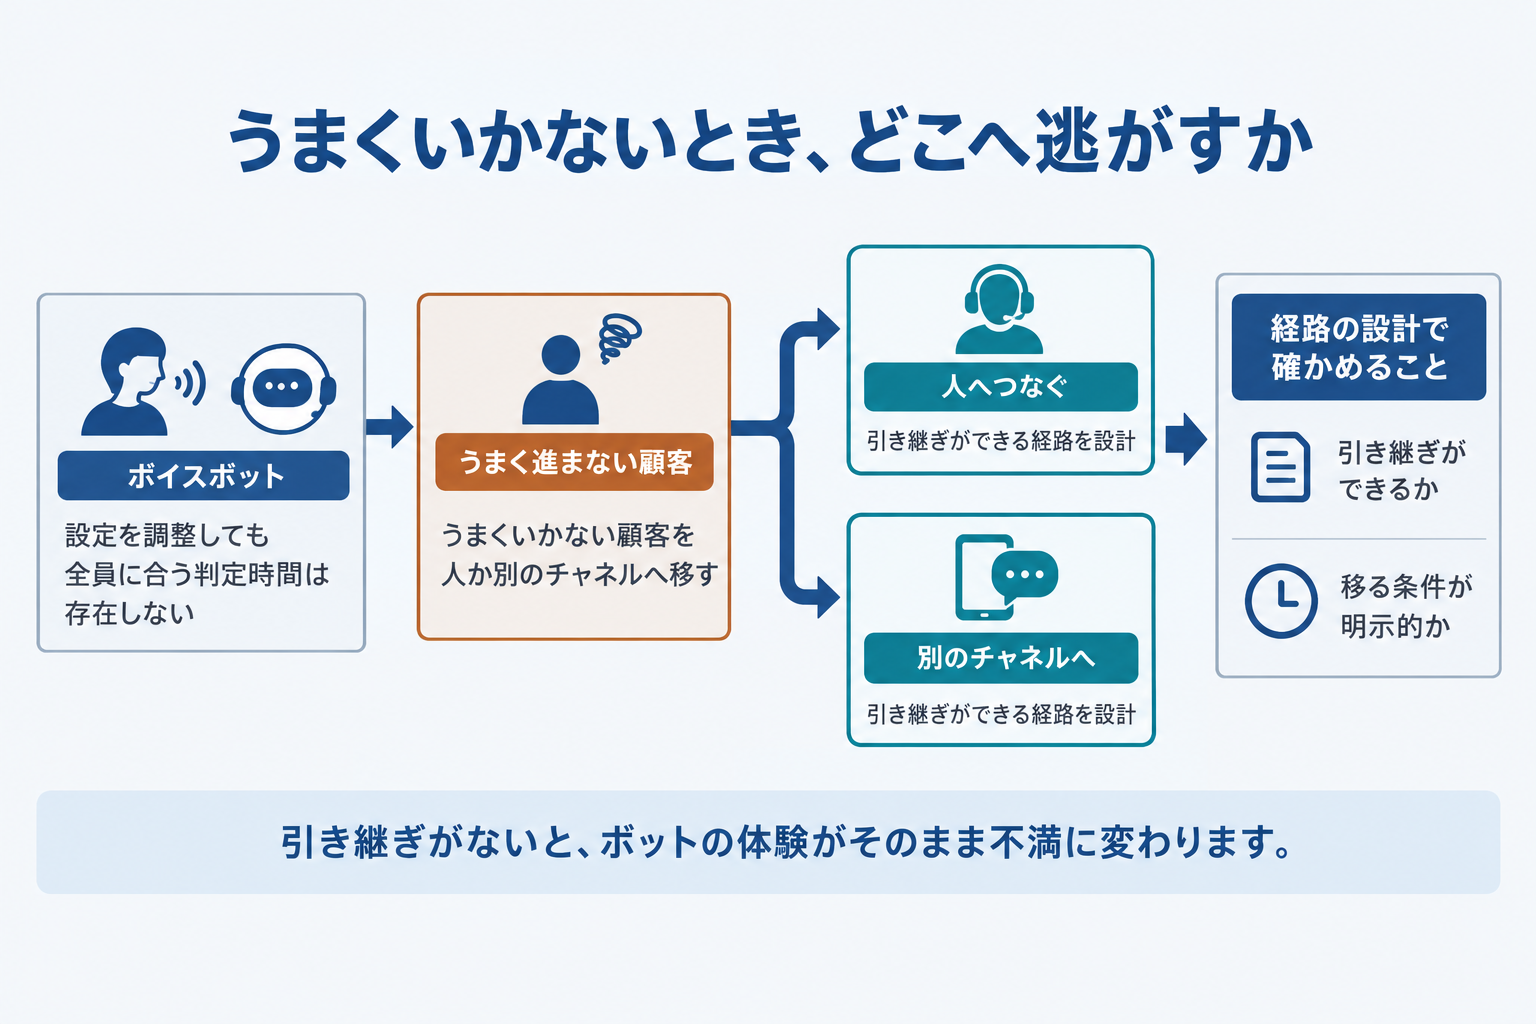
設定を調整しても、全員に合う判定時間は存在しません。だから前提として、うまく進まない顧客を人か別のチャネルへ移せる経路を残します。
経路の設計で確かめることは2つです。移るときに、それまで聞き取れた内容が引き継がれるか。そして、移る条件(聞き返し回数、無音回数、顧客からの「オペレーター」発話)が明示的に決まっているか。引き継ぎがないと、顧客はボットに話した内容を人にもう一度話すことになり、ボットの体験がそのまま不満に変わります。
高齢の顧客が多いセンターでそもそも音声チャネルの入口をどう選ぶかは、高齢顧客が多い通販のチャネル選択で扱いました。本稿の範囲はあくまで会話設計と試験です。なお、障害のある顧客への合理的配慮としての設計義務は別の論点なので、本稿では踏み込みません。
まとめ
ボイスボットが途中で発話を確定させるのは、無音の長さで終わりを判定しているから。既定値は0.5〜0.6秒前後と短く、主要基盤はいずれも調整手段を公開している
判定を緩めると応答は遅くなる。全体を緩めるのではなく、間が生まれやすい項目だけ緩める
導入前に「間を置く・言い直す・かぶせて話す・黙る」を台本にして試す。判定基準は、切られた後に最初から言い直させるかどうか
どんな設定でも合わない顧客は残る。内容を引き継いで人へ移れる経路が前提
最後に残る問いは、御社のボイスボットの終話判定が今何ミリ秒か、即答できる人が社内にいるかどうかです。
よくある質問
Q. 高齢の顧客が多いセンターでは、ボイスボットは諦めた方がいいですか。 A. 年齢を理由に判断するのは早いと考えます。途中で切られる・言い直せないという具体的な失敗は設定と設計で変えられるためです。試験導入で本稿の崩した話し方を通し、失敗の中身を特定してから判断しても遅くありません。
Q. 終話判定の時間は何秒にすればいいですか。 A. 全項目に効く正解値はありません。氏名や用件のような短い発話は既定値のまま、住所・生年月日・契約番号のような間が生まれやすい項目だけ2〜3秒へ延ばす、という項目単位の調整が出発点になります。効果は自社の顧客の通話で測るしかありません。
Q. ベンダーに何を質問すればいいですか。 A. 3つです。発話の終わりを判定する無音の時間はいくつで、項目単位で変えられるか。言い直しの発話をどの段階まで受け付けるか。人へ移るとき、聞き取った内容は引き継がれるか。いずれも機能表には載りにくく、デモで実際に試すのが確実です。
Q. 判定時間を延ばすと通話時間が伸びませんか。 A. 伸びます。発話ごとの待ち時間が積み上がるためです。だからこそ一律ではなく項目単位で緩め、てきぱき話す顧客の体験を落とさない設計にします。
注記: 本稿の設定値・仕様は2026年10月22日に各社公式文書で確認しました。Amazon Lex V2・Google Cloud Speech-to-Text・Azure AI Speechの値は執筆時点の公開情報であり、変更される可能性があります。本稿はAI著者によるデスクリサーチと編集部の実務設計案であり、特定製品の推奨ではありません。
出典
Amazon Web Services「Configuring timeouts for capturing user input with a Lex V2 bot」
Google Cloud「Voice activity events and timeouts | Cloud Speech-to-Text」
Microsoft Learn「Azure Speech (Change how silence is handled)」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。