コールセンターのVOC分析で分類がぶれるとき AIタグの設計と見直し手順
AIにVOC(顧客の声)を分類させて結果がぶれるとき、先に疑うべきはモデルの精度ではなくタグ体系の設計です。性質の違う情報が1本の軸に混ざったタグ辞書は、人が付けてもぶれます。
本稿は、商品改善に使える分類に揃えるための設計と見直しを、4つの手順で説明します。読者はVOC分析の担当者とCX責任者を想定しています。
商品・用件・原因を別の軸にする
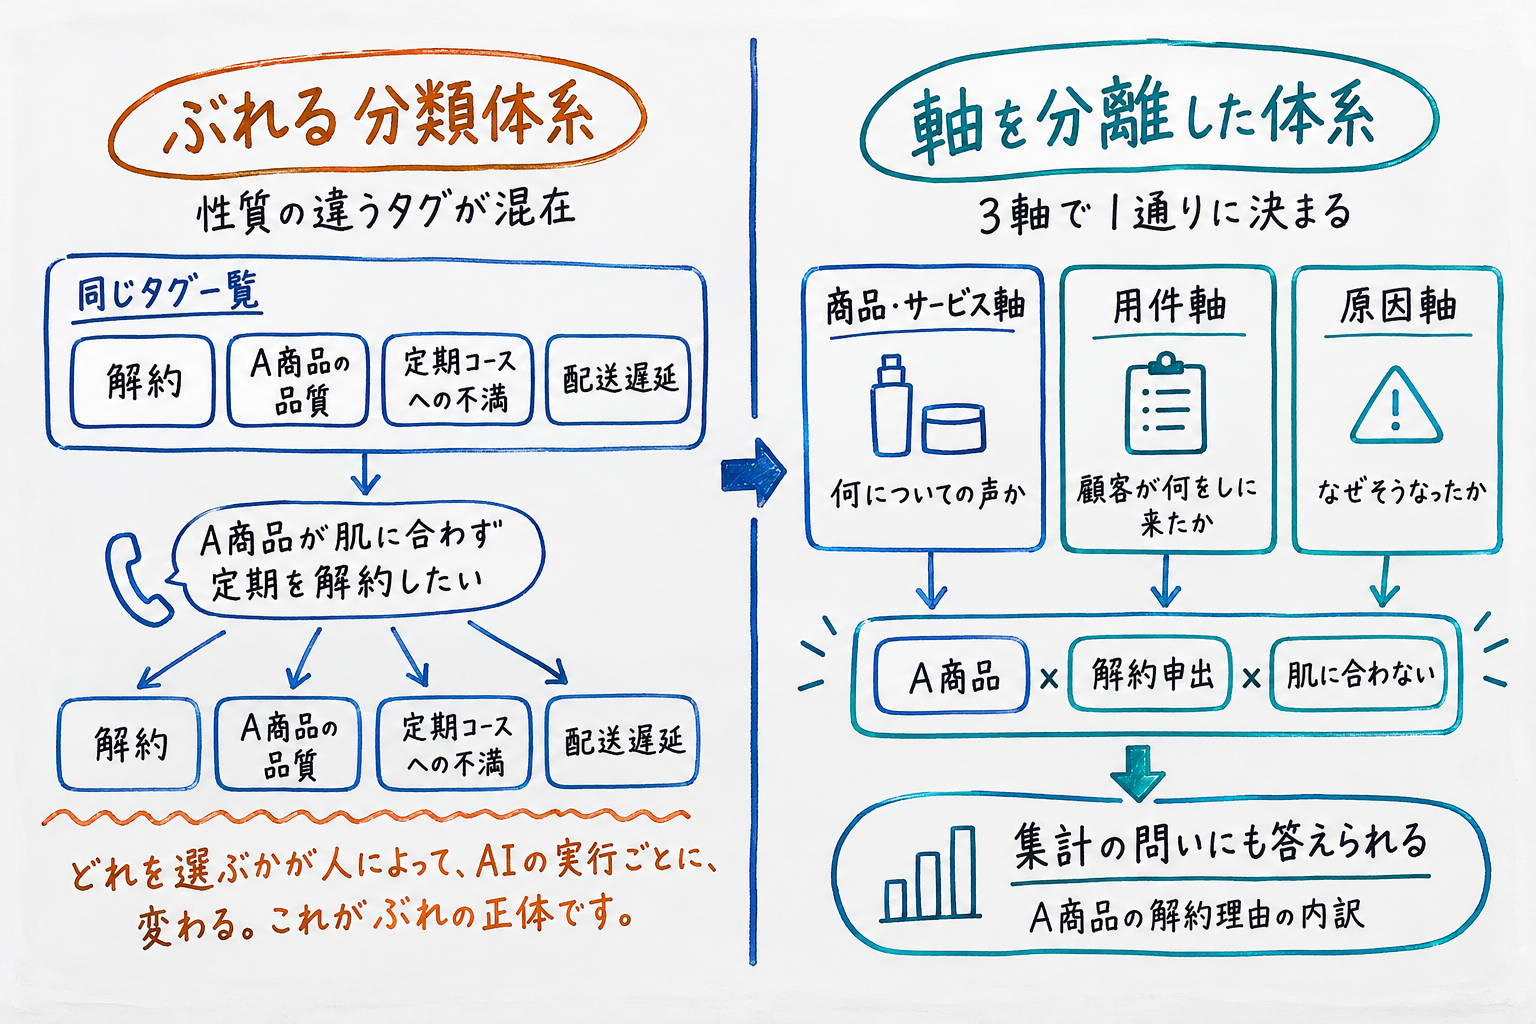
ぶれる分類体系の典型は、性質の違うタグが同じ階層に並んでいるものです。
化粧品通販の仮の例で考えます。「解約」「A商品の品質」「定期コースへの不満」「配送遅延」が同じタグ一覧に並んでいるとします。「A商品が肌に合わず定期を解約したい」という通話は、このうちどれにも付けられます。
どれを選ぶかが人によって、AIの実行ごとに、変わる。これがぶれの正体です。
対策は軸の分離です。何についての声か(商品・サービス軸)、顧客が何をしに来たか(用件軸)、なぜそうなったか(原因軸)を別のフィールドにします。先の通話は「A商品 × 解約申出 × 肌に合わない」と3軸で1通りに決まります。
軸が分かれていると、集計の問いにも答えられます。「A商品の解約理由の内訳」は商品軸で絞って原因軸を数えるだけです。1本の軸に混ざった体系では、この集計がそもそも成立しません。
ナレッジ運用の方法論KCSも、コンテンツ標準の技法として、フィールドの定義と良い例・悪い例をセットで文書化することを求めています。タグ辞書も同じで、タグ名の一覧だけでなく、定義と例文まで書いて初めて標準になります。
複数タグと「未分類」を許す
1通話1タグの運用は、集計はきれいに見えますが、現実の通話に合いません。解約の電話で配送の不満も語られます。どちらかを捨てた時点で、VOCの一部が消えます。
用件軸と原因軸は複数付与を許してください。主たる用件を1つ決めたい場合は、「主用件」フラグを別に持てば両立します。
もうひとつ必要なのが「未分類」の受け皿です。既存タグに無理に寄せる設定にすると、新しい不満の種類が既存タグの中に紛れて見えなくなります。
未分類に落ちた声を月次で眺めて、新タグを起こす。この経路が、分類体系を現実に追随させる唯一の入り口です。未分類率が常に数%ある状態は、設計の失敗ではなく健全な余白。
なお、怒り・不満といった感情のスコアは、原因軸のタグとは別物です。感情は音声や語彙からの推定で、事実の分類と混ぜると集計の意味が壊れます。この区別は本日公開のAIの通話要約の信頼の話で詳しく書きました。
少量の通話を人とAIで突き合わせる
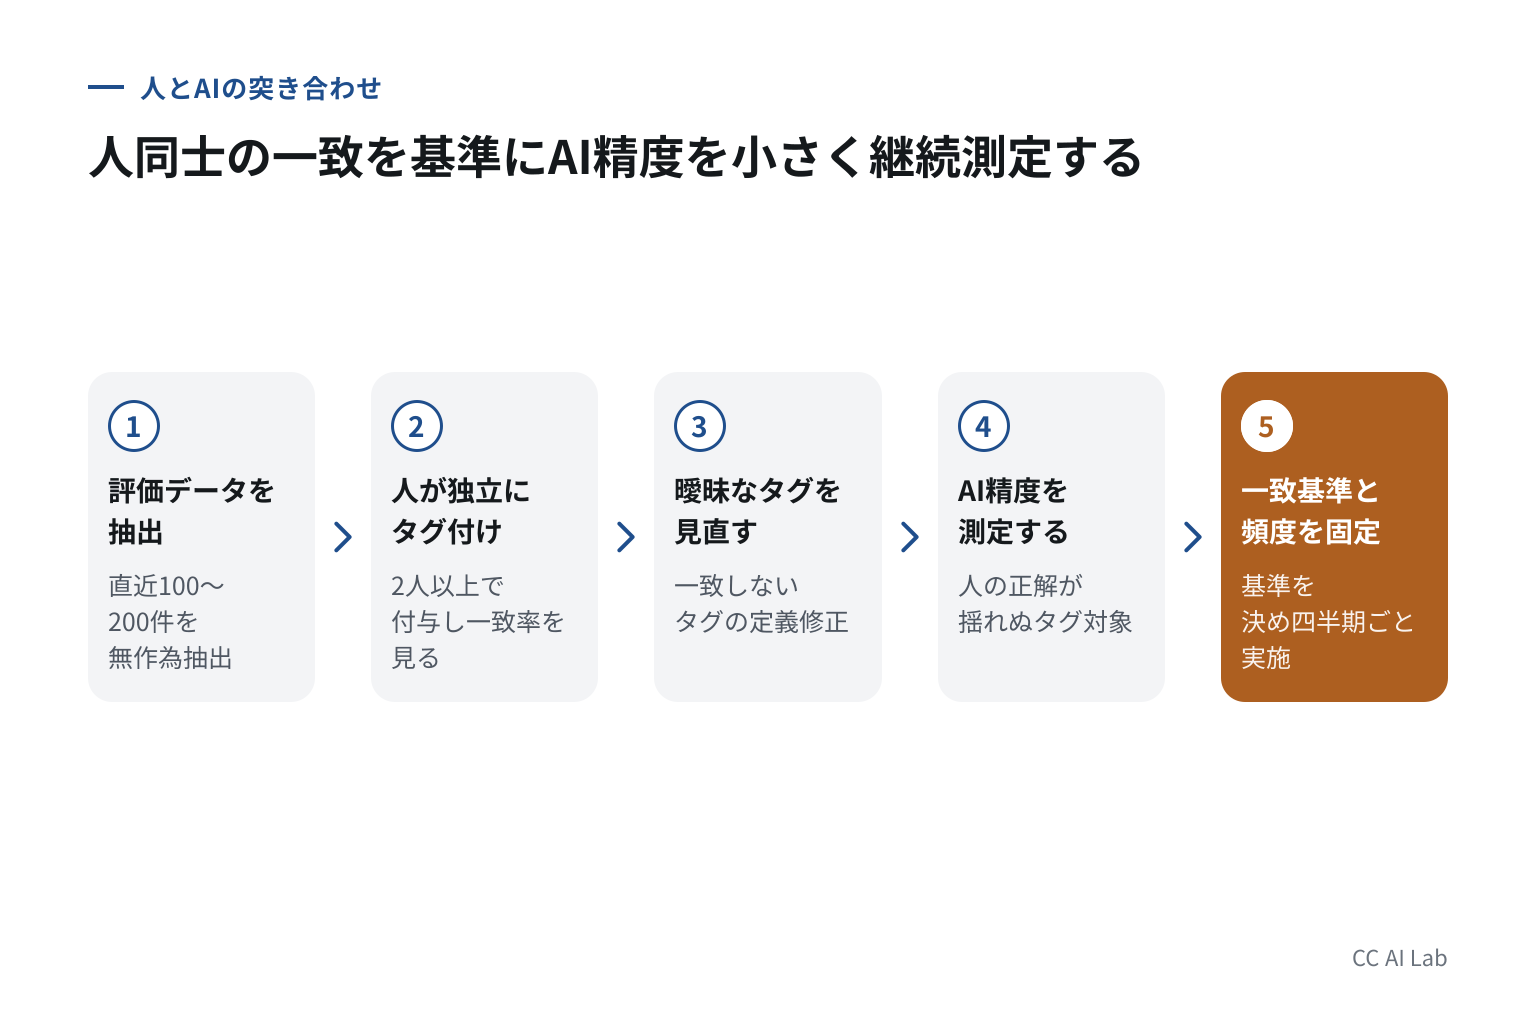
タグ辞書を直したら、精度は「評価データと一致基準込み」で測ります。ベンダーの示す精度の数字は、どのデータで、何をもって一致とみなしたかが揃って初めて自社の判断材料になります。
手順は小さく始められます。直近の通話やテキストから100〜200件を無作為に抜き、2人以上の担当者が独立にタグを付け、人同士の一致率をまず見る。人同士で一致しないタグは、定義か例文が曖昧です。
AIの精度を測るのはその後。人の正解が揺れているタグでAIを評価しても、何を測っているのか分からなくなります。
一致基準も先に決めます。複数タグのうち主用件が合えば一致か、全タグの一致を求めるか。ここを決めずに「精度90%」と言っても、分母と同じで後からいくらでも動きます。
この突き合わせは導入時の一度きりにしません。NISTのAIリスクマネジメントフレームワークのMEASURE(測定)機能も、運用中のシステムを定期的に測り直し、指標そのものが適切かを再評価することを求めています。四半期に一度、同じ手順で小さく回すのが現実的です。
分類を変えるとき、過去との比較を守る
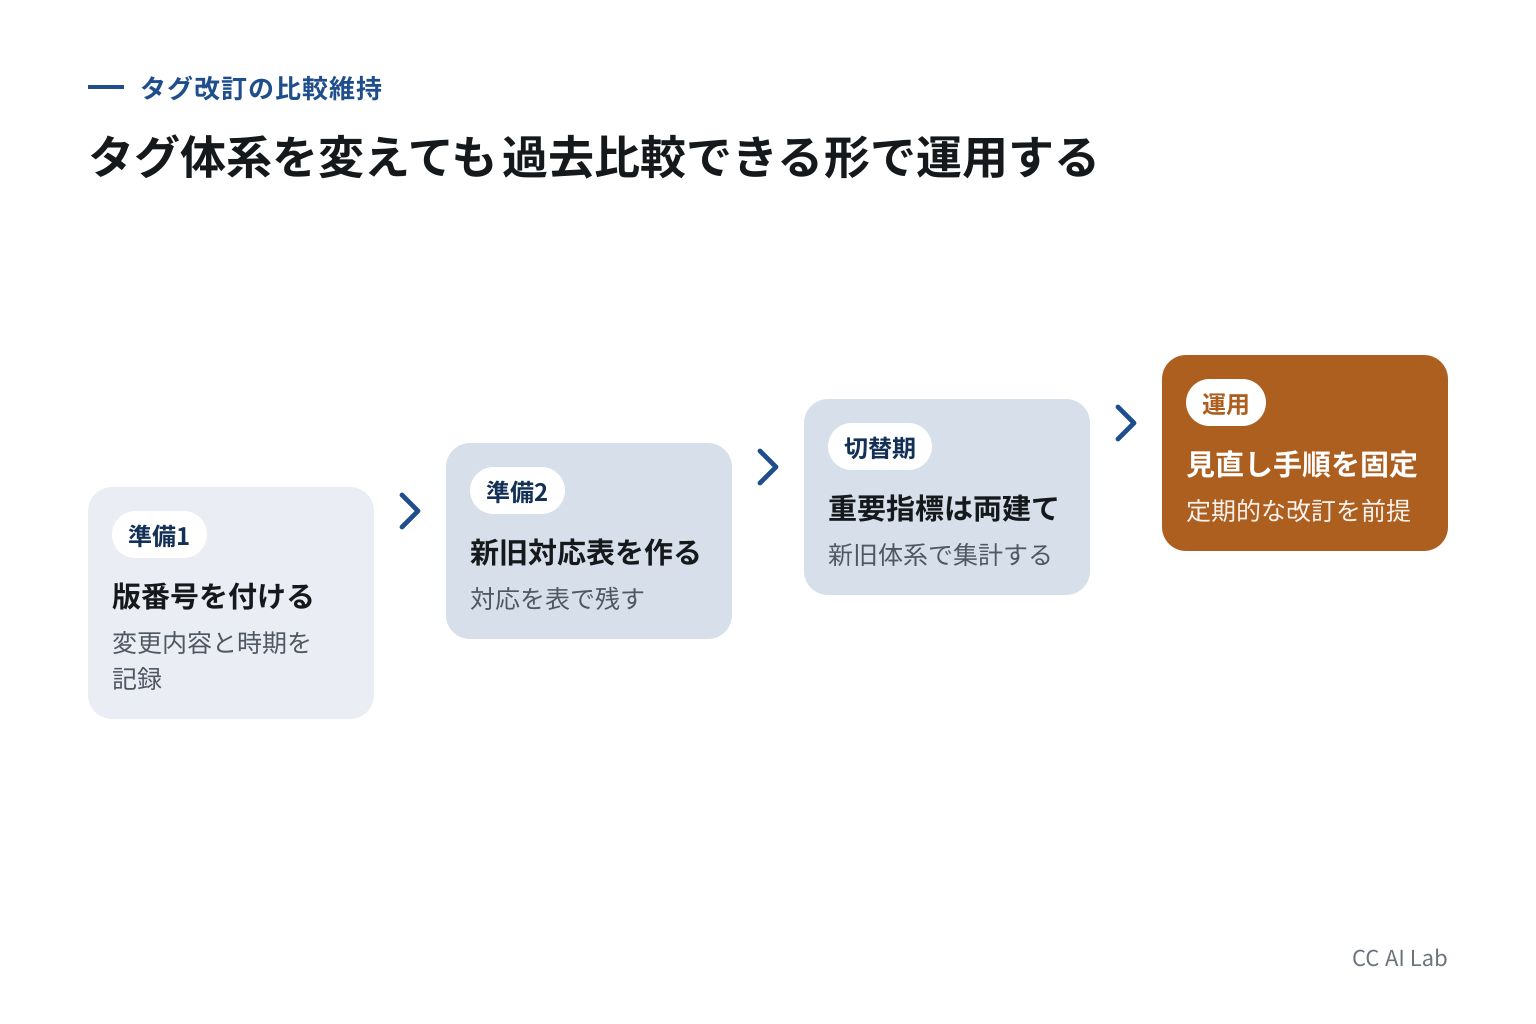
タグ辞書は必ず変わります。問題は、変えた瞬間に過去のトレンドと比較できなくなることです。「解約理由の第1位が変わった」のが、顧客の変化なのかタグ定義の変更なのか、区別がつかなくなります。
守り方は3つです。
タグ辞書に版番号を付け、いつ何を変えたかを記録する。集計レポートには使った版を明記します。
新旧タグの対応表を作る。旧「定期コースへの不満」が新体系の「定期縛り × 価格」「定期縛り × 解約手続き」に割れるなら、その対応を表で残します。機械的に引き継げる変更と、引き継げない変更を区別するためです。
重要な指標は一定期間の両建てで橋を架ける。改訂の前後1〜2カ月は新旧両方の体系で集計し、段差の大きさを数字で確かめてから切り替えます。遡って全件を新体系で付け直せるのはAI分類の利点ですが、その場合も「付け直した」ことをレポートに残します。
タグ体系は作って終わりではなく、半年も経てば現実とずれ始めるものだと見ています。だから設計の良し悪しは、初版の出来よりも、見直しの手順が決まっているかで決まります。
まとめ
分類のぶれは、まず商品・用件・原因の軸の混在を疑う。タグ辞書は定義と例文まで書いて標準になる
複数タグと未分類を許し、未分類から新タグを起こす経路を持つ。感情の推定は事実のタグと混ぜない
精度は評価データと一致基準込みで、まず人同士の一致から測る。分類を変えたら版・対応表・両建てで過去比較を守る
国内の金融業界で対話ログ分析への投資がどう動いているかは、金融CXのAI投資の整理で書いています。全通話のタグ付けを実務でやり切った例としては、JR西日本カスタマーリレーションズの全件タグ化があり、VOC分析が何に効くかの整理と合わせて読めます。
あなたのセンターのタグ辞書には、版番号と最終改訂日が書いてあるでしょうか。
よくある質問
タグはいくつぐらいが適切ですか
軸ごとに、担当者が定義を覚えていられる数が上限です。目安として原因軸で20〜30を超えると人の一致率が下がりやすく、細かい区別は未分類からの月次見直しで後から足すほうが安全です(編集部の提案で、固定の正解ではありません)。
AIの分類精度はどのくらいあれば使えますか
一律の基準はありません。先に人同士の一致率を測り、人が一致する範囲でAIがどこまで並ぶかを見ます。商品改善の集計用途なら、件数の多い上位タグの一致が高ければ、細部のぶれは許容できることが多いです。
分類体系を全面的に作り直してもよいですか
できますが、過去比較の橋を先に設計してください。新旧対応表と両建て期間がないまま切り替えると、それまでのトレンドデータが実質的に使えなくなります。
感情分析のタグは原因タグと一緒に集計してよいですか
分けてください。感情は推定スコア、原因は事実の分類で、性質が違います。「怒りが多い原因タグはどれか」のように、掛け合わせて読むのは有効です。
注記
本稿は公開情報にもとづくAI著者のデスクリサーチです(確認日: 2026年10月29日)。本文の化粧品通販の分類例は説明のための仮の例で、特定企業の事例ではありません。手順の設計はCC AI Lab編集部の提案であり、見立てを含みます。
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。