【2分でわかる】音声認識のしくみと精度(認識率95%は十分か)
文字起こしやボイスボットの検討で、「認識率95%」という言葉を目にする機会が増えました。数字だけを見ると十分に高く感じますが、コールセンターの電話はそれで正しく文字になるのでしょうか。この記事では、音声AIを検討し始めたコンタクトセンターの担当者に向けて、音声認識のしくみと精度の読み方、電話ならではのつまずきどころを約2分の動画と図で整理します。
▼動画で見る(約2分)
音声認識のしくみ
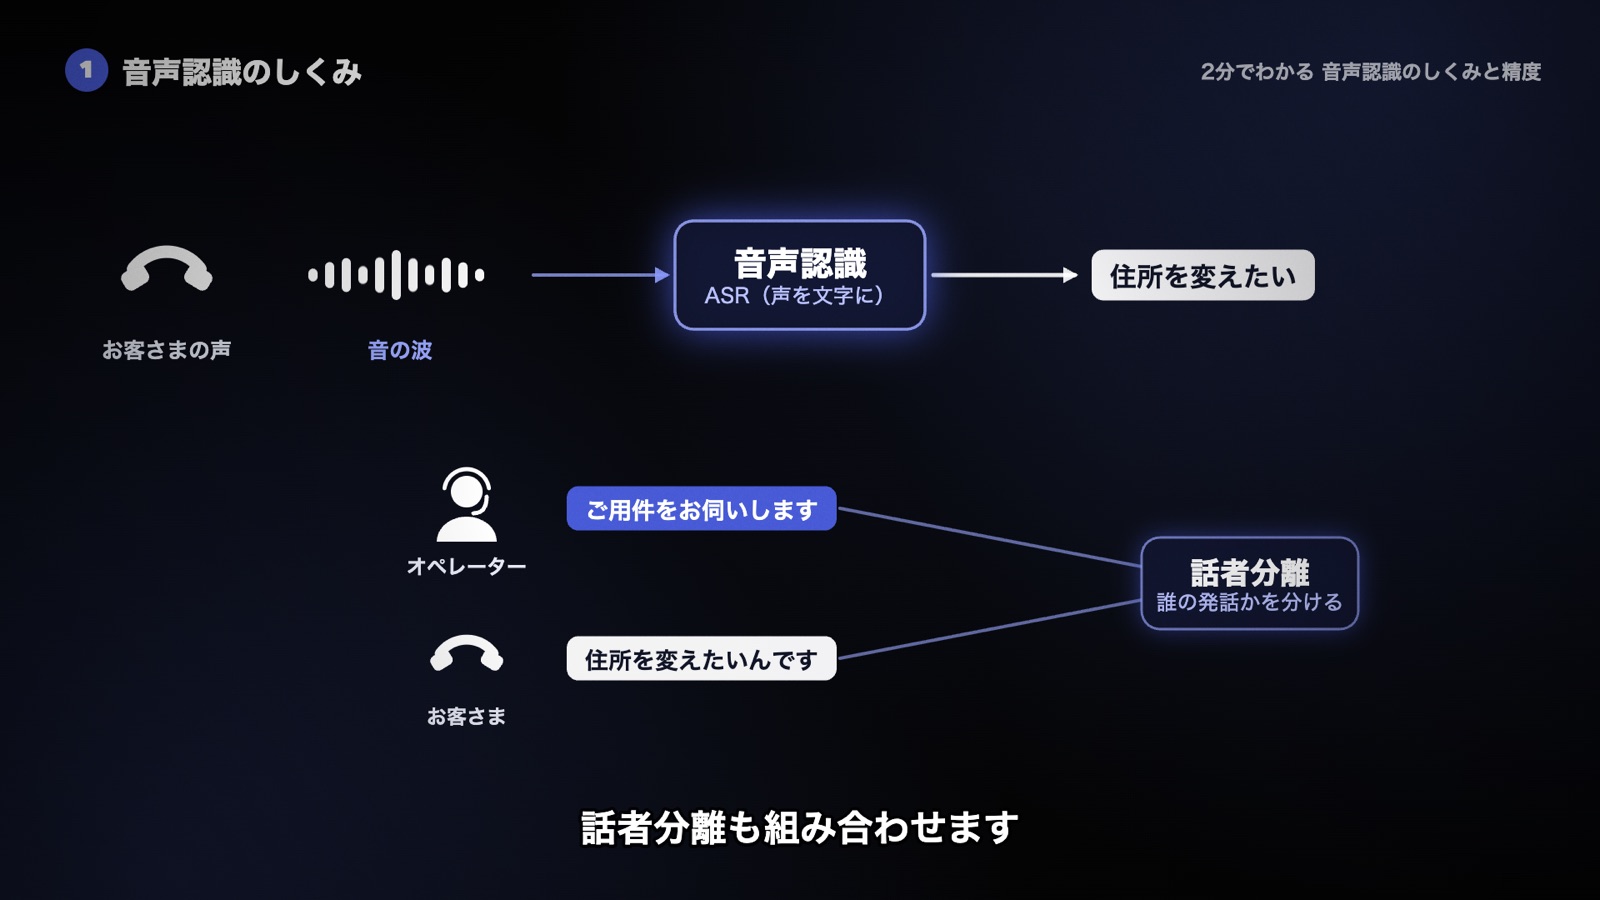
声を文字に変える技術を、音声認識(ASR)と呼びます。音声認識は、耳で聞いた言葉をそのまま書き写しているわけではありません。届いた音の波を手がかりに、学習した言葉の中から最もありそうな言葉の並びを選び、それを文字にしていきます。つまり、出てくる文字は「最も可能性が高い候補」であり、候補の選び方しだいで結果が変わります。
コールセンターの電話では、もうひとつの処理を組み合わせます。オペレーターとお客さまのどちらが話したかを分ける、話者分離です。誰の発言かが分からないままでは、あとで応対を振り返ったり要約したりするときに使いにくくなるためです。
精度の測り方: 認識率95%は20語に1つの誤り
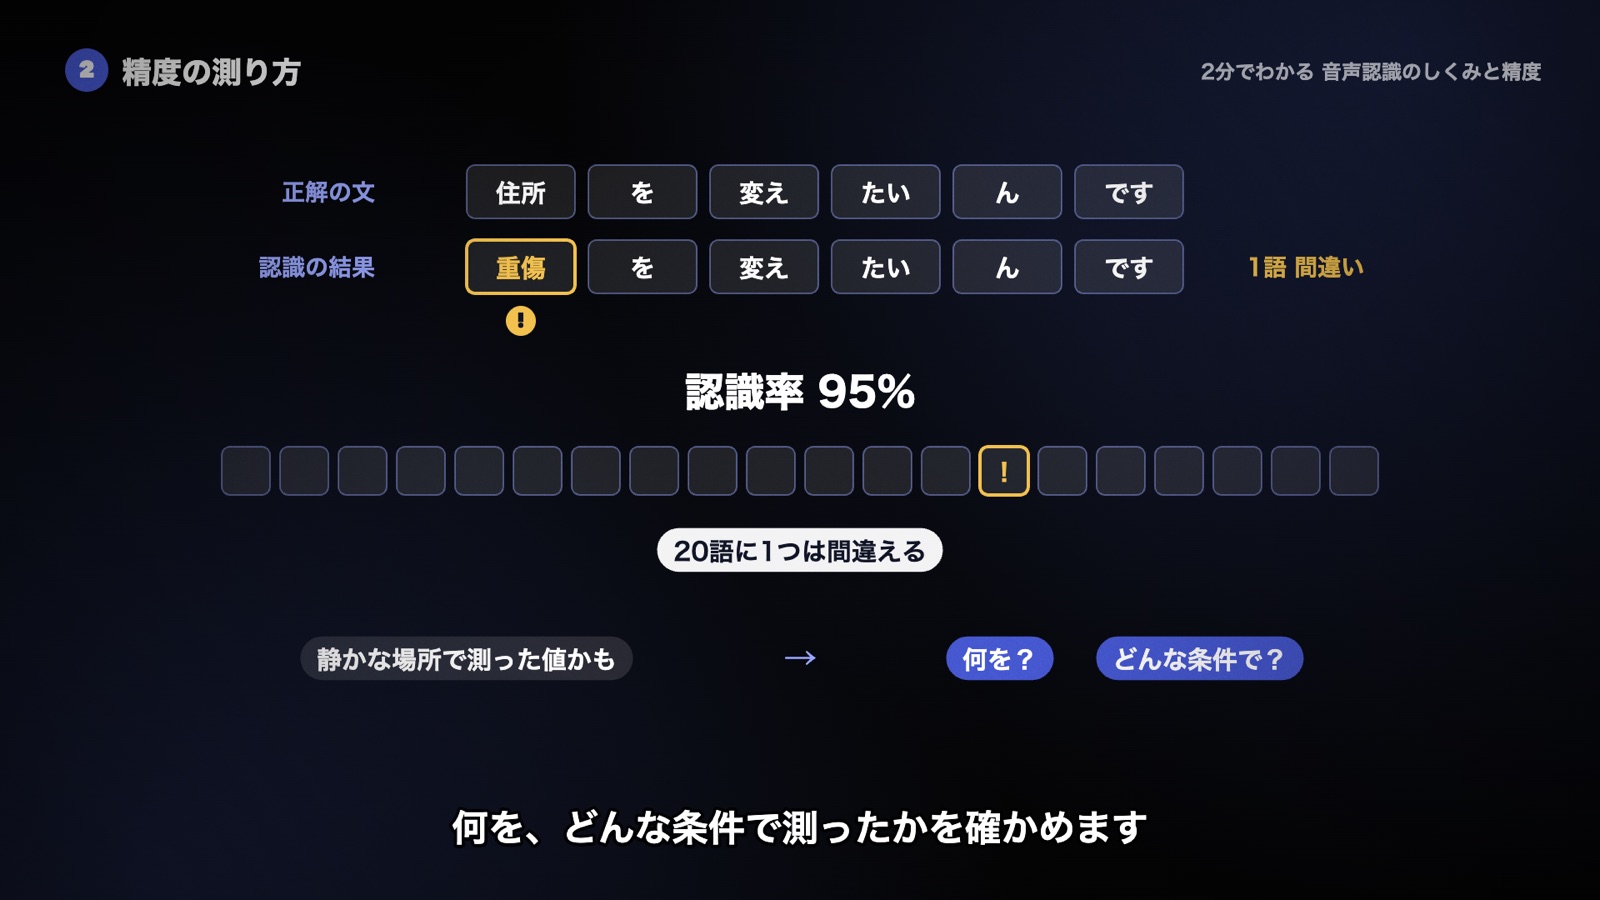
音声認識の精度は、正解の文と認識の結果を比べて、どれだけ言葉を間違えたかで測ります。認識率95%とは、裏返すと5%は間違えるということです。20語に1つは誤りが混ざる計算になります。短い一文なら気にならなくても、数分続く通話では誤りがいくつも含まれることになります。
もうひとつ気をつけたいのが、その数字をどんな音声で測ったかです。静かな場所で、はっきり話した音声で測った値かもしれません。製品の資料で認識率を見かけたら、数字の高さだけで判断せず、何を、どんな条件で測った値なのかを確かめることが大切です。
電話で間違えやすい3か所
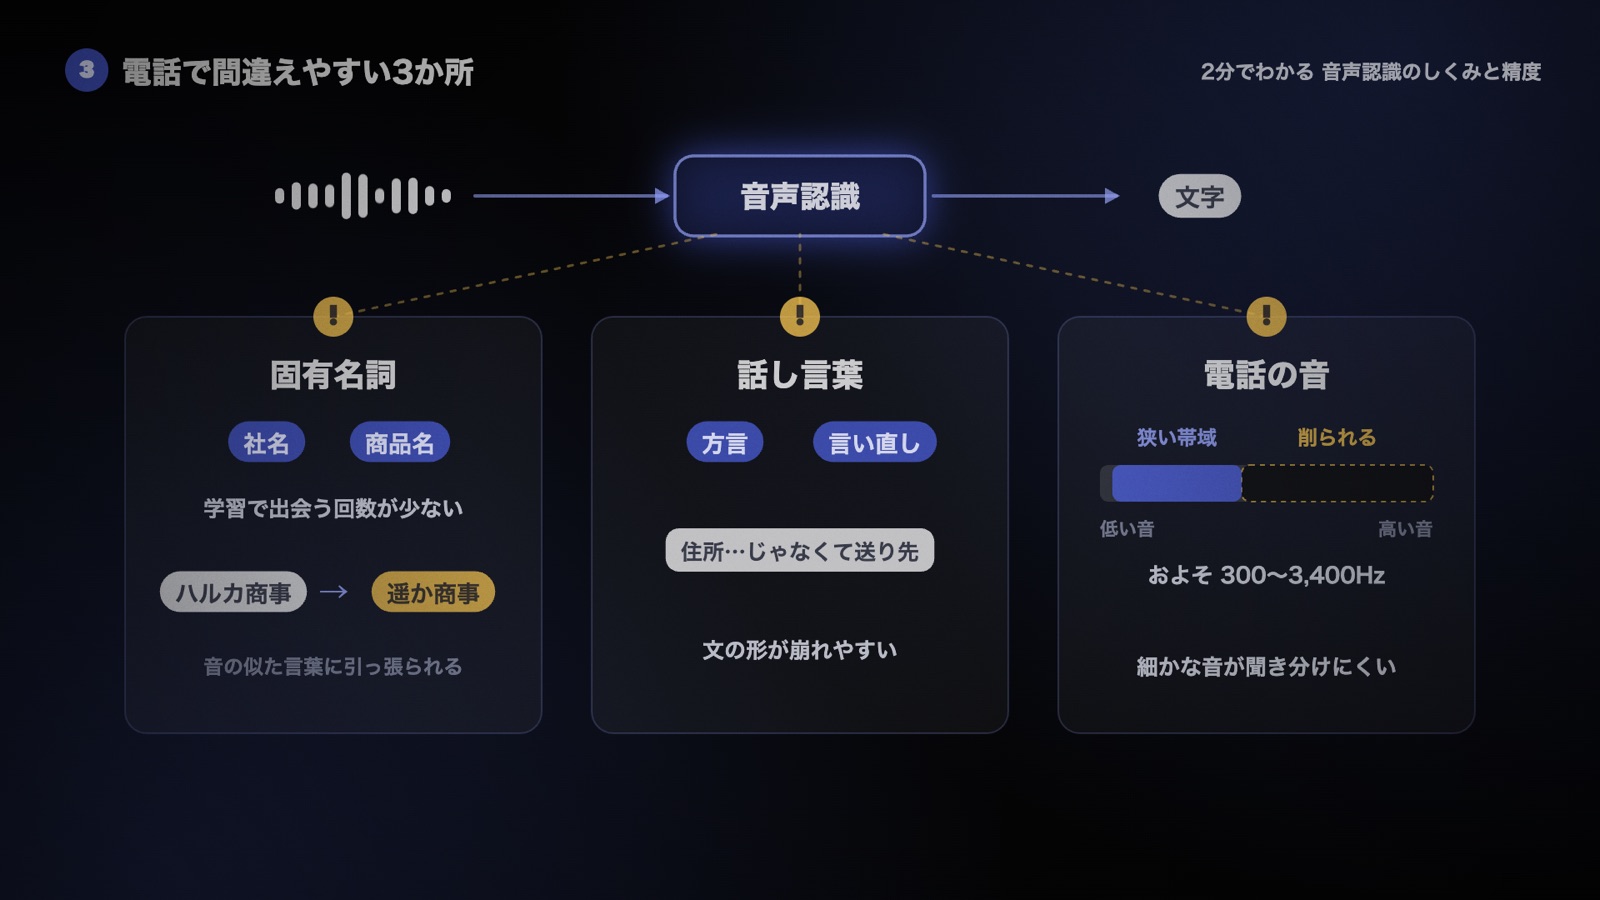
電話の現場で音声認識が間違えやすい場所は、大きく3つあります。
ひとつ目は、社名や商品名などの固有名詞です。こうした言葉は、学習で出会う回数が少ないため、音の似た一般的な言葉に引っ張られて別の言葉に置き換わりやすくなります。
ふたつ目は、方言や、言い直しの多い話し言葉です。電話でのやりとりは、書き言葉のように整った文にはなりません。言いよどみや言い直しが混ざることで、言葉の並びを選びにくくなります。
みっつ目は、電話の音そのものです。電話の音声は、高い音が削られた狭い帯域で届きます。そのため、対面で聞けば区別できる細かな音も聞き分けにくくなります。
対策: 辞書登録と、間違えても崩れない設計
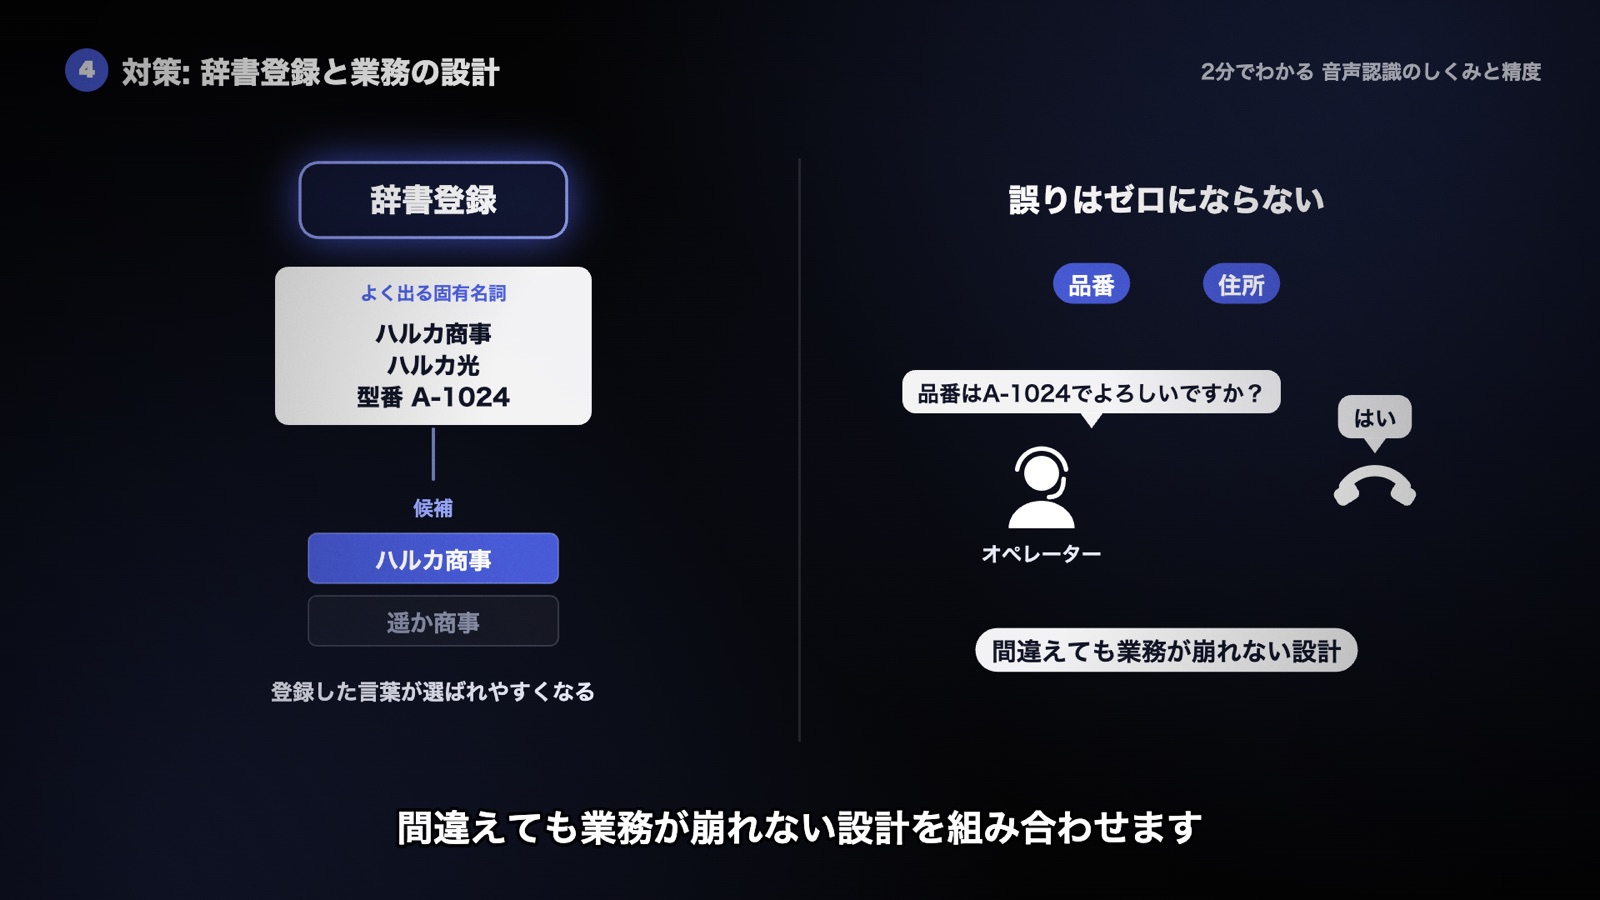
対策の基本は辞書登録です。自社の社名や商品名など、応対でよく出る固有名詞を登録しておくと、その言葉が候補として選ばれやすくなります。ひとつ目の固有名詞のつまずきに、直接効く手当てです。
ただし、辞書登録をしても誤りはゼロにはなりません。そこで、間違いが起きる前提で業務を組み立てます。たとえば品番や住所のように、一文字違うだけで困る情報は、オペレーターやボイスボットが復唱してお客さまに確かめます。認識の精度を上げる工夫と、間違えても業務が崩れない設計の両方をそろえることが、現場で音声認識を使いこなす近道です。
AIが入るところ: 音声認識はすべての音声AIの入口
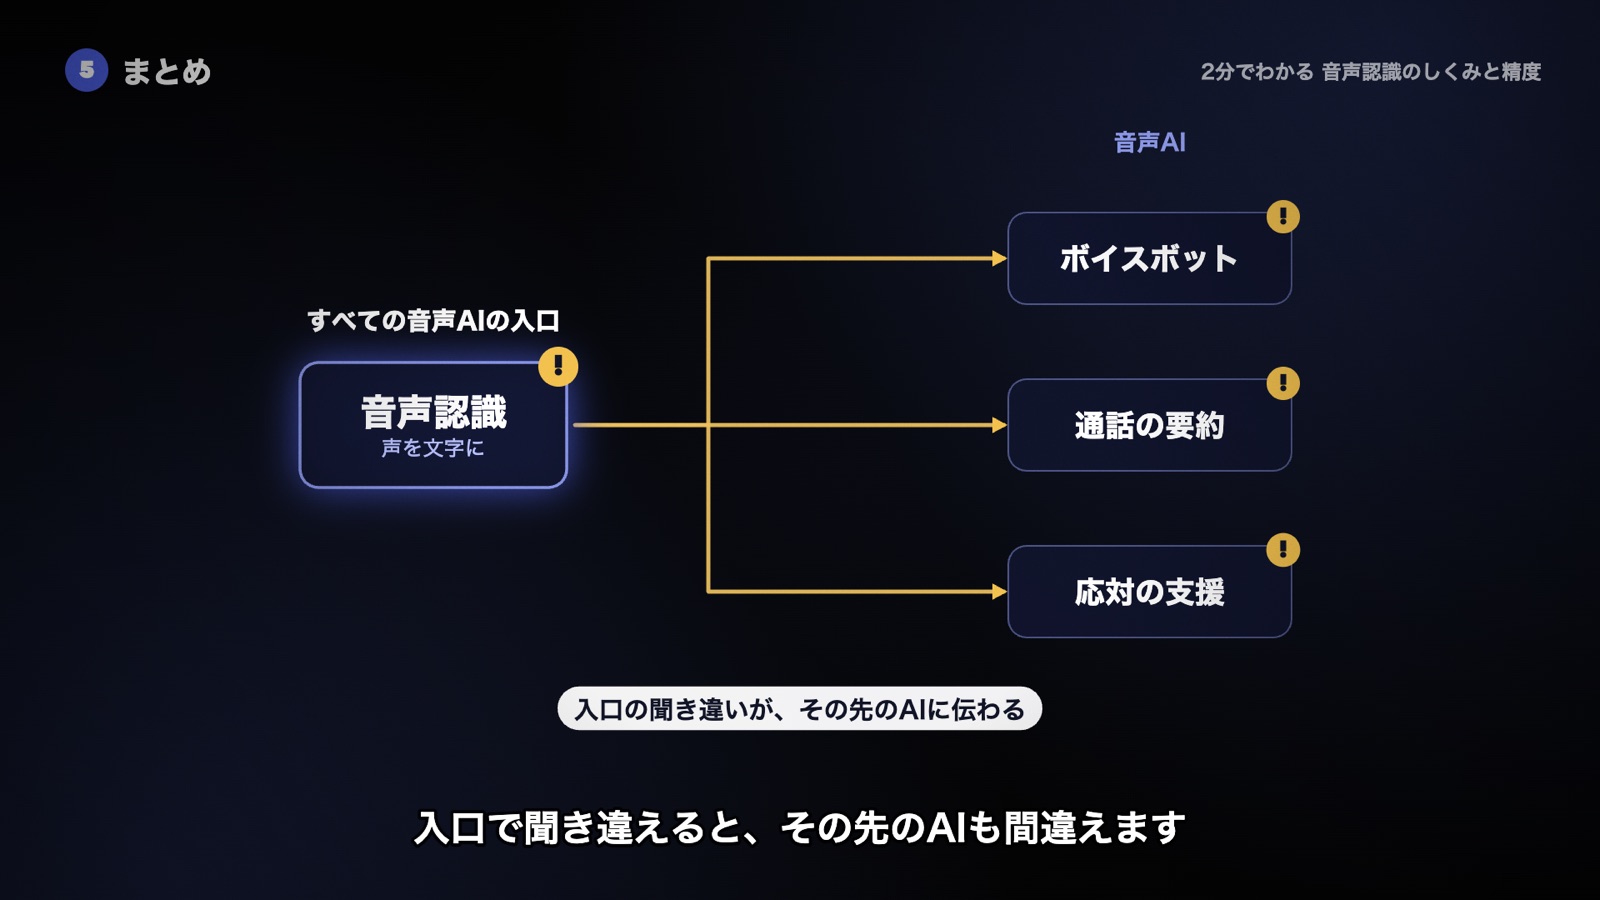
ボイスボットも、通話の要約も、オペレーターの応対の支援も、コンタクトセンターの音声AIはどれも音声認識から始まります。お客さまの声をまず文字にし、その文字をもとに次の処理が動くからです。
裏を返せば、入口で聞き違えると、その先のAIも間違えます。音声AIを選ぶときや、要約・応対の支援の出来を評価するときは、その手前の音声認識がどんな条件で、どれだけ正しく文字にできているかから確かめてみてください。
用語メモ
- 音声認識(ASR): 声を文字に変える技術です。音の波から、学習した言葉の中で最もありそうな並びを選んで文字にします。
- 話者分離: 通話の中で、オペレーターとお客さまのどちらが話したかを分ける処理です。
- 認識率(認識精度): 正解の文と比べて、どれだけ言葉を正しく文字にできたかを表す値です。何を、どんな条件で測ったかで値が変わります。
- 固有名詞: 社名や商品名など、特定のものを指す言葉です。学習で出会う回数が少なく、音の似た一般的な言葉に置き換わりやすくなります。
- 辞書登録: よく出る固有名詞などを登録し、その言葉が候補として選ばれやすくする対策です。
- 帯域: 音声として届く音の高さの範囲です。電話では高い音が削られた狭い帯域で届きます。
- 復唱: 聞き取った内容を読み上げて相手に確かめることです。品番や住所など、誤りが許されない情報で使います。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。