多言語対応はどこまで現実的か ー 翻訳精度と責任範囲の線引き

外国語で119番に電話がかかってきたとき、日本の消防本部の多くは、人の通訳者を交えた三者通話で受ける仕組みを整えている。総務省消防庁の集計では、電話通訳センターを介した三者間同時通訳を導入した消防本部は、2025年1月1日現在で720本部中673本部にのぼる。通報者と指令員の間に通訳者が入り、24時間365日、主要な言語で対応する仕組みだ。
一方で、コンタクトセンター(コールセンター)の側では、AIが通話をその場で訳す機能が出始めている。そこで問いたい。外国語の問い合わせを、AI翻訳でどこまで受けてよいのか。そして誤訳が起きたとき、その責任は誰が持つのか。
私の立場を先に書く。判断の軸は「翻訳精度が何%か」ではない。「重大な誤訳に誰が気づき、誰が引き取れるか」で、用件と言語ごとに対応レベルを決めるべきだと考えている。
言語ごとの音声AIの対応度は、7月の記事で認識・合成・業務判断の3層に分けて整理した。リアルタイム音声翻訳が言語別キューとルーティングをどう変えるかは、9月のZendesk解説で扱った。本稿はその続きとして、精度・責任範囲・エスカレーション先の3点に絞る。
1. 精度の問題は「平均」ではなく「重大な誤り」の問題
機械翻訳の限界について、提供側がどう書いているかを見ておきたい。Microsoftの翻訳サービスの透明性ノートは、実務で押さえておくべき点を率直に並べている。
第一に、品質は言語の組み合わせで違う。同文書は、翻訳の標準的なテストセットが確立していないため自社の測定スコアを公表しないとし、利用者が自分の場面を代表するテストセットで品質を測るよう勧めている。第二に、翻訳結果に信頼度スコアを返さない。つまり、どの文が怪しいかをシステムは教えてくれない。第三に、音声認識と翻訳のように誤りを含む仕組みを連ねると、誤りは積み重なる。認識の段階で聞き違えた語は、翻訳の段階では取り戻せない。
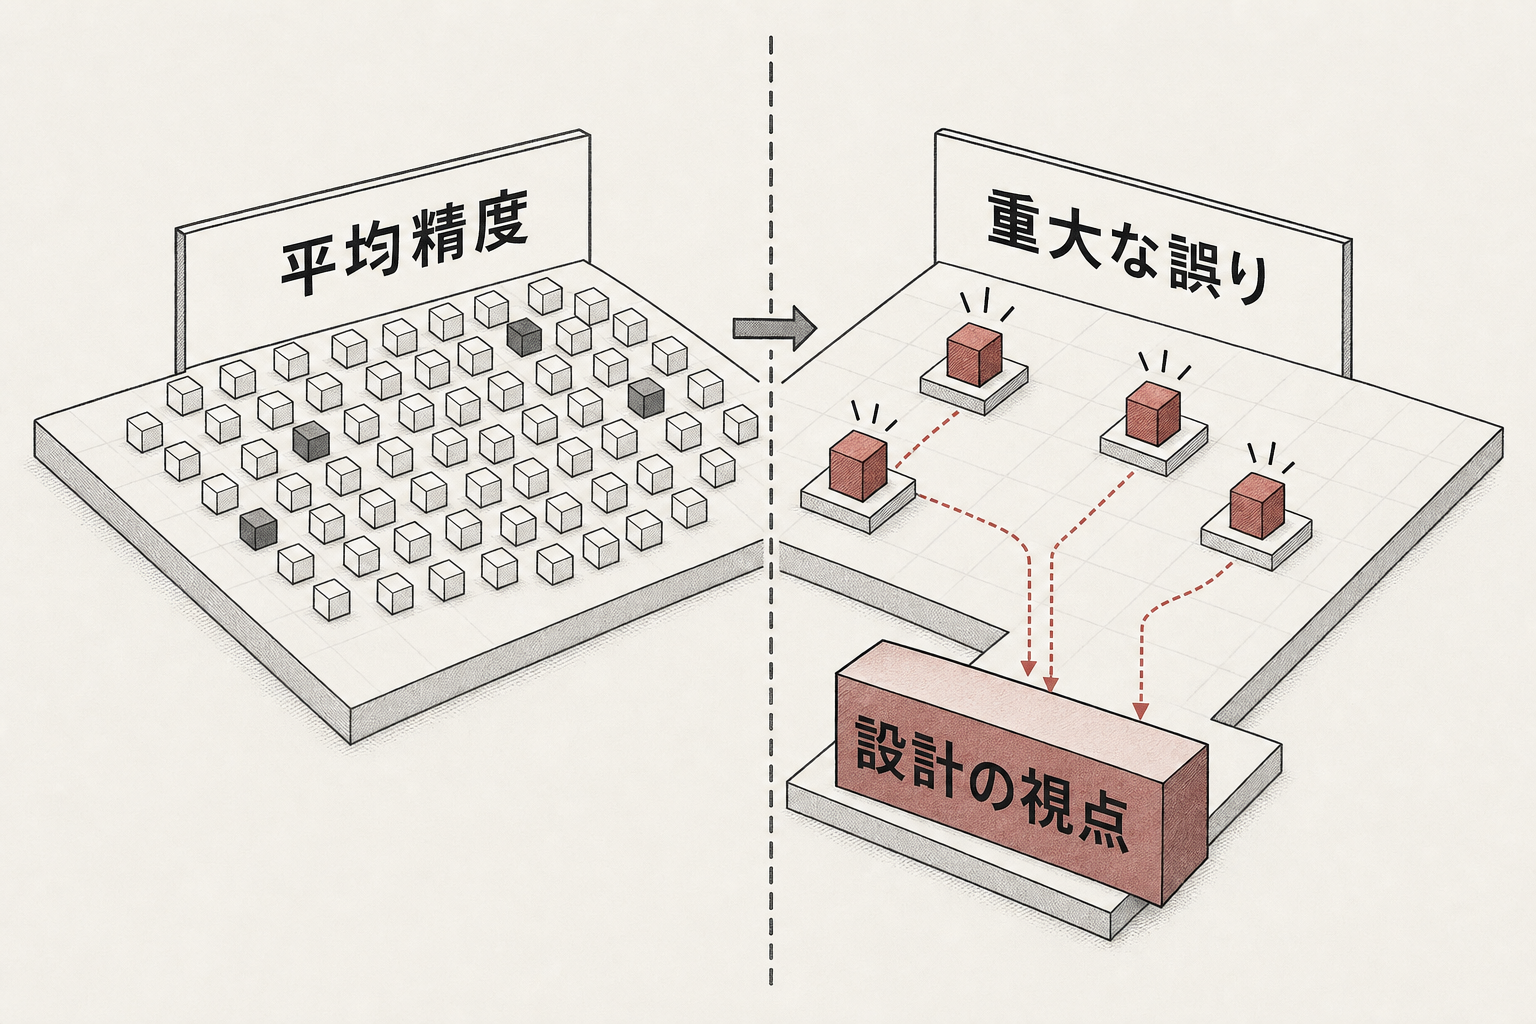
とりわけ重要なのが、同文書が「高重大度の誤り」と呼ぶ類型だ。否定が反転する(「しないで」が「して」になる)、数値や単位・通貨が変わる、原文の一部が抜け落ちる、原文にない内容が流暢に付け加わる。同文書は、こうした誤りは今日のシステムではまれだとしつつ、見つけて直すのは現状では人の方が得意だと書いている。
ここで当て馬として「翻訳精度は平均でほぼ正確」といった平均値の議論を置いてみる。平均値は、問い合わせ全体の聞き取りやすさを語るには役立つ。しかしコンタクトセンターで効くのは平均ではない。返金額の桁が1つずれる、「解約しないでください」が「解約してください」と伝わる。この1件が、平均値の良し悪しと無関係に苦情や損失になる。精度の議論は、平均から重大な誤りの側へ視点を移して初めて、設計の話になる。
翻訳AIは、分からないときに「分からない」と言わない通訳のようなものだ。人の通訳なら聞き返すところを、流暢な訳文で埋めてしまうことがある。この性質を前提に、どこで人が確かめるかを決めておく必要がある。
2. 責任範囲は、ツールの提供側ではなく使う側に残る
では、誤訳の責任は誰が持つのか。ここでも提供側の文書が手がかりになる。
Microsoftの透明性ノートは、人の重要な権利に関わる場面や機微なデータを扱う場面では、人が確認する工程を入れることを求めている。給付の支給・不支給の判断については、設計も評価もしていないとする。契約書などの法的文書は、サポート対象外の用途として挙げている。さらに、機微な用途や高リスクの用途で使うなら法律の専門家の助言を得て、将来の問題を解決する責任が利用者側にあることを理解するよう書いている。提供側は、使い道の線引きと最終的な判断を利用者に委ねている。
同じ線引きは、日本の医療の現場向けにも示されている。厚生労働省の医療機関向けマニュアル(第4.0版)は、翻訳ツールで診療すると誤訳があっても確認できない場合があり、診療上のトラブルにつながるリスクがあるとして、日常会話に使用を限定するなど院内で十分にリスクを管理しながら使うことを推奨している。すぐにできる対策として、訳文を元の言語に訳し戻す「再翻訳」で確認する方法も挙げる。遠隔通訳の使い分けについても、インフォームド・コンセントの場面では映像通訳を使い、それ以外はコストの低い電話通訳を使うという考え方を例示している。
医療と通話窓口は違う、という反論はありうる。もっとも、「重い場面ほど人の通訳を挟み、軽い場面は機械翻訳で受け、訳し戻しで確かめる」という構造は、契約・金銭・本人確認を扱うコールセンターにもそのまま当てはまる。
製品の側にも、現時点の制約がある。Zendeskのヘルプ記事は、10月から早期アクセス(closed EAP)で提供されるリアルタイム音声翻訳について、品質と遅延が言語・音声品質・訛り・ネットワーク状況で変わりうると書く。対応言語は日本語・英語・中国語・韓国語・ベトナム語など13言語で、翻訳を有効にした通話は多者通話・転送・モニタリングやバージに対応しない。翻訳中の通話から、そのまま人の通訳やSVへ渡せない場合がある、ということだ。製品ごとに条件は違うため、導入前に「翻訳中の通話から誰に、どう渡せるか」を確認しておきたい。
3. 用件の重さ×言語で対応レベルを切り分ける型
ここまでの事実から、実務で使える型を3つ抜き出す。以下の表と手順は、特定製品の仕様ではなく編集部の設計案である。
型1: 用件の重さで4段階に分ける
レベル | 用件の例 | 翻訳の扱い | 人が入る地点 |
|---|---|---|---|
L1 案内 | 営業時間、配送状況、FAQで答えられる質問 | 機械翻訳で完結してよい | 顧客が理解できていない兆候があれば人へ |
L2 受付 | 住所変更、予約、手続きの受付 | 機械翻訳+要点の復唱や再翻訳での確認 | 受付内容をテキストで控えとして送る |
L3 金銭・約束 | 返金、請求、解約、本人確認、苦情 | 機械翻訳は補助にとどめる | 人の通訳を呼べる経路が必須 |
L4 安全・権利 | 事故、健康被害、法的な権利に関わる申し出 | 言語を問わず人の通訳が主 | 最初から人 |
なぜ効くのか。高重大度の誤りが起きたときの損害は、用件の重さに比例するからだ。L1での誤訳は聞き直しで済むが、L3での誤訳は金額や契約の誤りとして残る。
型2: 言語ごとに「どのレベルまで機械で受けるか」を自社で測る
同じL2でも、言語によって任せられる度合いは違う。提供側の対応言語リストに載っていることと、自社の通話で使えることは別だ。自社の実際の通話(固有名詞・商品名・金額・訛りを含むもの)を言語ごとに数十件集め、訳し戻しで重大な誤りの有無を数える。その結果で「英語はL2まで」「対応言語リスト外の言語はL1もテキスト誘導」のように、言語×レベルの表を作る。Microsoftが勧める「自分の場面を代表するテストセットで測る」を、コールセンター向けに置き換えた手順である。
型3: エスカレーション先を、機械翻訳の導入より先に確保する
L3・L4を人へ渡すには、渡し先が要る。厚生労働省のマニュアルが説明する三者間通訳は、外国語の電話を受けた職員がいったん保留し、電話通訳サービスの専用番号へかけることで、職員・顧客・通訳者の三者で同時に話す方式だ。119番の仕組みも同じ形をしている。訪日客の相談であれば、JNTOのJapan Visitor Hotlineが英語・中国語・韓国語で24時間365日、事故や急病時の支援と観光案内を受けている。自社で受けきれない用件の案内先として把握しておく価値はある。通訳者がつかまらない時間帯の予備として、やさしい日本語のガイドライン(出入国在留管理庁と文化庁が2020年8月に作成)に沿った言い換えを応対スクリプトに用意しておく手もある。
機械翻訳から人への引き継ぎは、エスカレーション設計の記事で扱った「渡し方」の問題そのものでもある。多言語では、渡す先の人が同じ言語を話せるとは限らない点が一段難しい。
4. ここからは私の見立てとして
以上を踏まえて、見立てを述べたい。多言語対応の現実的な到達点は「全言語を人と同じ水準で」ではなく、「対象言語ではL1〜L2を機械翻訳で受け、L3は主要な数言語について人の通訳へ確実につなぎ、L4は言語を問わず人」という形だと考えている。対応言語数を増やすことより、L3以上を渡せる経路の確保に先に予算を使う方が、事故は減る。
ここで自分の主張に反証を当てておく。「翻訳AIの品質は急速に上がっているのだから、この線引きはすぐに古くなるのでは」という見方はありうる。確かに、L2とL3の境目は技術の進歩で上へ動くだろう。しかし、線がどこにあっても残る問いがある。翻訳システムが自分の誤りを知らせてくれない以上、誤りに気づく手段と、誤りが起きたときに説明する主体は、技術では決まらない。品質が上がるほど人は訳文を疑わなくなる。その分、確認の工程を仕組みで残しておく意味は増すとも言える。
だとすれば、多言語対応を「現実的」にする条件は3つに絞れる。自社の通話サンプルで言語ごとに重大な誤りを測っていること。用件をL1〜L4に分け、機械翻訳で受ける上限を決めていること。L3以上を渡す通訳の経路と、録音や記録のどれを正本にするかを、導入前に決めていること。この3つがそろって初めて、対応言語の数が意味を持つ。
まとめ
第一に、翻訳精度は平均値ではなく、否定の反転や金額の誤りといった重大な誤りの側で見る。翻訳システムは誤りを自分から知らせないため、どこで人が確かめるかを設計で決める必要がある。
第二に、誤訳の責任範囲は提供側ではなく使う側に残る。提供側の文書も医療向けの国のマニュアルも、重い場面では人を挟み、軽い場面に機械翻訳を限定する線引きを示している。
第三に、対応レベルは用件の重さと言語の掛け合わせで決め、機械翻訳の導入より先に人の通訳へ渡す経路を確保する。
最後に問いを残したい。あなたのセンターで外国語の通話が返金や解約の話に進んだとき、その通話を次に誰へ渡すかは決まっているだろうか。
注記
本稿の事実は2026年9月18日時点で公開情報を確認した。消防本部の導入数は総務省消防庁の2025年1月1日現在の集計。Zendeskのリアルタイム音声翻訳は2026年9月時点で早期アクセス段階の記載であり、対応言語や制約は変更の可能性がある。Microsoftの記述は同社の翻訳サービスに関する文書であり、他社製品の性能を示すものではない。3章の4段階の表と手順は編集部の設計案で、特定の製品や事業者の推奨ではない。4章の見解は筆者(相原ことは)の個人的な見立てを含む。個人情報を外部の翻訳サービスや通訳事業者に渡す場合の法的な整理は、専門家に確認されたい。
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。