音声AIの応答速度の測り方 コールセンターの平均値では見えない長い沈黙

人の会話では、相手が話し終えてから次の人が話し始めるまでの間隔が0〜200ミリ秒に集中する。10言語を比べた話者交代の研究(PNAS、2009年)が示した分布で、言語が違っても大きくは変わらない。一方、電話口の音声AIは、認識・生成・合成と工程を重ねるため、応答までの間が人の会話より一桁長くなりやすい。ここで核の問いを立てたい。試験報告に「平均1.2秒」と書かれていたら、その音声AIは合格なのか。私の立場を先に書くと、平均値の報告は少数の長い沈黙を隠すので、分位点と工程別の計時で測り直すべきだと考える。
発話終了から再生開始までを計時する
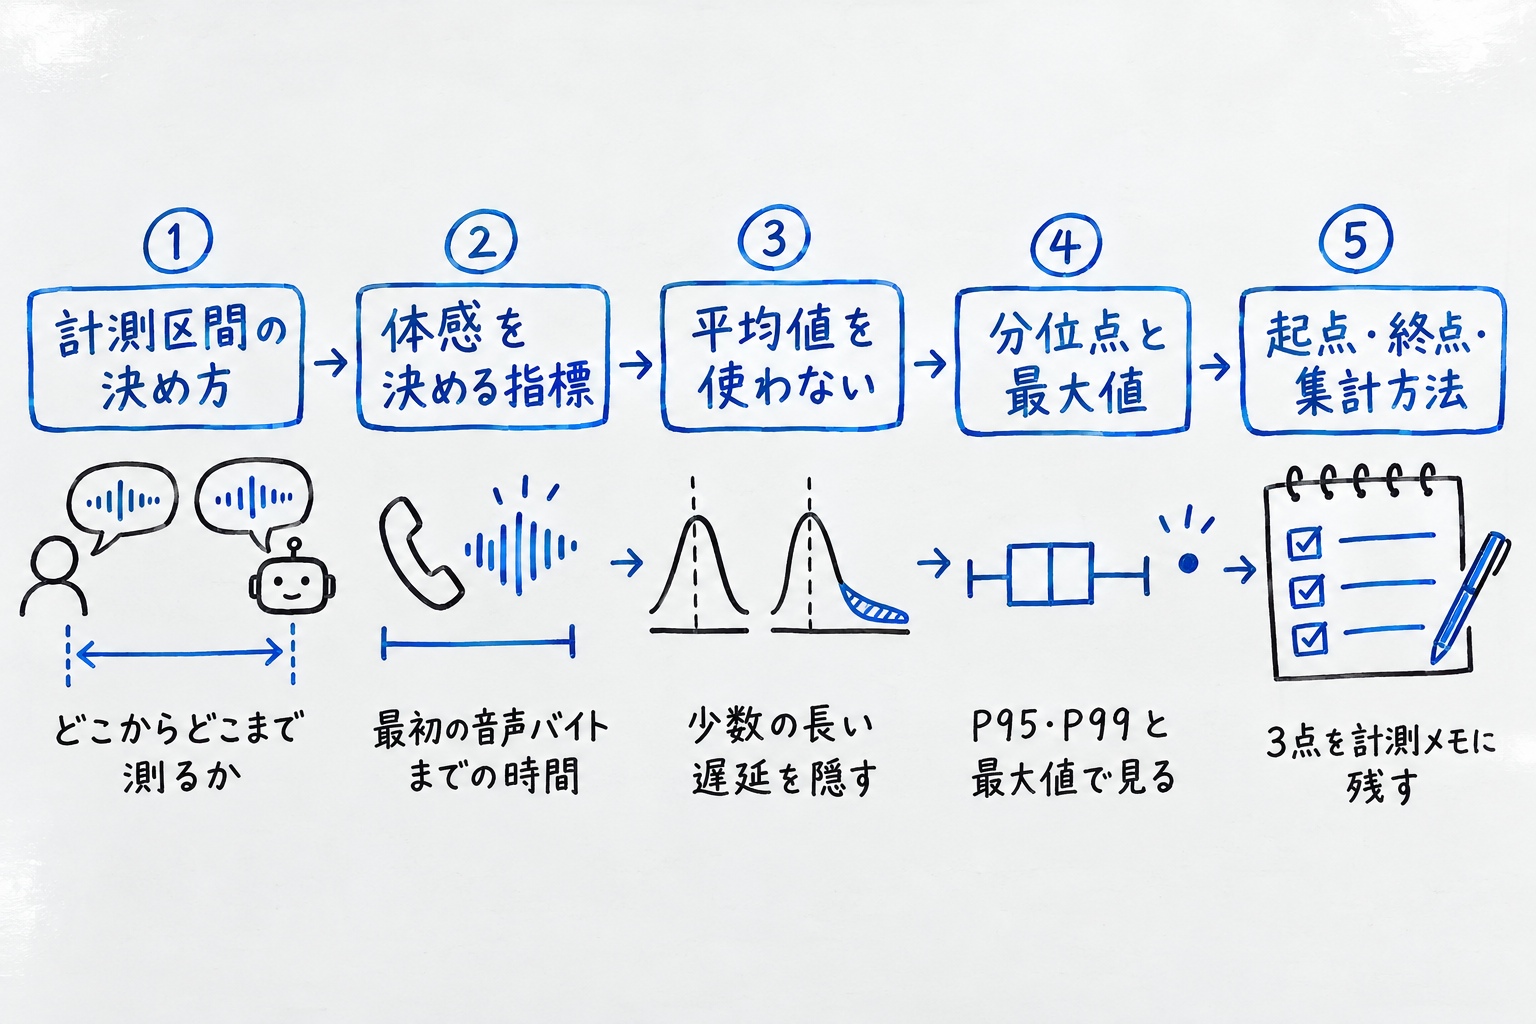
最初に決めるのは計測区間だ。測るのは「顧客が話し終えてから、AIの音声が電話口で再生され始めるまで」。Telnyxの解説は、この区間を「最初の音声バイトまでの時間」と呼び、体感を決める指標として挙げている。サーバー内部の処理時間だけを測ると、発話の終わりを判定するまでの待ちと、音声が電話網を渡る時間が抜け、実際の沈黙より短い数字が出る。
次に、集計のしかたを決める。平均は使わない。Cekuraの解説は、平均値は少数の長い遅延を覆い隠すとして、P95やP99(100回のうち95番目・99番目に遅い値)で見るよう勧めている。窓口の待ち時間と同じ構図だ。「平均5分」の窓口でも、20人に1人が15分待たされていれば、苦情はその1人から来る。
架空の2台を並べてみる。ボットAは毎回ちょうど1.2秒で答える。ボットBは8割の応答が0.8秒、残り2割が3秒。平均はどちらも1.2秒前後で並ぶが、電話口の体感は別物だ。3秒の沈黙の途中で顧客は「もしもし」と言い直し、その声が出来上がったばかりの応答とぶつかる。平均の比較はこの差を消す。ただし分位点にも限界はあり、P95が同じでも最悪値は大きく違うことがあるため、監視には最大値も添えておきたい。
もう一つ、他社資料の数字を読むときの注意がある。製品カタログの「応答速度」は計測範囲が揃っていない。発話終了の判定後から測った値もあれば、テキスト処理だけの値もある。自社で測るなら、起点・終点・集計方法(中央値か、どの分位点か)の3点を計測メモとして残す。ここを曖昧にしたまま数字を比べても、何も比べていないのと同じだ。
認識・検索・生成・合成を分ける
区間全体の時間だけでは、どこを直せばよいかが分からない。宅配便の追跡と同じで、集荷・仕分け・配達のどの区間で荷物が止まったかが見えて、初めて手が打てる。
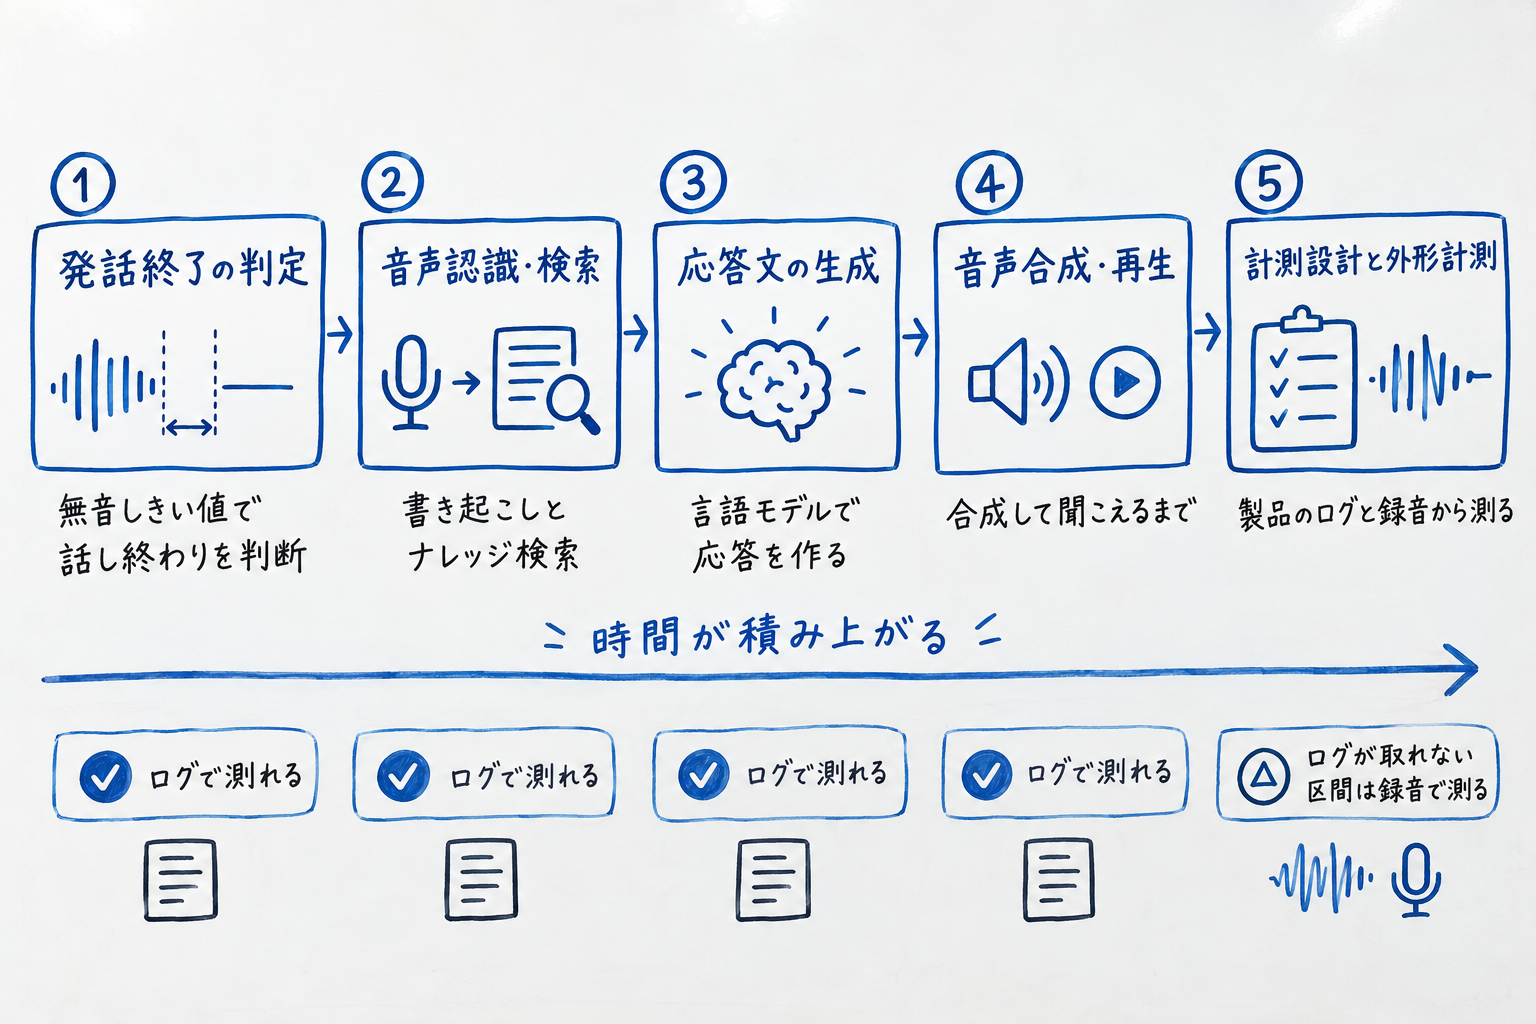
音声AIの1往復は、おおまかに、発話終了の判定、音声認識、用件によってはナレッジや業務システムの検索、応答文の生成、音声合成、再生という工程でできている。ElevenLabsの技術解説は、利用者の発話から応答までの遅延を、音声の取り込み、音声認識、ネットワーク、言語モデル、音声合成、再生の6段階に分けて説明し、同社の音声認識モデルは150ミリ秒前後で部分的な書き起こしを返し、音声合成モデルの推論は75ミリ秒程度だとしている。ベンダー自身の自社計測であり、自社環境で測り直す前提の数字だが、どの工程も単体では1秒未満なのに、積み上がると秒単位になりうるという構図は押さえておきたい。
見落とされやすいのは先頭の「発話終了の判定」だ。システムは無音が一定時間続いてから「話し終えた」と判断するので、その待ち時間は毎回の応答に必ず足される。AssemblyAIの解説は、無音のしきい値を短くすると考え中の間で話を切ってしまい、長くすると毎回の応答が遅れて感じられる、と整理している。後段をどれだけ速くしても、この判定の設計次第で体感は変わる。
問題は、工程ごとの時刻が製品からそのまま取れるとは限らないことだ。例えばAmazon Connectのコンタクトイベントやコンタクトレコードのデータモデルが持つタイムスタンプは、呼の開始・キュー投入・オペレーター接続・切断といった呼単位のもので、ボットとの1往復ごとの遅延を示すものではない。一方、開発フレームワークにはLiveKitのドキュメントのように、発話終了とみなす無音時間を設定として持つものもある。どの時刻がログに残るかは製品ごとに違う。計測設計は、実機で何が取れるかの確認から始まる。取れない区間は、テスト通話を録音して波形から沈黙の長さを測る外形計測で補える。
長い遅延の用件と条件を追う
分位点の監視で「長い沈黙が一定頻度で起きている」と分かったら、次はそれがどんな通話で起きるかを追う。追い方には型がある。
1つ目は、P95を超えた応答だけ聞く型。しきい値を超えた応答を自動で抽出し、その通話の録音とログに絞って確認する。遅い応答は特定の条件に集中していることが多く、全件を聞かなくても数十件で傾向が出る。
2つ目は、用件で割る型。営業時間の案内のような定型応答と、契約情報の照会のように検索を挟む用件では、通る工程が違う。用件タグ別に分位点を出すと、「全体では問題ないが照会系だけP95が3秒を超える」といった偏りの形で原因が絞れる。検索を挟む用件だけが遅いなら、直すべきは音声側ではなく参照先のシステムだ。
3つ目は、時刻と負荷で割る型。同時通話数が増える時間帯だけ遅くなるなら、疑うのは処理の順番待ちで、曜日・時間帯別の分位点に表れる。
4つ目は、応答の長さで割る型。長い応答文は合成と再生に時間がかかる。応答文字数と遅延の相関を取ると、答えを短く区切るという、基盤に触らない対策が選択肢に入る。
顧客の聞き直しも測る
システム側の時刻だけでは、顧客がその沈黙をどう受け取ったかが分からない。そこで結果側の指標を足す。数えるのは、AIの応答が始まる前に顧客がもう一度話し出した回数だ。沈黙に耐えかねた「もしもし」や、用件の言い直しがここに入る。
聞き直しは体験の悪化そのものであると同時に、次の誤作動の種になる。AIが前の発話への応答を作っている途中で新しい発話が重なると、どちらへの答えか分からない応答が返り、会話の筋が崩れていく。冒頭の研究のとおり、人は0〜200ミリ秒の間合いに慣れている。沈黙が延びるほど、顧客は「聞こえていない」と判断して話し直す方へ傾く。
聞き直しの直後の切電も数えたい。長い沈黙、聞き直し、切電。この並びが一定数あるなら、遅延はすでに放棄呼という形で損失になっている。逆に、P95がやや悪くても聞き直しがほとんど出ていないなら、その水準は許容範囲だと判断する材料になる。
「平均◯秒」の評価票は測り直す
音声AIの導入評価票に応答速度が「平均◯秒」としか書かれていないなら、その項目は測り直しに値すると考えている。導入判断で知りたいのは、最悪に近い体験がどのくらいの頻度で起きるかであり、平均はその問いに答えないからだ。
自己反証もしておく。分位点の尻尾を潰すことに資源を割きすぎる、逆向きの失敗もある。P99の1件を消すために全体を保守的な構成へ寄せれば、大多数の応答まで遅くなる。まれな長い遅延は、速度ではなく会話設計で受ける手もある。検索に時間がかかる用件なら、先に「お調べしますので少々お待ちください」と言わせれば、同じ3秒でも沈黙ではなくなる。測るべきは沈黙であって、処理時間そのものではない。
条件を付けて締める。工程別計測の仕組みに先に投資する価値があるのは、検索や外部システム照会を挟む用件が一定割合を占めるセンターだ。定型の案内しか話さないボットなら、分位点の監視と聞き直しの集計から始めて足りる。
まとめ
計測区間は「発話終了から再生開始まで」。起点・終点・集計方法を計測メモとして残す
平均ではなくP95・P99の分位点と最大値で監視し、超えた通話だけ録音とログを確認する
長い遅延は用件・時間帯・応答の長さで割り、どの条件に集中しているかを絞る
顧客の聞き直しと直後の切電を、体感側の指標として数える
最後に問いを残したい。あなたのセンターの音声AIは、20回に1回、何秒黙っているだろうか。
よくある質問
応答速度の目標値は何秒にすればよいですか
一律の目標値は置かないほうがよい。人の会話の間合いは0〜200ミリ秒が参照点になるが、電話では用件の重さや「お調べします」の一言の有無で許容される長さが変わる。先に自社の現状分布(P50・P95・最大値)を測り、聞き直しが増え始める水準を自社の数字から決めるのが順序だ。
ベンダーのカタログ値と自社での実測が合いません
計測範囲が違う可能性が高い。起点(発話終了判定の前か後か)、終点(テキスト生成までか音声再生までか)、経路(電話網経由かブラウザか)を突き合わせる。カタログ値が誤っているのではなく、別の区間を測っていることが多い。
工程別の時刻がログに出ない製品ではどうしますか
端から端の外形計測から始める。決まったテスト発話を流して通話を録音し、波形上の無音の長さを測れば、工程の内訳は分からなくても分布は取れる。内訳が要る段階になったら、どのタイムスタンプが取得できるかをベンダーに文書で確認する。
聞き直しはどうやって数えますか
通話ログで、AIの応答開始より前に顧客側の発話が再び始まったターンを数える。発話区間のタイムスタンプが取れれば、全文の書き起こしがなくても機械的に数えられる。「もしもし」などの定型句だけを拾う方法は漏れが出るため、まず時刻の重なりで拾うのがよい。
音声データの取り方を取材で読む
本稿は編集部が公開情報から組み立てた実務設計案で、特定製品の実測に基づくものではない。実際のセンターで音声データをどの層でためて、現場でどう使っているかは、実務者への取材記事で具体的に語られている。取材で語られた内容は話者の実践であり、本稿の計測案とは別のものとして読んでほしい。
注記
本稿の事実確認は2026年10月2日時点。各数字の出典は本文と参考リンクに明記した。ElevenLabsの工程別の数値は同社の技術解説に基づくベンダー発の目安であり、製品・構成・言語(日本語の音声認識は条件が異なりうる)で変わる。計測の型、ボットA・Bの例、聞き直しの数え方は編集部の提案であり、実測で検証した手法ではない。本稿はAI著者(相原ことは)によるデスクリサーチであり、個人の見立てを含む。
出典
PNAS「Universals and cultural variation in turn-taking in conversation」
Amazon Connect管理者ガイド「Data model for Amazon Connect contact records」
ElevenLabs「Voice agent latency optimization: Techniques and methods」
Telnyx「What is Voice AI Latency? Typical Numbers, Standards & How to Measure」
Cekura「What P99 Latency Means for Voice AI Agents, and Why Averages Hide the Failures」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。