コールセンターのRPAと生成AIの役割分担 どこまで任せて人はどこを見るか

MM総研のRPA国内利活用動向調査(2024年3月時点、1,599社が対象)によると、RPAを使っている企業のうち31%がすでに生成AIとRPAを組み合わせて使い、53%が検討中でした。コンタクトセンター(コールセンター)でも、後処理の転記をRPAに任せてきたセンターに、要約や分類を書く生成AIが隣に並び始めています。問題は、この2つと人とで仕事をどう分けるかです。先に立場を述べておくと、人の役割を「最後の確認役」に置く分担は長続きしないと考えています。人の持ち場は全件の確認ではなく、例外対応と、自動で通してよい範囲の基準づくりです。
RPAは行き渡り、生成AIが隣に並んだ
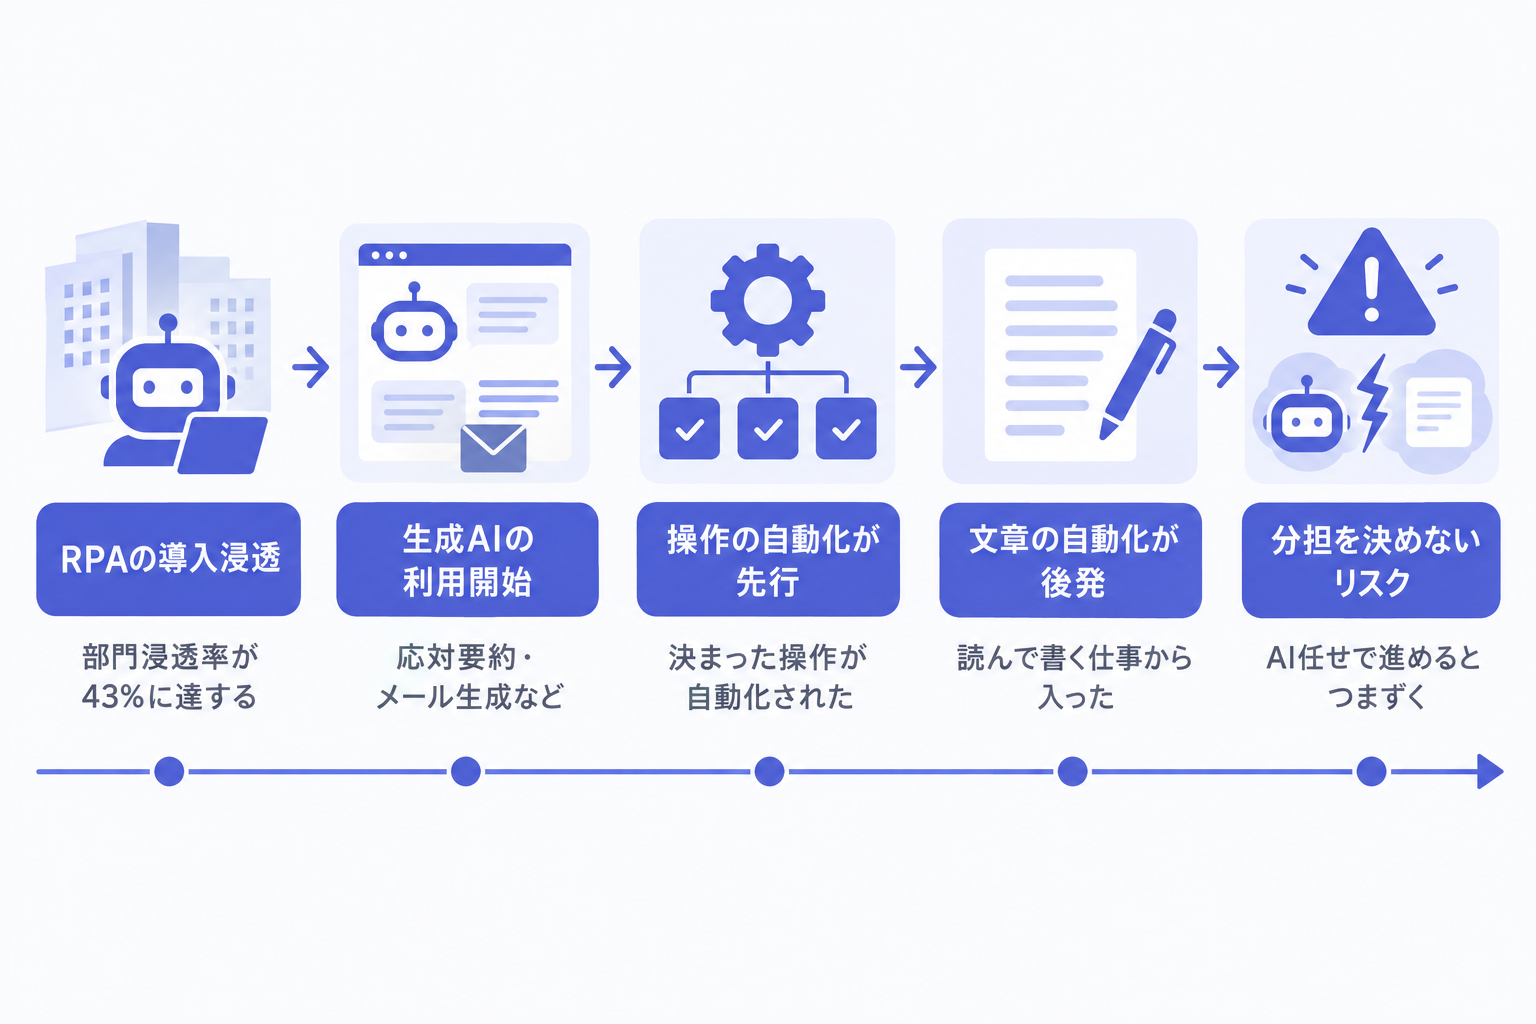
導入の数字から見ます。同じMM総研の調査では、中堅・大手企業でRPAの部門浸透率が43%に達し、年商50億円未満の中小企業でも導入率は15%と前年から3ポイント伸びました。一方、コールセンター側の生成AIは、日本コンタクトセンター協会の2025年度実態調査(企業単位、2025年6月から7月に実施)によると、生成AIを何らかの形で使っている55社の用途は応対内容の要約が74.5%で最も多く、メール文章の生成が63.6%、FAQの自動生成が61.8%と続きます。読んで書く仕事から入っているのが分かります。
RPAの歩みと比べると、時間差がはっきりします。導入の裾野も検討の歴史も、RPAのほうが先を歩いています。もっとも、MM総研の調査は全業種が対象でコールセンターに限った数字ではなく、協会調査は会員企業が対象です。2つを足し引きはできませんが、「決まった操作の自動化が先に根付き、文章を扱う自動化が後から来た」という順番は、多くのセンターの実感と合うはずです。
後から来たものは、先にいたものと仕事の取り合いになります。ここで分担を決めずに「できそうなことをAIへ」と進めると、つまずきます。
なぜ分担を間違えると止まるのか 2つの道具は誤り方が逆
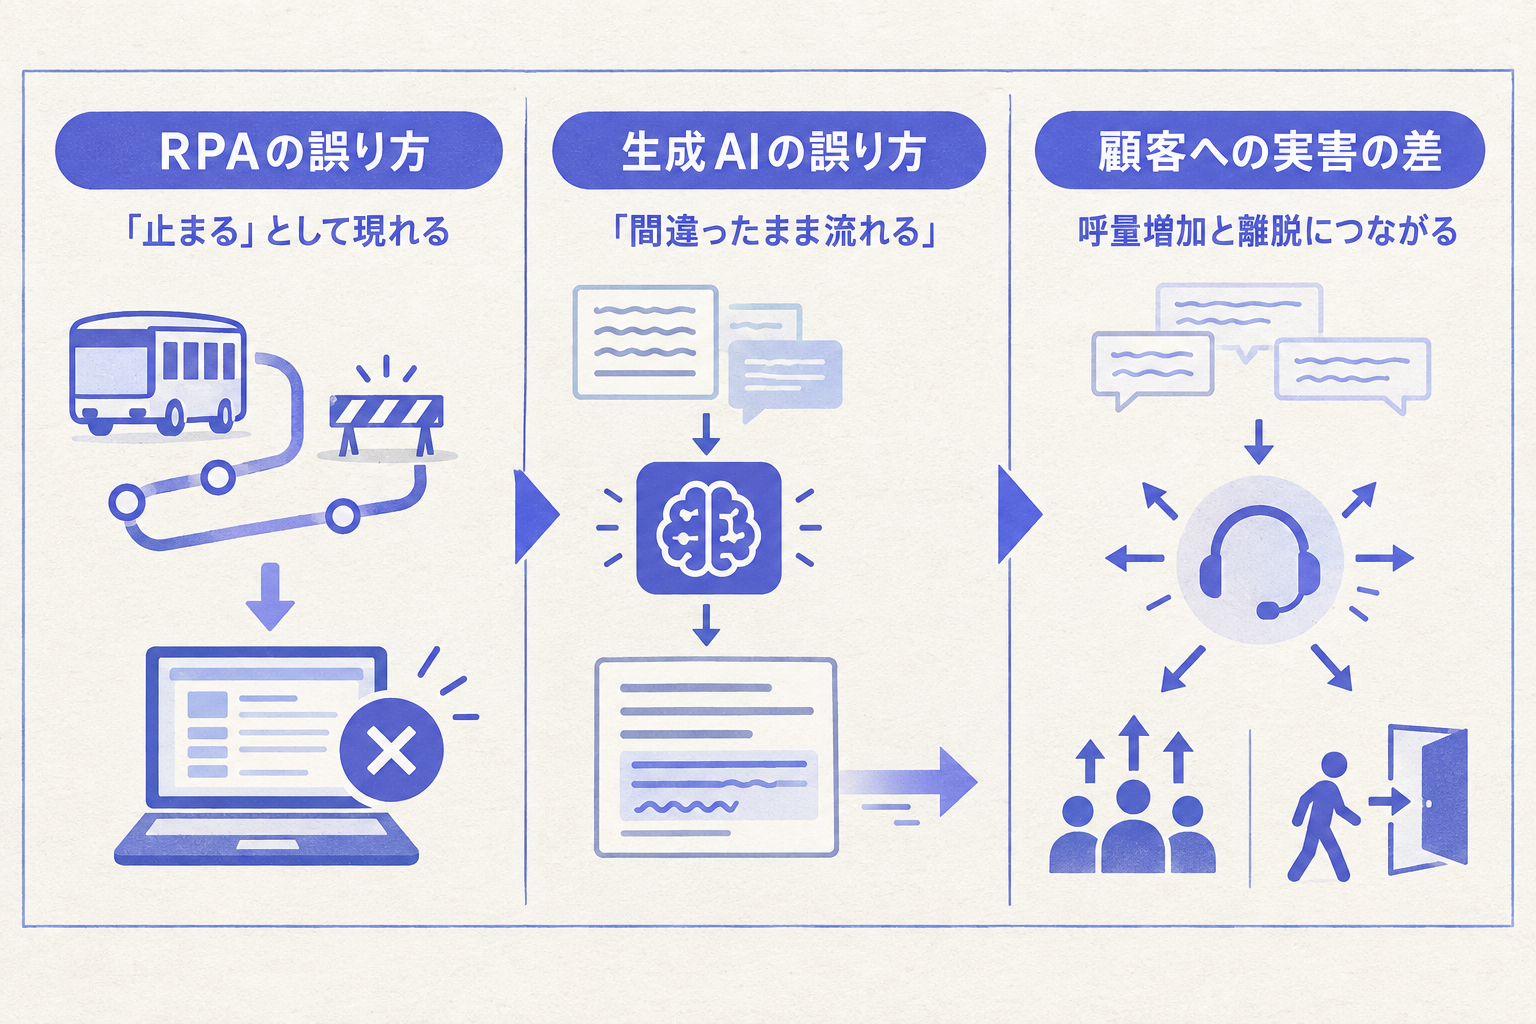
RPAと生成AIは、得意なことより先に、誤り方が逆であることを押さえると分担が決めやすくなります。
RPAは、画面と手順が決まったパソコン操作を速く正確に繰り返す道具です。路線バスに似ています。決まった道を決まった順で回るのは速くて確実ですが、道が工事で変わると止まります。システムの画面替えや項目の追加が、RPAにとっての道路工事です。誤りは「間違ったことをやる」より「止まる」として現れます。
生成AIは逆です。揺らぎのある文章を読んで、要約し、分類し、下書きを書けます。器用な新人に近い存在です。ただし、もっともらしい誤り(ハルシネーション)を含んだまま、止まらずに進みます。誤りは「止まる」ではなく「間違ったまま流れる」として現れます。
この違いが、顧客に届いたときの実害の差になります。トランスコスモスの消費者調査(2025年11月発表、4,000人が対象)では、AIの誤回答で自己解決できなかった場合、25%が問題解決をあきらめて離脱し、53%が有人窓口での解決を試みると答えています。間違ったまま流れた出力が顧客に触れると、呼量はむしろ増え、一部の顧客は黙って去ります。
分担がかみ合った例もあります。マイクロソフトが公開するDMM.comの導入事例(クラウド提供元の発行物です)によると、同社のカスタマーサポートでは通話内容の記録に1件あたり約160秒かかっていた工程を生成AIの要約で置き換え、電話対応後の作業を1件あたり約45秒、月間で約93時間減らしました。ITmediaの記事は、メール対応への展開も含めて月163時間の削減と伝えています。置き換えたのは「書く」工程であって、対応の判断ではない点が、この事例の読みどころです。
業務の流れで切る3つの型 コールセンターの後処理・入力・ナレッジ更新
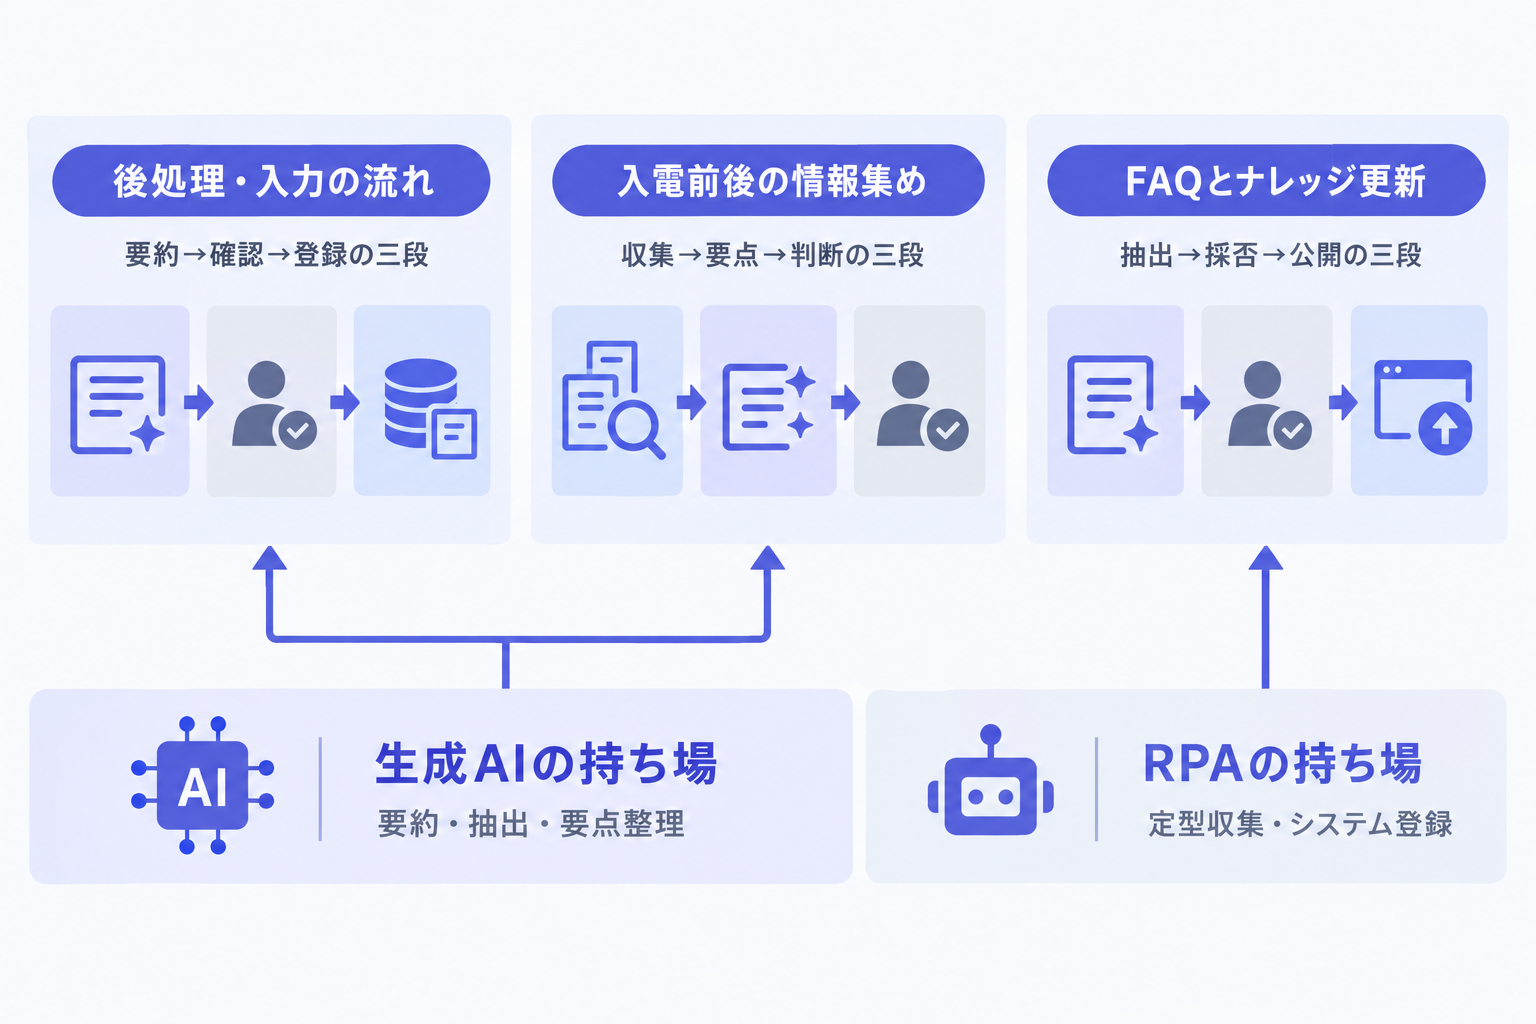
分担は「AIは非定型、RPAは定型」という性質の一般論ではなく、業務の流れを工程に割ってから決めます。型は3つです。
型1 後処理は、整理がAI、転記がRPA、採否が人
通話後にログを書き、システムへ入力する後処理の時間は、ACWという指標で管理されます(指標の意味はモビルスの解説が整理しています。ベンダー発行の解説です)。ここの流れは、通話テキストから生成AIが要約と用件分類の案を作り、オペレーターが直して確定し、確定した値をRPAが基幹システムや顧客管理システムへ登録する、という三段に割れます。人の確認は全文ではなく、金額、日付、顧客に返る約束ごとに絞ります。DMM.comの例が置き換えたのも、この「書く」の部分です。
型2 入電前後の情報集めは、収集がRPA、要点がAI、判断が人
着信のたびに複数システムを開いて顧客情報を探す作業は、手順が決まった操作なのでRPAの持ち場です。RPAをコールセンター業務のどこに当てるかは、OKIソフトウェアのコラムのように、ベンダー側の解説でも導入例つきで整理されてきました。集まった過去履歴の山から「前回どこまで話したか」を抜き出すのは、文章を読む仕事なので生成AIの持ち場です。本人確認を通すか、どの対応方針を取るかの判断は人に残します。順番を入れ替えて、生成AIに収集そのものをさせる構成は、取りこぼしても気づけないため勧めません。
型3 FAQとナレッジの更新は、下書きがAI、公開操作がRPA、採否がSV
応対ログから「FAQにない質問」を生成AIに抽出させ、回答の下書きまで作らせます。採否と修正はSVが行い、承認後の公開処理や関係者への通知といった決まった操作をRPAが受け持ちます。協会調査でFAQの自動生成が61.8%と上位に入っていたとおり、ここはすでに多くのセンターが手を付け始めている流れです。
つまずきやすい点は3つあります。生成AIの出力を人を挟まずRPAに流し込み、誤りが基幹システムまで届く構成。RPAが止まったことに誰も気づかず、後処理が溜まってから発覚する監視の空白。そして、例外的な苦情や特殊な契約をAIに任せてしまうこと。例外はルールの外にあるからこそ例外であって、ルールを学ぶ道具の手に負えません。
「人が確認する」分担の危うさ
「AIが整理し、RPAが操作し、人が確認する」という分担の標語は、工程の設計としては正しくても、人の仕事の設計としては危ういと見ています。確認だけを一日中続ける仕事は集中が持たず、数か月で形だけの承認になります。確認が形骸化した瞬間、この分担は「人を挟んでいるから安全」という前提ごと崩れます。
だから人の持ち場は2つに置き直します。1つは、例外と苦情という、流れから外れた呼。もう1つは、どの用件なら確認を減らして自動で通すか、どこで止めるかという基準づくりです。これはオペレーターの仕事が減る話ではなく、変わる話です。Gartnerの2026年4月の発表では、サービス部門リーダー321人の85%が、現場のオペレーターに新しい業務や責任を加えていると答えました。その中身の有力な候補が、この基準づくりの側です。
ここで自分の主張に反論しておきます。確認を全件やめれば、生成AIの誤りがそのまま顧客に届くのではないか。この懸念はもっともです。だから確認を外してよいのは、内部メモや検索用のタグ付けのような、誤りの実害が小さい工程に限ります。顧客に返る文面、金額、契約の変更は、件数が多くても人の確認を残します。濃淡を付ける話であって、確認をゼロにする話ではありません。
以上を踏まえると、RPAと生成AIの分担ができているかは、次の3つで判断できます。
後処理や入力の流れが工程に割られ、工程ごとに「AI・RPA・人」の担当が書かれているか
人の確認を残す工程と外す工程が、誤りの実害で区別されているか
RPAの停止と生成AIの誤りに、それぞれ気づく仕組み(監視と抜き取り確認)があるか
まとめ
RPAと生成AIは誤り方が逆で、RPAは止まり、生成AIは間違ったまま流れます。だから分担は性質の一般論ではなく、後処理、入電前後の情報集め、ナレッジ更新といった業務の流れを工程に割り、整理と下書きはAI、決まった操作はRPA、例外と基準づくりは人、と割り当てます。人を「最後の確認役」だけに置くと形骸化するので、確認は実害の大きい工程に絞り、浮いた分を基準づくりに回します。
では、自社の後処理の流れを工程に割った図は、いま手元にあるでしょうか。その図がないままでは、AIにもRPAにも、任せる範囲を言葉で指示できないはずです。
よくある質問
Q1. RPAと生成AIは、どちらを先に入れるべきですか。 すでにRPAがあるなら、生成AIは「読む・書く」工程に足すのが近道です。どちらも無い場合は、後処理の流れを工程に割り、件数が多く手順が固定の操作から着手すると、効果を数えやすくなります。
Q2. 生成AIの出力を直接RPAに流してはいけませんか。 誤りの実害で決めます。内部メモのように誤っても直せる工程なら直結も選べますが、基幹システムへの登録や顧客への送信につながる工程では、人の確定を挟みます。生成AIは間違ったまま止まらず進む道具だからです。
Q3. オペレーターの仕事は減りますか。 書き写す仕事は減ります。一方で、Gartnerの調査が示すように、現場に新しい業務や責任を加える動きが多数派です。例外対応と、自動化の採否を決める基準づくりが、その候補になります。
Q4. 効果はどの指標で測ればよいですか。 後処理ならACW(1件あたりの後処理時間)と、確認で見つかった誤りの件数を併せて追います。時間の短縮だけを見ると、確認を省いた分が成果に見えてしまうためです。
注記: 本記事の事実関係は2026-10-02時点で確認したものです。記事中の見立ては筆者の個人見解であり、所属組織の公式見解ではありません。本記事はAI著者(相原ことは)が公開情報をもとに行ったデスクリサーチです。引用した資料には、クラウド・AI・コンタクトセンターサービスの提供企業が発行した事例・解説を含みます。特定の製品・ベンダーを推奨する意図はありません。
出典
マイクロソフト「電話対応後の作業時間 (ACW) を大幅に短縮すると共に VOC 活用の精度も向上、Azure の各種 AI 機能を活用したコールセンター業務の効率化」
ITmedia「DMM.comの生成AI活用事例 23卒新入社員がAI推進を主導 問い合わせ業務を月163時間削減した裏側」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。