コールセンターRAGの検索精度を評価する 正解FAQに届くテストセットの作り方

Amazon Bedrockのナレッジベース評価には、生成を切り離して検索だけを対象にする評価ジョブがある。検索のみ評価のデータセット仕様では、質問と正解(referenceResponses)を組にしたJSON Lines形式で、1つのデータセットに最大1,000問まで入れられる。つまり主要なクラウド基盤が、RAG(検索拡張生成。質問に関係する社内文書を探してから回答を作らせる仕組み)の評価を「検索」と「生成」の二段に分けて扱い始めている。では、あなたのセンターのFAQ検索AIが間違った回答を返したとき、検索が外れたのか、生成が壊れたのか、切り分けられるだろうか。
本稿の立場を先に書く。回答の誤りの調査は、生成された文章ではなく、その手前の検索結果から始めるべきだと見ている。検索が正解FAQに届いていなければ、生成がどれほど流暢でも正しい回答は出ない。そのために要るのが、実際の質問と期待FAQを組にしたテストセットである。本稿では、その作り方と回し方を4つの手順に分け、編集部(相原ことは)の提案として示す。生成された回答文そのものの採点は本稿では扱わない。
手順に入る前に、なぜ検索から固めるのかを整理しておく。検索部分の良し悪しは、RAG評価の解説が整理するとおり、上位k件に正解が入っているか(再現率)、上位k件に無関係なものが混ざっていないか(適合率)という、検索エンジンの世界で使われてきた指標でそのまま測れる。正解さえ決めてあれば、採点は機械的に再現できる。一方、生成された文章の採点は人手では追いつかず、AIに採点させる方法が広がっているが、採点AIの偏りを定量化した研究は、回答の提示順や長さ、自分が生成した文への甘さなど、採点者側の偏りを複数報告している。生成の採点は便利だが、真値ではない。だから、機械的に白黒がつく検索の回帰テストを先に作る。これが本稿の骨子である。
実際の質問と期待FAQを組にする
テストセットの材料は、作文した想定質問ではなく、オペレーターや顧客が実際に打った質問である。問い合わせログやオペレーターの検索ログから原文のまま拾い、その質問に対して「このFAQが出てくるべき」という正解の文書IDを担当者が付ける。この1行が1テストケースになる。
ここで2つの偏りに気をつけたい。1つは頻度の偏りで、ログの上位から機械的に取ると、呼量の多い定型質問ばかりのセットになる。件数は少なくても間違えると損害が大きい質問、たとえば解約、障害、料金請求の類を意図的に混ぜる。もう1つは鮮度の偏りである。ナレッジ運用の方法論KCS v6は「利用こそがレビュー」という技法で、記事は使われるたびに見直されて初めて品質が保たれると説く。テストセットも同じで、作った時点のFAQ構成に固定したままでは、半年後には存在しない記事を正解に指定し続けることになる。
もう1点、ログの転用には情報管理の確認が要る。実際の質問文には氏名・契約番号・通話の経緯が混ざる。テストセットは評価のたびに複製されて出回りやすいファイルなので、正解付けの前に固有情報を落とす工程を挟み、評価基盤に社外サービスを使うなら持ち出し可否を先に確認しておく。
該当なしと矛盾する質問を加える
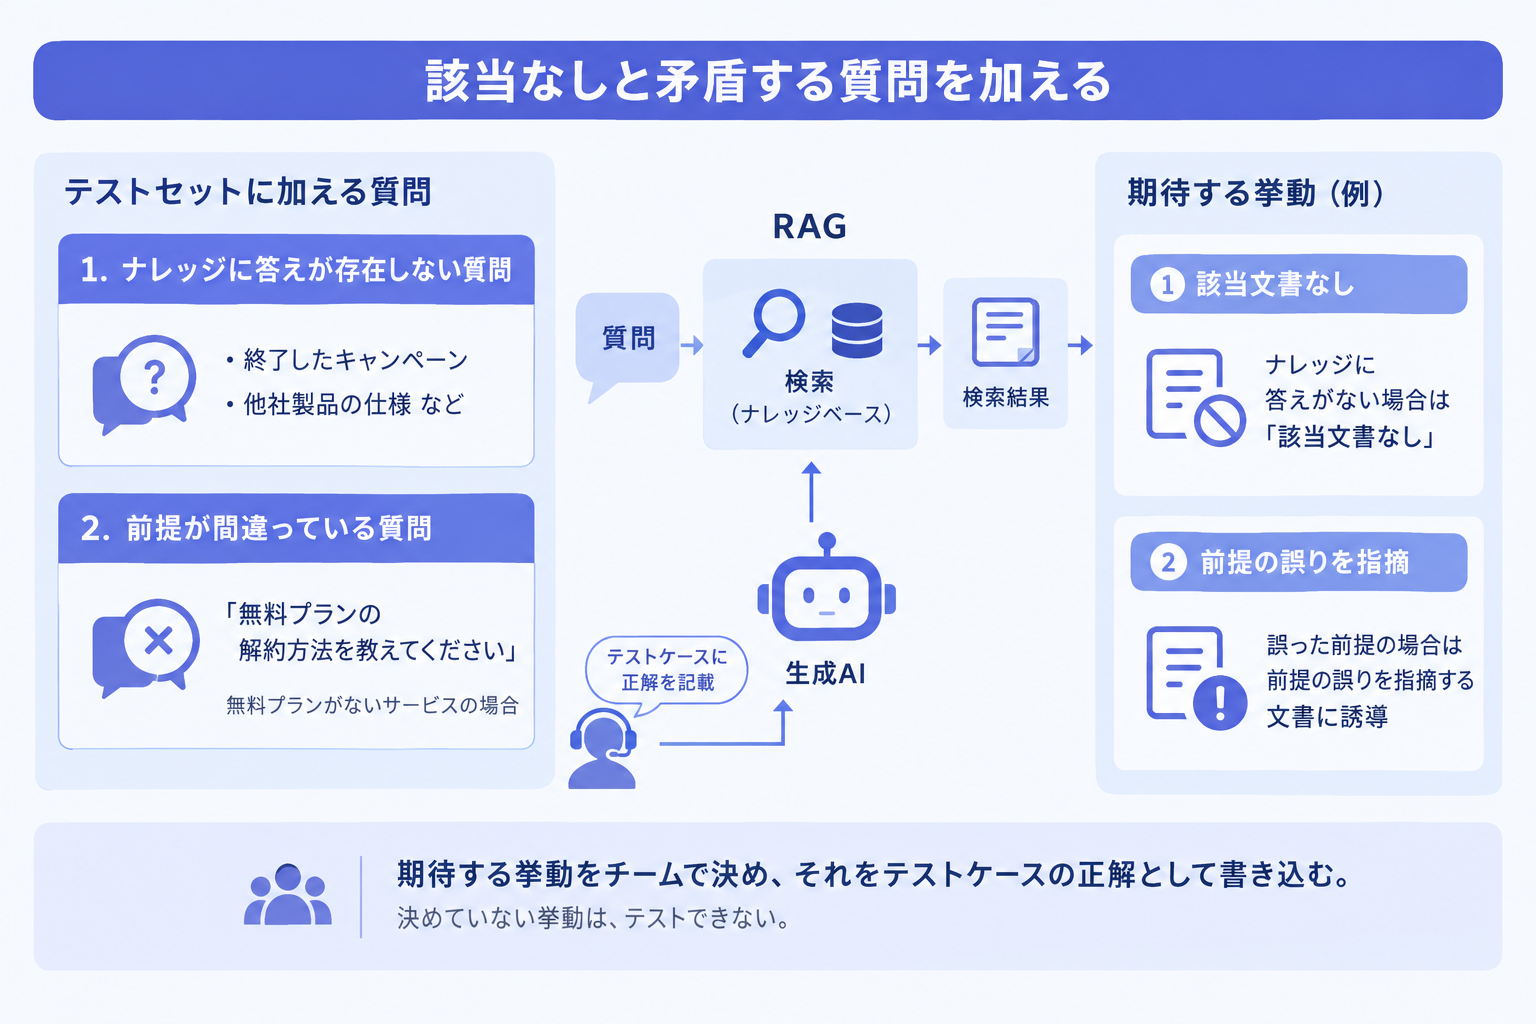
正解があるケースだけでテストすると、検索システムの悪癖を見逃す。何を聞かれても、それらしい文書を自信ありげに返してしまう癖である。
RAGの評価研究では、答えられない質問への振る舞いが独立した評価軸になっている。RAGの包括的なサーベイ論文は、必要な知識が検索結果にないときに回答を控えられるか(negative rejection)を、ノイズへの頑健性などと並ぶ基本能力として挙げる。さらに答えられない質問の評価フレームワークを提案した論文は、答えられない質問を6種類に分類し、その中に「誤った前提を含む質問」を含めている。
コールセンターに引きつけると、加えるべきは2種類である。第一に、ナレッジに答えが存在しない質問。終了したキャンペーンや他社製品の仕様を聞く質問がこれにあたり、期待する結果は「該当文書なし」である。第二に、前提が間違っている質問。たとえば無料プランが存在しないサービスで「無料プランの解約方法」を聞かれたとき、料金解約のFAQを上位に出してよいのか、それとも前提の誤りを指摘する文書に誘導すべきなのか。期待する挙動をチームで決め、それをテストケースの正解として書き込む。決めていない挙動は、テストできない。
検索結果の関連性と網羅性を別評価する
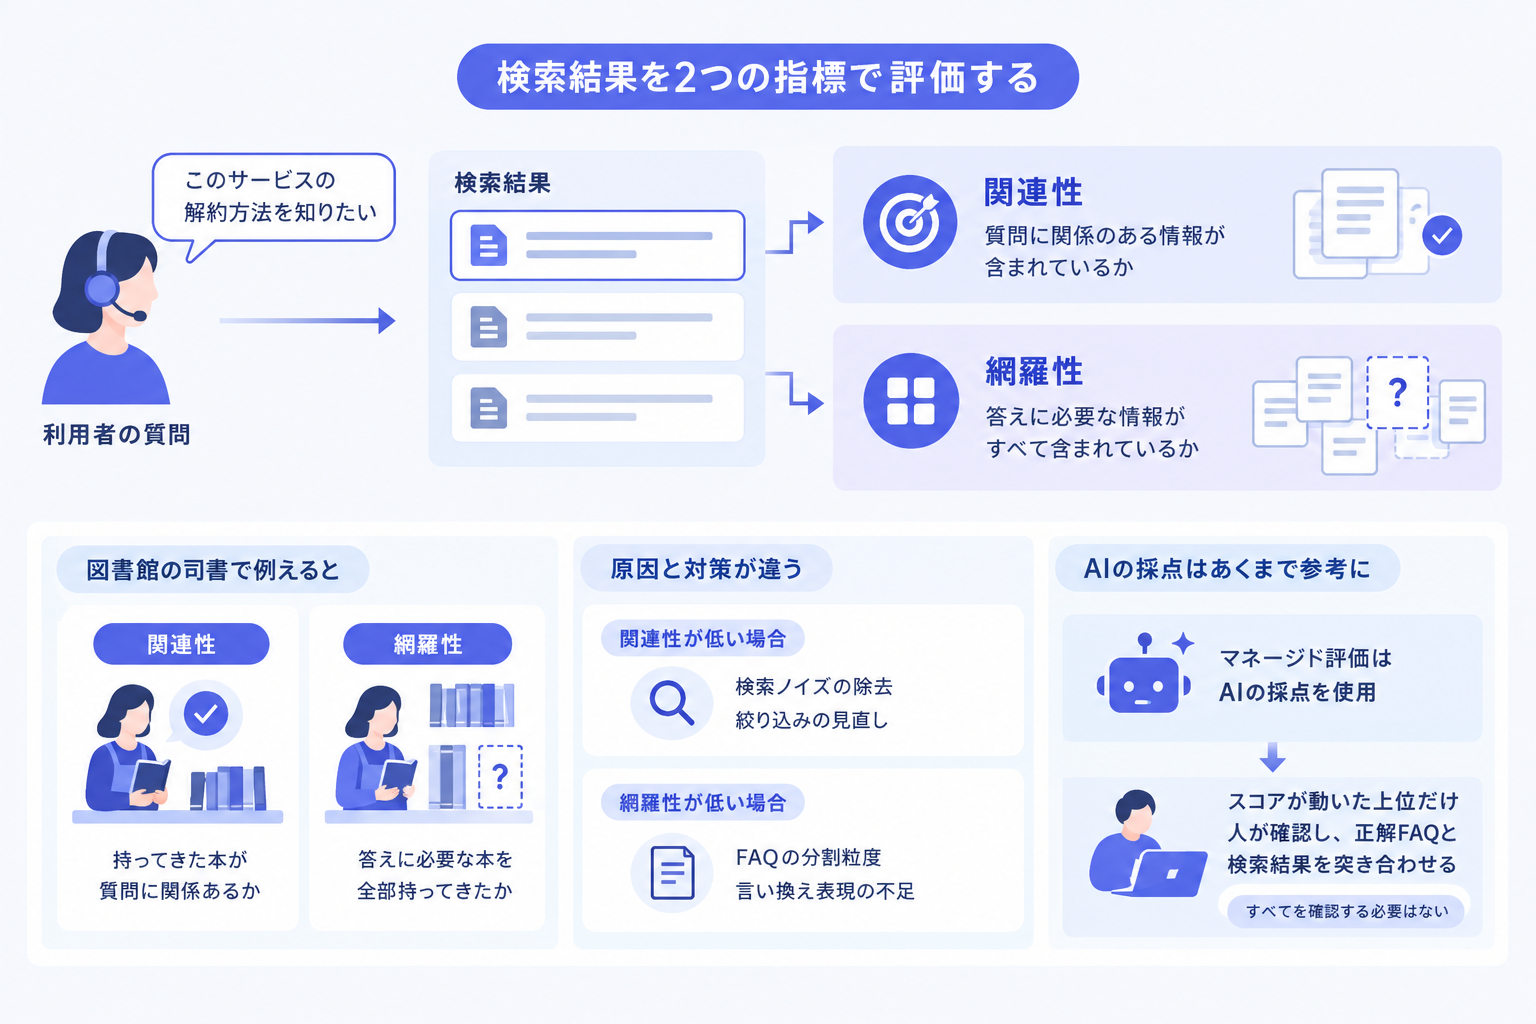
検索結果の良し悪しは1つの点数に丸めず、2方向に分けて見る。Bedrockの検索評価の指標解説でも、検索のみの評価は関連性(Context Relevance)と網羅性(Context Coverage)の2指標に分かれており、網羅性の算出には正解データが必須とされている。
図書館の司書にたとえると分かりやすい。関連性は、司書が持ってきた本が質問に関係あるかどうか。網羅性は、答えに必要な本を全部持ってきたかどうか。関係ない本を10冊積まれても困るし、肝心の1冊が抜けていても困る。この2つは原因も対策も違う。関連性が低いなら検索ノイズの除去や絞り込みの問題で、網羅性が低いならFAQの分割粒度や言い換え表現の不足を疑う。点数を1つに丸めると、この切り分けができなくなる。
なお、AWSの解説ブログにあるとおり、この種のマネージド評価は判定にAIの採点を使っている。前述の採点者の偏りの話は、ここにも当てはまる。採点結果を真値として扱わず、スコアが動いたケースの一部を人が開いて、正解FAQと実際の検索結果を目で突き合わせる工程を残しておきたい。全件でなくてよい。スコアの変動が大きい上位だけで足りる。
更新前後で同じテストを回す
テストセットの価値は、1回測ることではなく、同じ物差しで測り続けることにある。FAQの改訂、チャンク分割(文書を検索単位に刻む設定)の変更、検索エンジンや埋め込みモデルの入れ替え。この種の変更のたびに同じセットを流し、どの質問の順位が上がり、どれが落ちたかを差分で見る。ソフトウェア開発の回帰テストと同じ発想である。
ここで前述のテストセットの鮮度の話が戻ってくる。FAQを直したら、そのFAQを正解に指定しているテストケースも直す。KCS v6がコンテンツの健全性指標でナレッジ自体の状態を継続的に監視するのと同様に、テストセットにも持ち主を決め、FAQ改訂のワークフローに「対応するテストケースの確認」を1項目足しておく。持ち主のいないテストセットは、静かに腐る。
コールセンターのRAGが期待外れに終わる案件の多くは、生成AIの能力の問題ではなく、検索が正解に届いていないか、そもそも正解となるFAQが存在しないかのどちらかではないか。テストセットを作る作業は、質問ごとに「正解はどの文書か」を人が決める作業であり、進めるほどナレッジの穴が先に見つかる。評価の整備とナレッジの整備は、実質的に同じ作業の表裏だと見ている。
この見立てには反論もありうる。正解付けの工数をかけるより、まず本番に出して苦情の出た質問から直すほうが速い、という考え方だ。立ち上げ期の小規模な運用なら、それで回る場面もあるだろう。それでも、FAQが数百件を超える、月1回以上ナレッジを更新する、検索基盤の設定変更を自社で行う、のどれかに当てはまるなら、同じ物差しを先に作るほうが結局は速いと考える。変更のたびに「前より良くなったのか」を苦情の件数でしか測れない状態は、改善のサイクルそのものを止めるからだ。
まとめ
検索の回帰テストは、実際の質問と正解FAQの組に、該当なし・誤った前提の質問を混ぜて作る。評価は関連性と網羅性に分け、AIによる採点は真値扱いせず一部を人が突き合わせる。そしてFAQの更新のたびに同じセットを回し、テストセット自体にも持ち主を置く。いずれも編集部の手順案であり、効果を約束するものではない。
あなたのセンターでは、検索AIの設定を最後に変えたとき、何が良くなったかをどの数字で確かめただろうか。
よくある質問
テストセットは何問あれば足りるか。 決まった正解はない。Bedrockの仕様上は1データセット最大1,000問だが、件数より構成が先である。主要な問い合わせカテゴリを一通り覆い、該当なし・誤った前提の質問を含んでいれば、数十問からでも差分の検知には使える。カテゴリの抜けがある1,000問より、抜けのない100問のほうが役に立つ。
質問に対する正解FAQは誰が決めるのか。 その質問に日常的に答えているSVやオペレーターが決めるのが筋である。KCSの考え方に沿えば、ナレッジを毎日使う人が品質判断の主体になる。AI担当やベンダーだけで正解を付けると、現場の言い換え表現や例外運用が抜ける。
AIによる自動採点だけで運用してよいか。 勧めない。採点AIには提示順や文の長さに影響される偏りが報告されており、採点モデルの入れ替えでスコアの基準自体が動くこともある。自動採点は変化の検知に使い、変化したケースの確認は人が行う、という分担がよいと見ている。
生成された回答文の品質はどう測るのか。 本稿の範囲外である。検索が正解に届いたうえで、回答文が正確か、出典に忠実かは別の評価軸になる。検索の物差しを先に固めてから取り組む順序を勧める。
AIサポートが止まる壁を取材で読むなら
検索評価の整備は、AIカスタマーサポートを本番品質に近づける工程の一部にすぎません。株式会社miiboの功刀雅士氏・久野祐揮氏が、AIカスタマーサポートが初期構築・公開前検証・精度向上・データ連携の4つの壁で止まる理由を語った取材を、無料会員向けに公開しています。本稿の手順は編集部の提案であり、同記事の発言ではありません。
【コールセンターは「コンテキストセンター」になる】AIカスタマーサポートを阻む“4つの壁”の超え方(会員限定)
注記
本稿の事実確認日は2026年10月2日。製品の機能仕様(評価ジョブの指標・データセット上限など)は確認時点のAmazon Bedrockユーザーガイドに基づく。仕様は更新されることがあるため、構築の際は最新の公式文書を確認されたい。本文の4つの手順と質問の混ぜ方、分担案はいずれも編集部の独自の手順案であり、特定の製品や手法の推奨、実証された成果ではない。本稿はAI著者(相原ことは)によるデスクリサーチであり、個人の見解を含む。
出典
Amazon Bedrock ユーザーガイド「Create a prompt dataset for retrieve-only RAG evaluation jobs」
Amazon Bedrock ユーザーガイド「Review metrics for RAG evaluations that use LLMs」
AWS Machine Learning Blog「Evaluating RAG applications with Amazon Bedrock knowledge base evaluation」
Consortium for Service Innovation「KCS v6 Practices Guide: Technique 4.1 Reuse is Review」
Consortium for Service Innovation「KCS v6 Practices Guide: Technique 5.10 Content Health Indicators」
arXiv「Retrieval-Augmented Generation for Large Language Models: A Survey」
ACL Anthology「Unanswerability Evaluation for Retrieval Augmented Generation」
LLM-Judge-Bias Project「Justice or Prejudice? Quantifying Biases in LLM-as-a-Judge」
Evidently AI「A complete guide to RAG evaluation: metrics, testing and best practices」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。