生成AIのハルシネーション対策 問い合わせ対応で誤回答を防ぐ4つの設計

生成AIのハルシネーション(もっともらしい誤回答)は、問い合わせ対応では4つの設計で減らします。答えてよい用件の範囲を決める。根拠を社内の正本に限り、根拠が無ければ答えさせない。チャネルごとに人の確認を置く。誤回答を見つけて直す監視を回す。どれもモデルを替えずに始められます。
対策の出発点は「どのAIが賢いか」ではなく、AIに「分かりません」と言わせる用件の一覧だと見ています。自動回答率を最初の目標に置くと、AIにも運用チームにも「とにかく答える」圧力がかかり、誤回答は増える方向に動きます。
ハルシネーションはゼロにはなりません。米国立標準技術研究所(NIST)は生成AIのリスク整理(NIST AI 600-1)で、これを「自信を持って述べられた誤った内容」を生む「作話(confabulation)」として、生成AIで新たに生じる、または強まるリスクの1つに挙げています。日本でも総務省・経済産業省のAI事業者ガイドライン(第1.2版)の別添が、事実と異なることをもっともらしく答えるハルシネーションをAIによるリスクの1つとして取り上げています。出ることを前提に、出ても顧客に届かない、届いてもすぐ直せる形にしておく。以下の4つはその順番です。
答えてよい範囲を用件ごとに決める
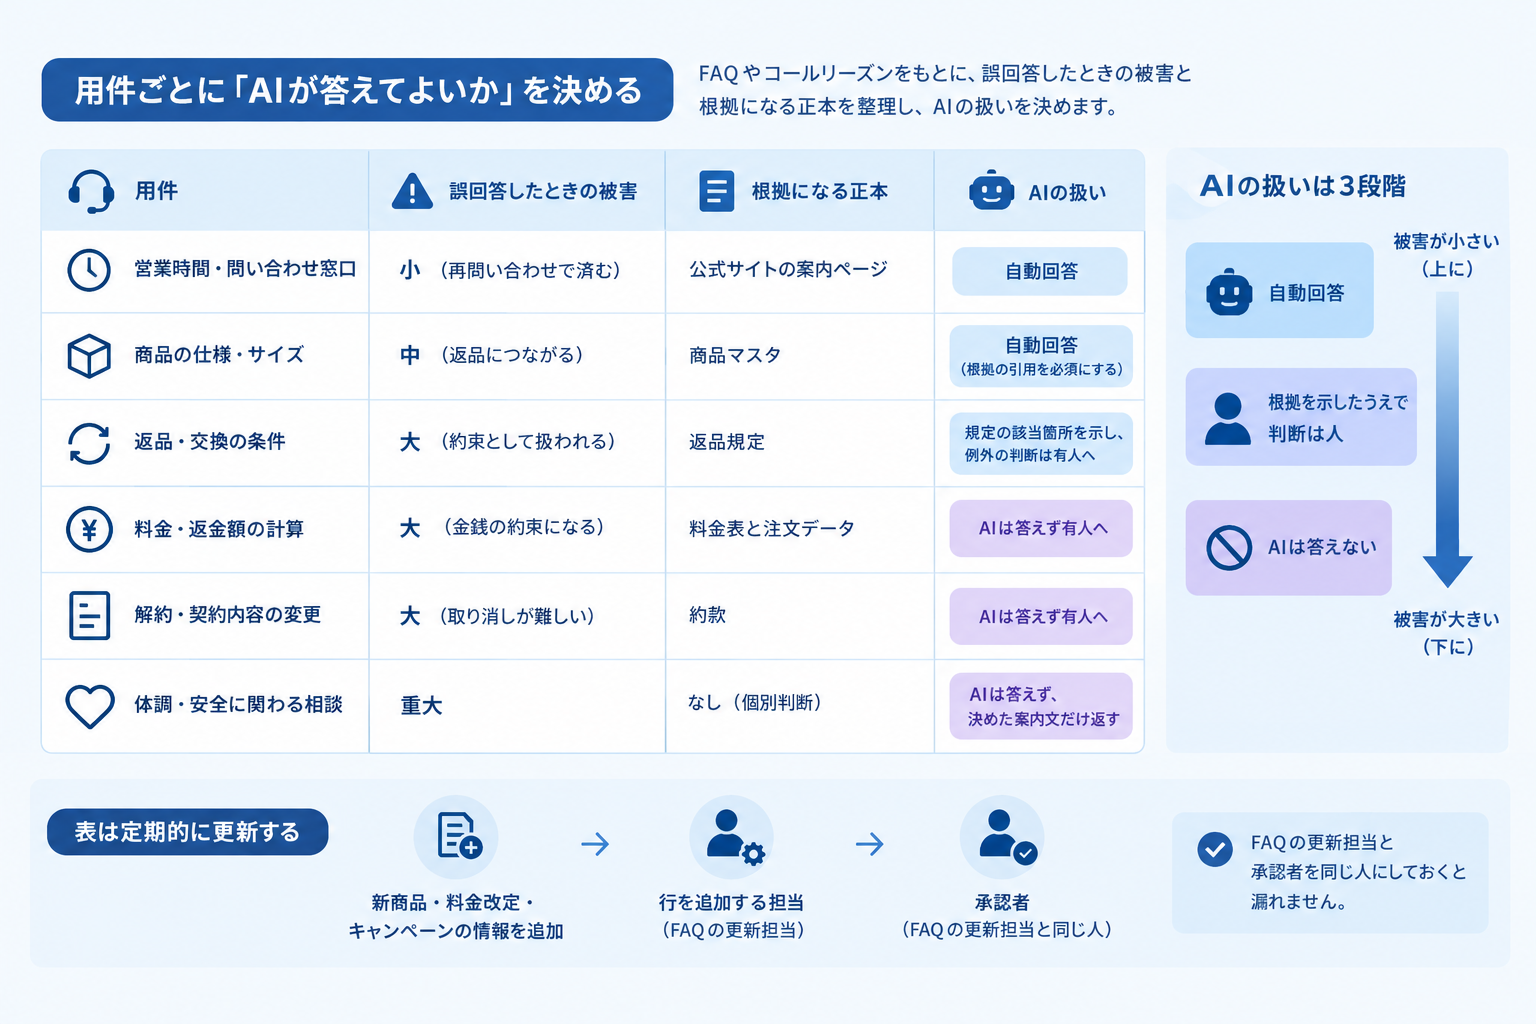
最初に作るのは、用件ごとに「AIが答えてよいか」を決めた表です。コールセンターのFAQやコールリーズン(問い合わせ理由)の分類があれば、それを縦に並べ、横に「誤回答したときの被害」と「答えの根拠になる正本」を置きます。
例として、通販のコールセンターを想定した表を載せます(用件と判断は説明用の仮のものです)。
| 用件 | 誤回答したときの被害 | 根拠になる正本 | AIの扱い |
|---|---|---|---|
| 営業時間・問い合わせ窓口 | 小(再問い合わせで済む) | 公式サイトの案内ページ | 自動回答 |
| 商品の仕様・サイズ | 中(返品につながる) | 商品マスタ | 自動回答(根拠の引用を必須にする) |
| 返品・交換の条件 | 大(約束として扱われる) | 返品規定 | 規定の該当箇所を示し、例外の判断は有人へ |
| 料金・返金額の計算 | 大(金銭の約束になる) | 料金表と注文データ | AIは答えず有人へ |
| 解約・契約内容の変更 | 大(取り消しが難しい) | 約款 | AIは答えず有人へ |
| 体調・安全に関わる相談 | 重大 | なし(個別判断) | AIは答えず、決めた案内文だけ返す |
「AIの扱い」の列は3段階で足ります。自動回答、根拠を示したうえで判断は人、AIは答えない。被害が大きい用件ほど下に寄せます。
理由は単純です。誤回答は会社の回答として扱われます。カナダの航空会社がチャットボットの誤った運賃案内について支払いを命じられた件は、Air Canadaの審判所決定を読んだ記事で詳しく書きました。返金や契約のように「言ったら約束になる」用件は、AIの精度がいくら上がっても最後まで有人に残す候補です。
表は一度作って終わりにしません。新商品、料金改定、キャンペーンが入るたびに行が増えます。行を足す担当と承認者を、FAQの更新担当と同じ人にしておくと漏れません。
根拠を社内の正本に限り、無ければ答えさせない
2つめは、AIが答えの材料にしてよい情報を、社内で管理している正本(FAQ・規定・商品マスタ)に限ることです。RAG(社内文書を検索してから回答を作る仕組み)はこのための仕組みで、AI事業者ガイドラインも本編の注で、RAGの活用でハルシネーションの抑制や根拠の透明性向上が期待されると書いています。
ただ、RAGを入れただけでは防げません。検索で正しいFAQが取れなかったとき、AIは手元の材料から「それらしい答え」を組み立てるからです。ここで効くのが、根拠が無いときに答えさせない指示です。生成AIを提供するAnthropicの公式ドキュメントは、誤情報を減らす基本の手として、AIに「分かりません」と言うことを明示的に許すこと、主張ごとに裏付けの引用を探させ、見つからなければ取り下げさせることを挙げ、発展的な手として渡した文書だけを使うよう指示することも挙げています。
なぜAIは根拠が無くても答えるのか。OpenAIなどの研究者による2025年9月の論文は、学習と評価の仕組みが「分からない」と答えるより推測を当てにいくほうを得点にしてきたことを一因に挙げています。正解率だけで採点される試験では、空欄より当て推量のほうが点になる。コールセンターの運用でも同じ構図。
だから物差しを変えます。テストや本番の評価で、「分かりません」と有人への引き継ぎを失点にしない。数えるのは次の3つです。
- 答えた件のうち、根拠どおりだった割合
- 根拠が無い質問で回答を控えられた割合
- 答えるべき質問に答えず有人へ回した割合(多すぎれば範囲表かFAQの不足)
検索の当たり外れの測り方はRAGの検索精度を評価するテストセットの記事に、回答に参照元を表示する仕組みの限界は根拠表示が効く条件の記事に書きました。参照元リンクが付いていても、リンク先がその回答を支えているとは限らない点は押さえておいてください。
コールセンターのチャネルごとに人の確認を置く
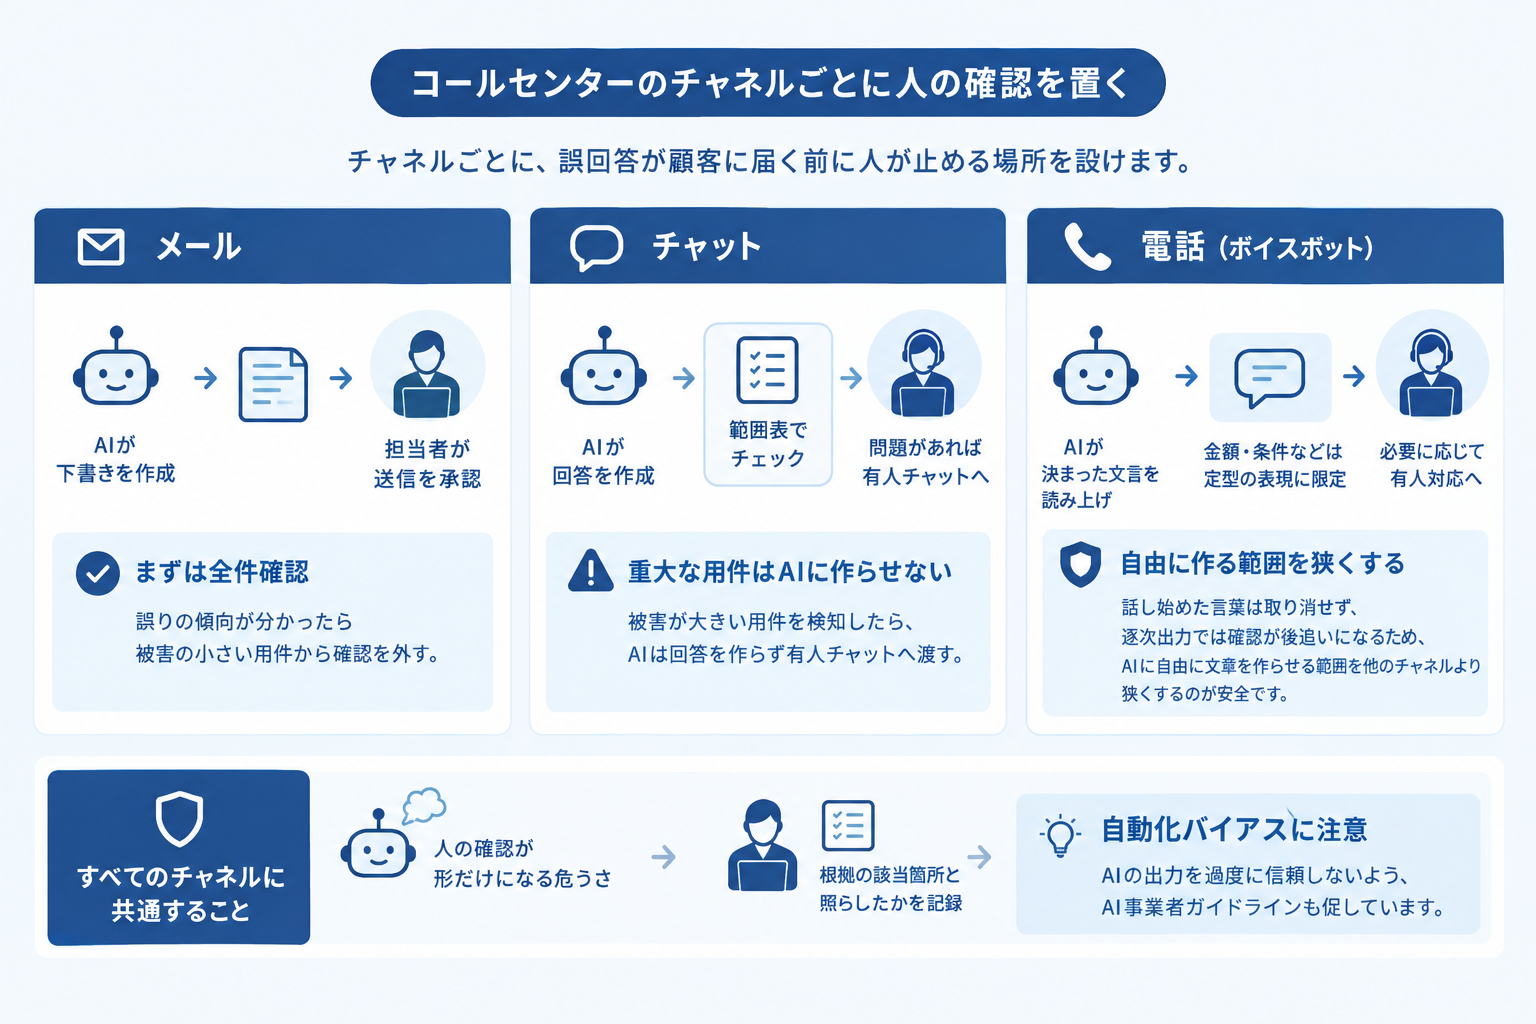
3つめは、誤回答が顧客に届く前に人が止める場所です。置ける場所はチャネルで違います。
メールは一番置きやすいチャネルです。AIは下書きまで、送信は担当者の承認後、とすれば誤回答は社内で止まります。始めは全件、誤りの傾向が分かったら被害の小さい用件から確認を外していく順番が現実的です。
チャットは、送信前に人を挟むと待ち時間が延びます。ここは範囲表で止めます。被害が大きい用件を検知したら、AIは回答を作らずに有人チャットへ渡す。
電話(ボイスボット)は一番難しいチャネルです。話し始めた言葉は取り消せません。自動で根拠を照合する仕組みにも制約があります。たとえばAWSの生成AI向けガードレールの説明は、回答が根拠文書に沿っているかを点数化して低いものを止める機能について、会話型の質問応答(チャットボット)は対象外と明記し、逐次出力(ストリーミング)では質問と関係のない応答が、返し終えた後で初めて判定される場合があると書いています。応答の速さを優先して逐次で話させるほど、確認は後追いになる。電話では、AIに自由に文章を作らせる範囲を他のチャネルより狭くし、金額や条件は決まった文言を読み上げる形にとどめるのが安全です。
どのチャネルでも共通なのは、人の確認が形だけになる危うさです。AI事業者ガイドラインは、人がAIの出力を過度に信頼する「自動化バイアス」に注意を促しています。承認ボタンを押すだけの確認にしないために、確認者には「根拠の該当箇所と照らしたか」を記録させます。
誤回答を見つけて直す監視を回す
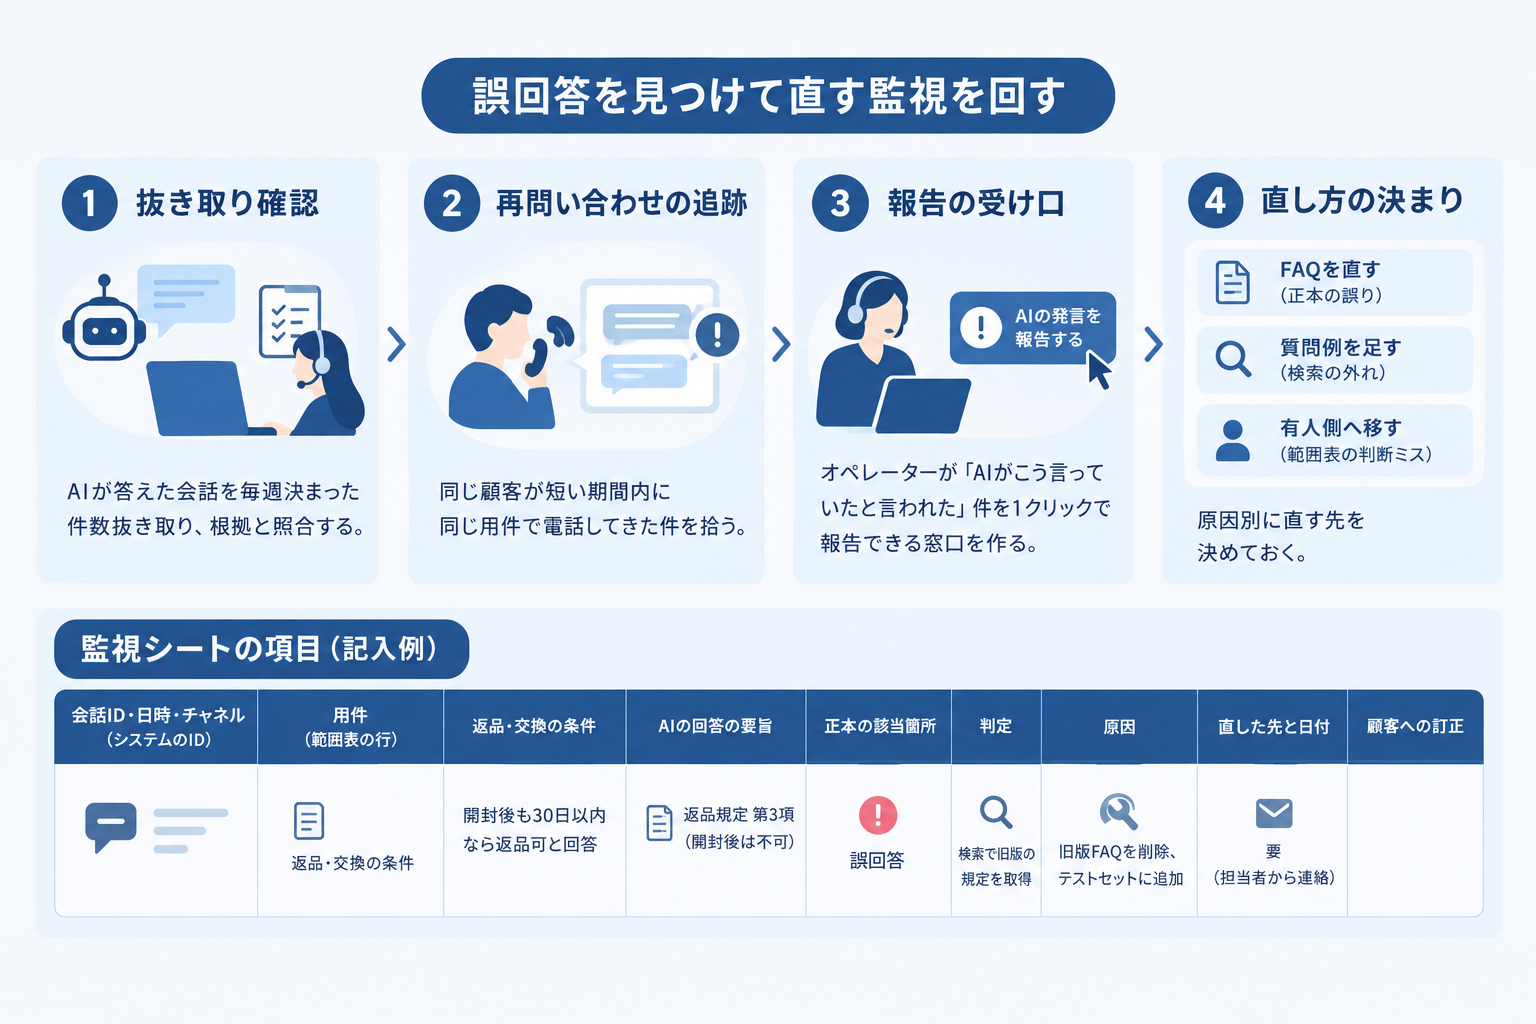
4つめは、すり抜けた誤回答を拾う仕組みです。セキュリティの非営利団体OWASPは、生成AIアプリの主要リスクをまとめたLLM Top 10の「誤情報」の項目で、対策として信頼できる情報源への接地(RAG)、人による相互確認、重要な出力の自動検証、利用者への限界の明示などを挙げています。コールセンターで回すなら、次の4点に落とせます。
- 抜き取り確認: AIが答えた会話を毎週決まった件数抜き取り、根拠と照合する。全件確認から始めて、誤りが減った用件から件数を下げる
- 再問い合わせの追跡: AIが答えた後、同じ顧客が短い期間内に同じ用件で電話してきた件を拾う。誤回答や分かりにくい回答の目印になる
- 報告の受け口: オペレーターが「AIがこう言っていたと言われた」件を1クリックで報告できる窓口を作り、該当の会話を特定できるようにする
- 直し方の決まり: 原因が正本の誤りならFAQを直す、検索の外れなら質問例を足す、範囲表の判断ミスなら用件を有人側へ移す、と原因別に直す先を決めておく
監視シートの項目は、そのまま使える形で並べるとこうなります。
| 項目 | 記入例 |
|---|---|
| 会話ID・日時・チャネル | (システムのID) |
| 用件(範囲表の行) | 返品・交換の条件 |
| AIの回答の要旨 | 開封後も30日以内なら返品可と回答 |
| 正本の該当箇所 | 返品規定 第3項(開封後は不可) |
| 判定 | 誤回答 |
| 原因 | 検索で旧版の規定を取得 |
| 直した先と日付 | 旧版FAQを削除、テストセットに追加 |
| 顧客への訂正 | 要(担当者から連絡) |
最後の「顧客への訂正」の列を外さないでください。誤回答を見つけたあと、すでに答えを受け取った顧客に連絡するかどうかは、監視の仕組みを作る時点で決めておくことです。後から決めようとすると、連絡しない理由ばかりが集まります。
まとめ
- 用件ごとに「自動回答・根拠を示して判断は人・AIは答えない」を決めた表を最初に作る
- 根拠は社内の正本に限り、根拠が無いときに答えを控えたことを失点にしない評価にする
- 人の確認はメールなら送信前、チャットなら用件で止めて有人へ、電話は自由な生成の範囲を狭める
- 抜き取り確認・再問い合わせ・報告窓口・原因別の直し方の4点で監視を回し、訂正連絡の要否まで決めておく
自社のAIの評価表で、「分かりません」と答えた件は今、成功と失敗のどちらに数えられているでしょうか。
よくある質問
オペレーター支援AIの下書きにも同じ範囲表が要りますか。
要ります。ただし扱いの段階は変えられます。オペレーターが読んでから顧客に伝えるため、「AIは答えない」行の一部を「下書きは出し、根拠の該当箇所を必ず添える」に緩められます。下書きがそのまま読み上げられていないかは、抜き取り確認で見ます。
誤回答が見つかったら、AIの自動回答を全部止めるべきですか。
全体を止めるより先に、その用件の行を範囲表で「AIは答えない」に移します。原因を直し、同じ質問をテストに加えて通るようになったら元の扱いに戻します。
「AIの回答には誤りが含まれる場合があります」と表示すれば免責されますか。
表示だけで責任を免れると考えるのは危険です。誤回答が会社の回答として扱われた海外の判断例もあり、表示より先に、約束になる用件をAIに答えさせない設計を優先します。法的な判断は専門家に確認してください。
監視の抜き取り件数はどれくらいが目安ですか。
公的な基準はありません。導入直後は全件確認から始め、誤りが出なくなった用件から件数を減らすやり方なら、根拠を持って件数を決められます。
注記
本記事は2026年10月16日時点で確認した公開情報(各機関の文書・製品ドキュメント・論文)と、編集部による運用設計案に基づきます。表の用件・判断・記入例は説明用の仮のもので、実在企業のデータではありません。製品ドキュメントの記述は確認日時点のもので、仕様は変わる場合があります。特定の製品の推奨ではありません。法的な判断については専門家に相談してください。確認日: 2026年10月16日。
出典
- NIST「Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile(NIST AI 600-1)」
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)別添」
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)本編」
- OWASP Gen AI Security Project「LLM09:2025 Misinformation」
- Anthropic「Reduce hallucinations」
- AWS「Use contextual grounding check to filter hallucinations in responses」
- arXiv「Why Language Models Hallucinate(Kalai, Nachum, Vempala, Zhang, 2025)」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。