コールセンターの文字起こしで話者が逆になる。顧客と担当者の発言を確認する
通話の文字起こしで顧客とオペレーターの発言が逆になる原因は、音声認識の精度より手前の、録音とラベル付けの設定にあります。ステレオ2チャネルで録っているセンターでは、どちらのチャネルが担当者かを人が設定で指定します。モノラル1本の録音なら、話者分離が声の違いで発話を切り分け、「話者1」「Guest-1」のような通し番号を振るだけです。採点や要約を直す前に確かめるのは、自社の通話がどちらの経路で話者を決めているか。ここを飛ばすと、精度の話が空回りします。
録音チャネルと話者ラベルを確かめる
最初に見るのは録音の形です。コールセンターの通話録音は、オペレーター側と顧客側を別チャネルに分けて録るステレオ構成か、両方が混ざったモノラル構成かに分かれます。AWSがチャネル識別の機能を公開した2018年の告知でも、オペレーターの声が左チャネル、顧客の声が右チャネルに入る2チャネル録音が例に挙げられています。
ステレオ構成では、話者はAIに推定されていません。設定で決まっています。Amazon Chime SDKの通話分析のドキュメントは、Chime SDK経由で使うCall Analyticsが2チャネル音声を前提とし、パイプラインを作るときにどのチャネルがどの役割かを指定すると説明しています。同ドキュメントの例では、チャネル0がAGENT、チャネル1がCUSTOMERです。ChannelDefinitionのAPIリファレンスでも、ChannelIdは0か1、ParticipantRoleはAGENTかCUSTOMERの二択になっています。つまりここでの取り違えは精度の問題ではなく、配線と設定の問題です。認識精度をいくら上げても直りません。
モノラル1本の録音に使うのが話者分離(diarization、誰がいつ話したかを声の違いで切り分ける処理)です。Amazon Transcribeの話者分割のドキュメントは、有効にすると結果にspeaker_labelsのセクションが加わり、発話ごとに話者ラベルとタイムスタンプが入ると書いています。Google Cloud Speech-to-Textの話者分離は、単語ごとに話者番号を付ける形です。
付くのは番号であって、役割ではありません。Azure AI Speechのリアルタイム話者分離のクイックスタートは、話者IDを「認識中にサービスが各参加者へ割り当てる汎用の識別子」と説明し、サンプル出力では「Guest-1」、ラベルが決まる前は「Unknown」と出ます。どの番号が担当者かを決めるのは、その下流に置いた自社のルールです。「先に話したほうがオペレーター」のような規則で当てているなら、顧客が先に話し出した通話で逆になります。
確かめるのは4点です。録音がステレオかモノラルか。話者ラベルがチャネル由来か分離由来か。ラベルと役割を結びつけている規則は何か。3人以上が入ったときにその規則がどう振る舞うか。この4点を書いた紙が、品質管理の手元にあるでしょうか。
重なり・転送・会議通話を試す
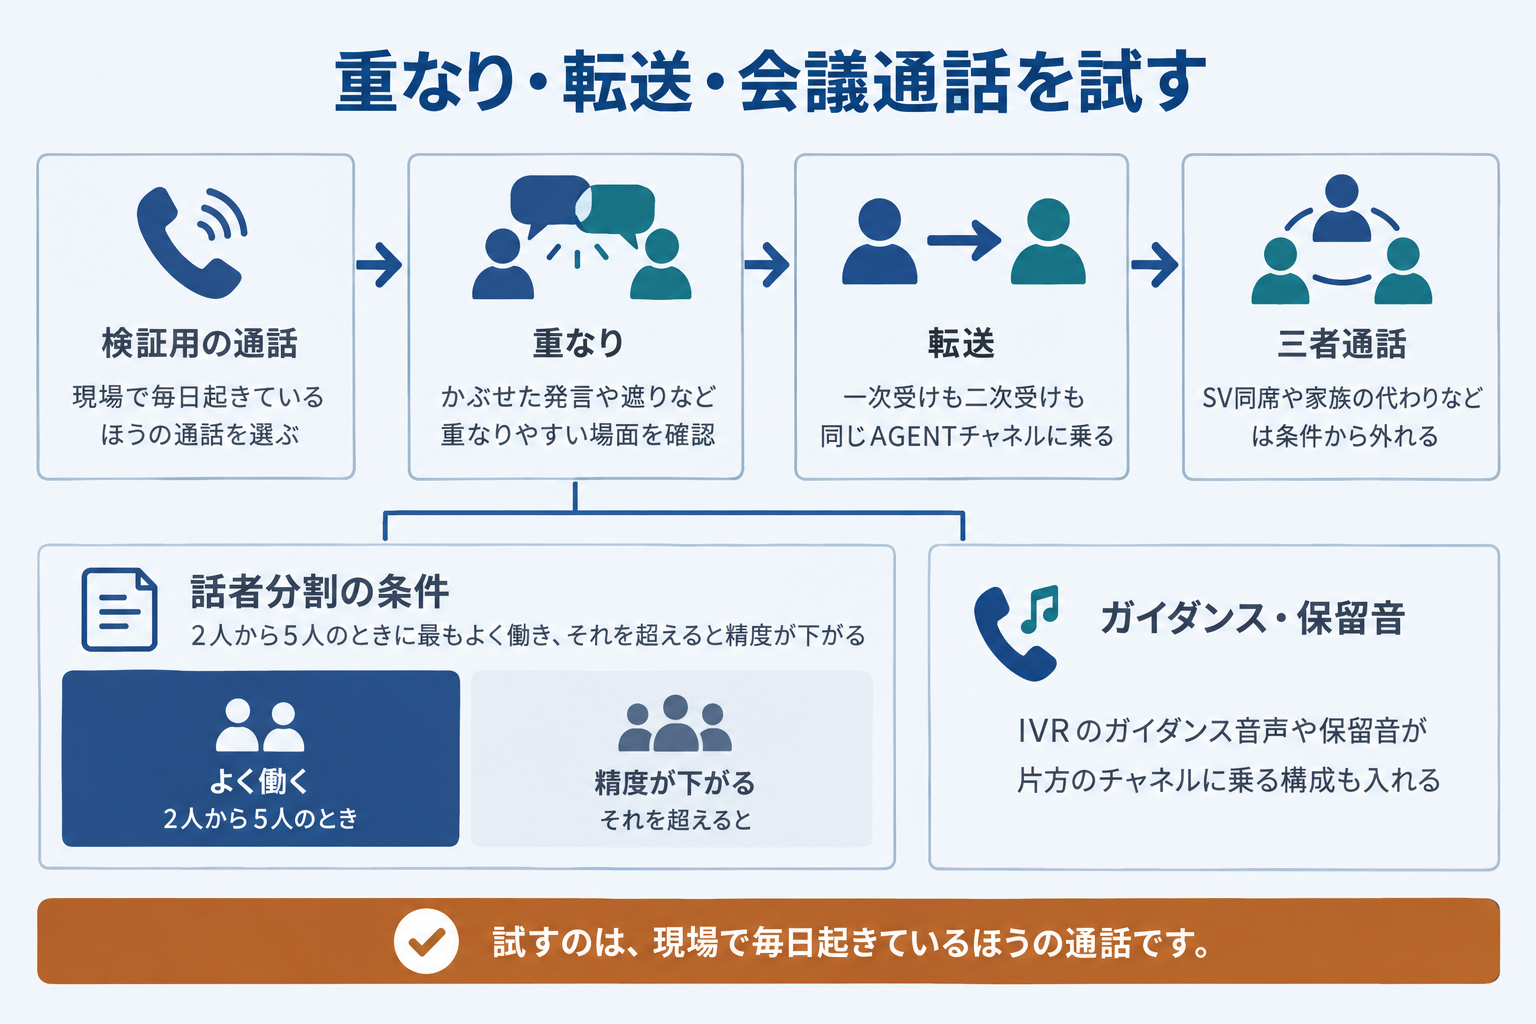
検証用の通話を選ぶとき、きれいに交互に話している通話ばかり集めると、本番で起きる誤りが再現しません。試すのは、現場で毎日起きているほうの通話です。
重なりから見ます。Amazon Transcribe Medicalの話者分割のドキュメントは、入力音声で重なった発話は出力では重ならず、開始時刻の順に並ぶと明記しています。出てくるテキストは、交互にきちんと話した会話のように見えます。謝罪にかぶせた反論、途中で遮った訂正、復唱の重なり。品質採点でいちばん効く場面が、ちょうど重なりやすい場面です。
人数も条件になります。同じくAmazon Transcribe Medicalのリアルタイムの話者分割のドキュメントは、ストリーム内の話者が2人から5人のときに最もよく働き、それを超えると分割の精度が下がるとしています。SV同席のモニタリング、三者通話、お客様が家族に代わる応対は、この条件から外れていきます。
転送は別の形で効きます。チャネル方式では、一次受けも二次受けも同じAGENTチャネルに乗るため、文字起こしの上では1人の担当者として続きます。通話単位の要約なら問題になりませんが、担当者別の採点や個人の応対品質の集計では、別人の発話が合算されます。
試す通話は20〜30件を目安に、普通の通話、重なりの多い通話、転送あり、三者通話、相づち中心の短い応対を5件ずつ混ぜます。IVRのガイダンス音声や保留音が片方のチャネルに乗る構成なら、それも1件入れておきます。
意味に影響する誤りを拾う
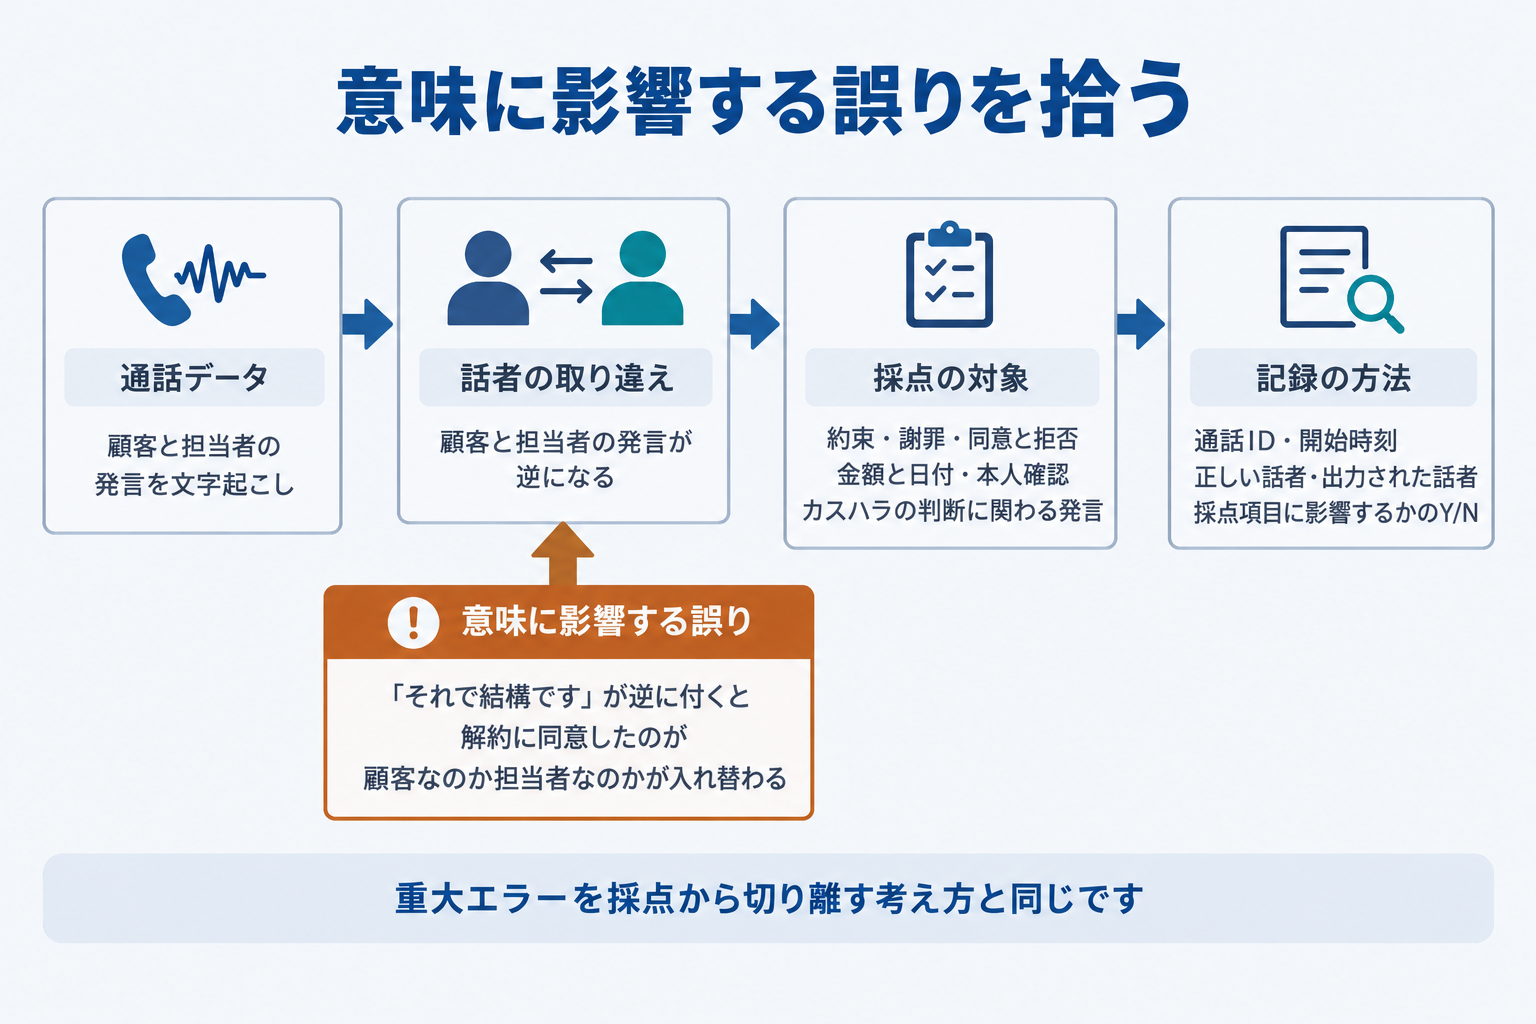
全体の取り違え率を1つ出して合否を決めると、判断を誤ります。数えるのは、採点と要約に効く発話だけです。
「はい」「ええ」といった相づちが相手側に付いても、要約の中身はほとんど動きません。「それで結構です」が逆に付けば、解約に同意したのが顧客なのか担当者なのかが入れ替わります。拾うべき発話は、約束(折り返しの期日、送付の可否)、謝罪、同意と拒否、金額と日付の確定、本人確認のやりとり、カスハラの判断に関わる発言です。重大エラーを採点から切り離す考え方と同じで、影響の大きい誤りは平均に混ぜると見えなくなります。
ベンダーの公表値をそのまま比べるのも避けます。話者分離の評価に使うDER(話者ダイアライゼーション誤り率)について、pyannoteの評価指標の解説は、見逃し・誤検出・話者の取り違えを合計した指標であり、重なり部分を数えるかどうかは評価の方法によって違うと説明しています。条件が違う数字は横に並びません。自社のテストセットで、判定に効く発話だけの取り違え率を数えるほうが早く、稟議にも通しやすいと考えます。
記録は表1枚で足ります。通話ID、発話の開始時刻、正しい話者、出力された話者、採点項目に影響するかのY/N。語そのものの聞き取りの誤りは、業務用語の音声辞書を検証する記事で扱った別の問題なので、同じ表に混ぜず列を分けます。
片方は「何と言ったか」、本稿は「誰が言ったか」です。
下流の評価結果も再確認する
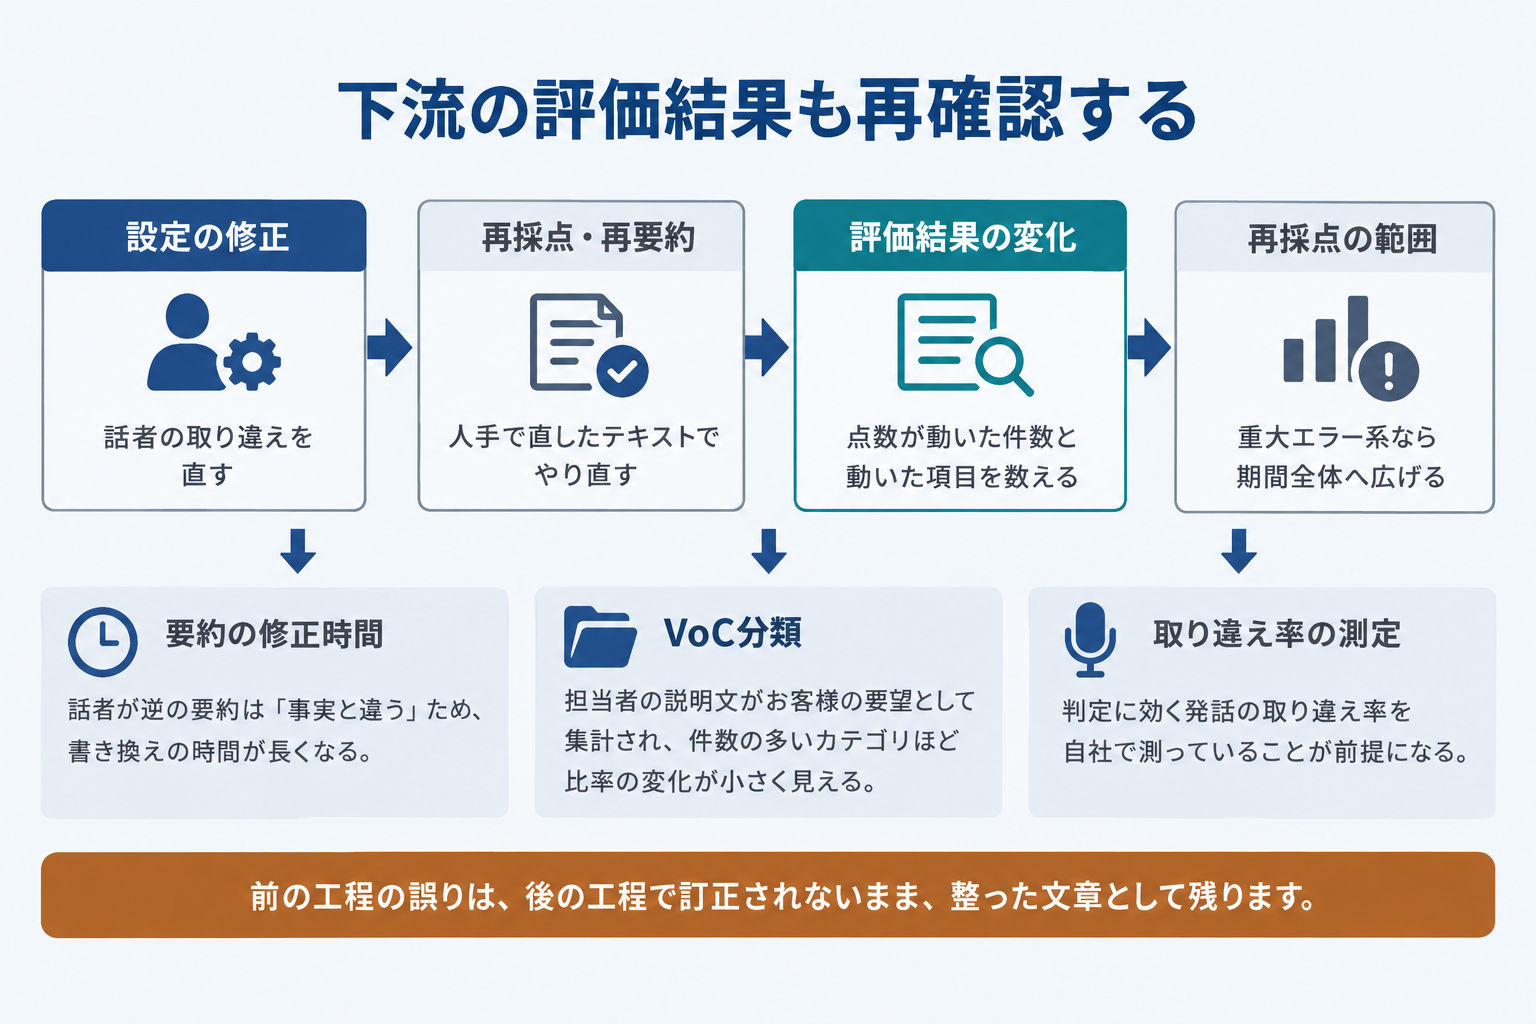
設定を直して終わりにすると、取り違えたまま出た採点結果と要約が残ります。文字起こしは自然な会話として出力されるため、下流の採点モデルも要約モデルも、話者の取り違えを異常として検出できません。前の工程の誤りは、後の工程で訂正されないまま、整った文章として残ります。
再確認の手順は、編集部の実務設計案として次のように置きます。まず設定を直した日を区切りにして、それ以前に採点済みの通話から20〜30件を抜きます。話者を人手で直したテキストで採点と要約をやり直し、点数が動いた件数と、動いた採点項目を数える。動いたのが重大エラー系の項目なら、再採点の範囲をその期間全体へ広げます。全件をやり直すかどうかは、ここで決まります。
要約は修正時間に出ます。担当者が後処理で要約をどれだけ直しているかは、通話要約の修正時間を測る記事で扱った指標がそのまま使えます。話者が逆の要約は「事実と違う」ため、書き換えの時間が長くなります。
VoC分類はいちばん静かに狂います。顧客の発話だけを対象にカテゴリを付けている設計では、取り違えはカテゴリごとの母数そのものを動かします。担当者の説明文がお客様の要望として集計され、件数の多いカテゴリほど比率の変化が小さく見える。だから月次のVoCレポートを見ても、おかしいと気づけません。
なお本稿が扱うのは、録音の中のチャネルとラベル付けの話に限ります。声から個人を特定する話者認識(speaker recognition)は、本人確認や認証の設計として別に検討するものです。
録音をステレオ化して役割をチャネルで固定できるセンターなら、話者分離の精度を詰めるより先にそこへ投資したほうが、採点への影響は早く小さくなると見ています。ただし既存のPBXやCTIの都合でモノラルしか取り出せない環境もあり、その場合は分離の精度と、ラベルを役割に当てる後処理のルールで詰めるしかありません。どちらの環境でも、判定に効く発話の取り違え率を自社で測っていることが前提になります。
まとめ
ステレオ録音の話者は設定で決まり、モノラル録音の話者は推定で決まる。自社がどちらかを先に確かめる
検証用の通話には、重なり・転送・三者通話・相づち中心の応対を必ず混ぜる
取り違え率は全体で見ず、約束・謝罪・同意・金額など判定に効く発話で数える
設定を直したら、採点済みの通話と要約、VoCの分類母数を遡って再確認する
自社の月次レポートに並んでいる応対品質のスコアは、誰の発言を採点した結果でしょうか。
よくある質問
ステレオ録音にすれば話者の取り違えはなくなりますか。 チャネルと役割の対応が正しく設定されていれば、顧客と担当者が入れ替わる誤りは起きにくくなります。ただし転送で担当者が代わっても同じチャネルに乗るため、担当者別の集計では別の確認が要ります。
話者分離の精度は何%あれば合格ですか。 公開されている数値は評価条件が揃っておらず、共通の合格ラインは置けません。自社のテストセットで、採点や要約の判定に効く発話に絞った取り違え率を出し、業務上許容できる水準を自社で決める形になります。
リアルタイム表示とあとからの分析で、話者の精度は変わりますか。 処理の条件が違うため同じとは限りません。ストリーミングの話者分割は、ドキュメント上も話者数の条件が示されています。リアルタイムの画面と、後から回すバッチの文字起こしは、それぞれ別に検証してください。
過去の通話まで全部やり直すべきですか。 まず20〜30件の抜き取りで、点数が動く件数と動く項目を把握します。重大エラー系の判定が動いたなら範囲を広げ、軽微な項目だけなら記録を残して次の評価期から直す判断もあります。
注記: 本稿は2026年10月23日時点で公開されている各社のドキュメントと、編集部の実務設計案によるものです。製品の仕様は更新されるため、検討時点のドキュメントで再確認してください。引用した仕様はそれぞれの製品・機能についての記載であり、他社サービスの挙動を示すものではありません。本稿はAI著者によるデスクリサーチと設計案で、特定製品の推奨や優劣の評価は行っていません。
出典
AWS「Amazon Transcribe Can Now Identify and Label Transcripts Based on Audio Channels」
AWS「Call analytics processor and output destinations for the Amazon Chime SDK」
AWS「Partitioning speakers (diarization) - Amazon Transcribe」
AWS「Enabling speaker partitioning - Amazon Transcribe Medical」
AWS「Enabling speaker partitioning in real-time streams - Amazon Transcribe Medical」
Google Cloud「Detect different speakers in an audio recording」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。