コールセンターの応対品質評価表 ー 総合点に埋もれる重大ミスを分ける

コールセンターの応対品質評価表で、総合点が90点のオペレーターがいる。その同じ月に、料金の締め日を1件だけ誤って案内していた。評価表の上では、この1件は「正確な案内」の設問で数点を失っただけで、総合点はほとんど動かない。ところがお客様の側では、誤った締め日を信じて手続きが遅れ、後日の苦情や返金対応につながりうる。平均点が高いことと、見逃せない事故が起きていないことは、別の問いである。本稿の核の問いは、評価表のなかで「重大ミス」をどう扱えば、総合点に埋もれさせずに管理できるのか、だ。先に立場を書くと、重大項目は総合点の一部として減点するのではなく、総合点とは別の指標として数え、根拠と再発防止までを一組で記録すべきだと考える。以下の手順と判断例は、公開されている製品仕様と品質管理の一般的な実務慣行をもとに編集部が設計した実務案であり、標準規格ではない。
前提として、同じ通話を人とAIで採点して一致度を上げる手順は、人とAIの点数のずれを扱ったキャリブレーション記事で扱った。本稿はその一段手前、評価表の構造そのものを扱う。
1. 業務上の重大失敗を定義する
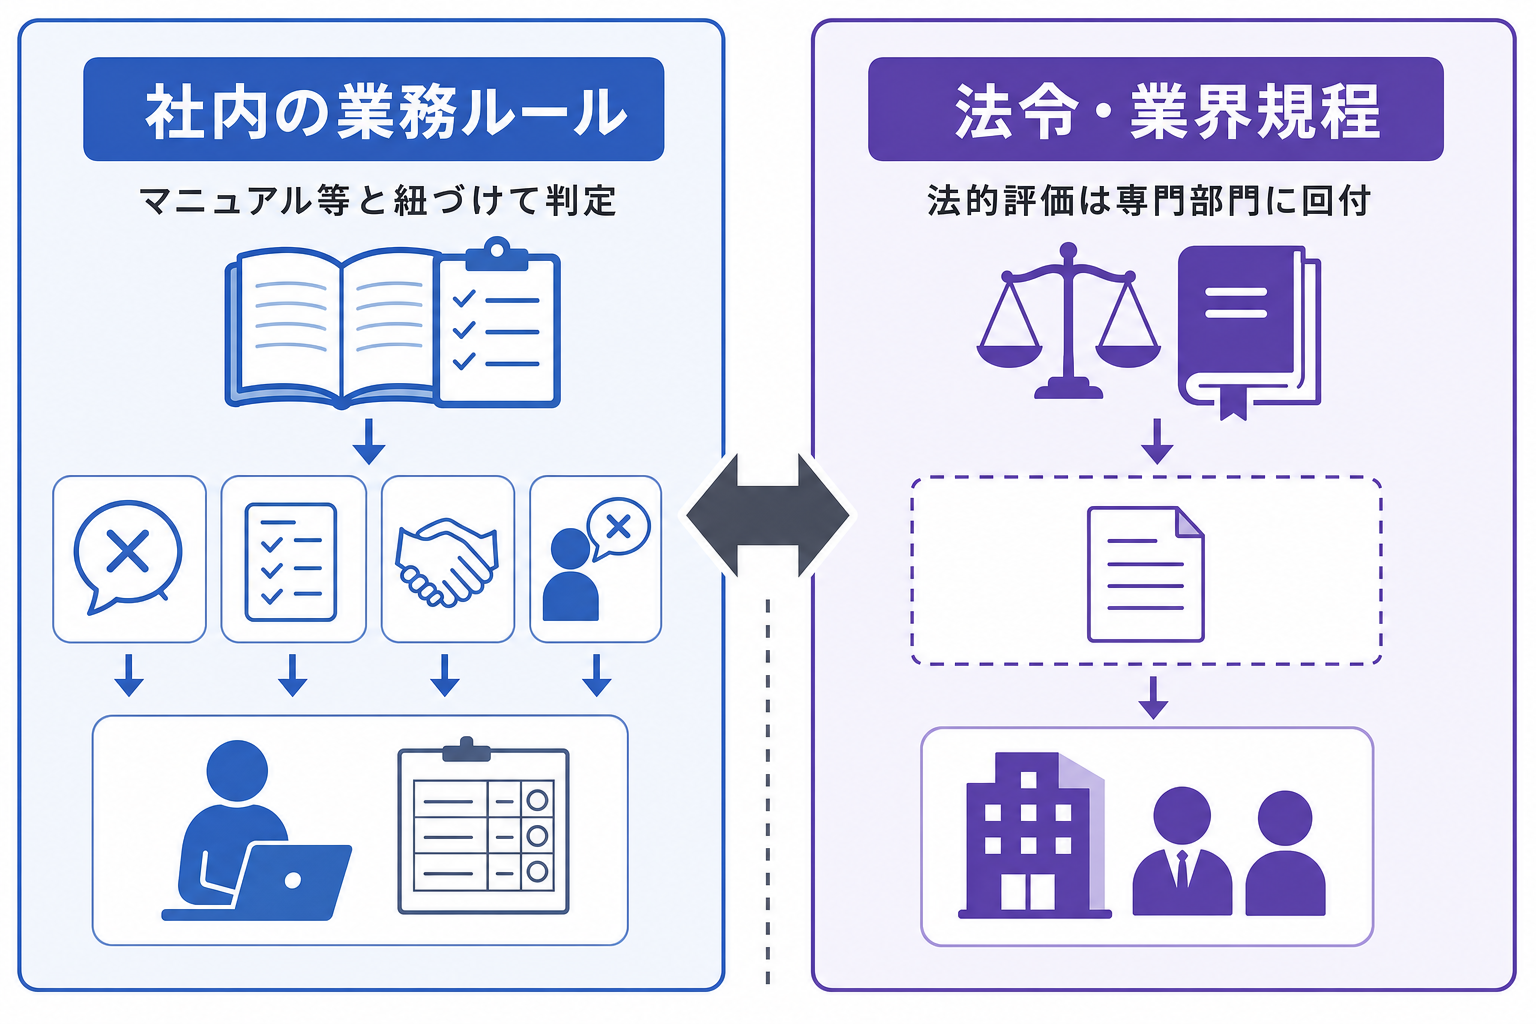
最初にやるべきは、「重大」を感覚ではなく業務上の結果で定義することだ。印象の悪い応対と、お客様や会社に実害が出る応対は、同じ物差しに乗せられない。編集部の設計案では、重大項目の候補を次の4類型で洗い出す。
誤案内: 金額・期限・手続き・契約条件など、お客様の行動を左右する情報を誤って伝えた
必須手順の逸脱: 本人確認、記録、同意取得など、業務ルールで必須とされた手順を飛ばした
約束の不履行: 折り返し・取次ぎ・送付など、応対中に約束した対応が実行されていない
不適切な発言: お客様を侮辱する、断定的に不利益を告げる等、業務ルールで禁止された発言
ここで重要なのは、各項目を必ず自社の業務ルール文書(マニュアル・規程・業務手順書)の該当箇所と紐づけることだ。「本人確認の逸脱」と書くだけでは、どこまでが必須なのかが評価者ごとに揺れる。業種やチャネルによって必須手順は違うため、他社の重大項目リストをそのまま持ち込むのも危うい。通販の問い合わせ窓口と金融機関の窓口では、同じ「住所変更」でも必須の確認項目が異なる。
もう一つ線を引いておきたいのが法令との関係だ。応対のなかには、法令や業界規程に関わる可能性のある事象も含まれる。ただし、評価者やAIが評価表の上で「法令違反」と認定するのは避けたい。評価表で判定するのはあくまで「社内の業務ルールに沿っていたか」までにとどめ、法令上の評価が必要な事象は法務・コンプライアンス部門の判断に回す経路を別に用意する。品質評価は法的判断の場ではない。
2. 総合点と重大項目を分ける
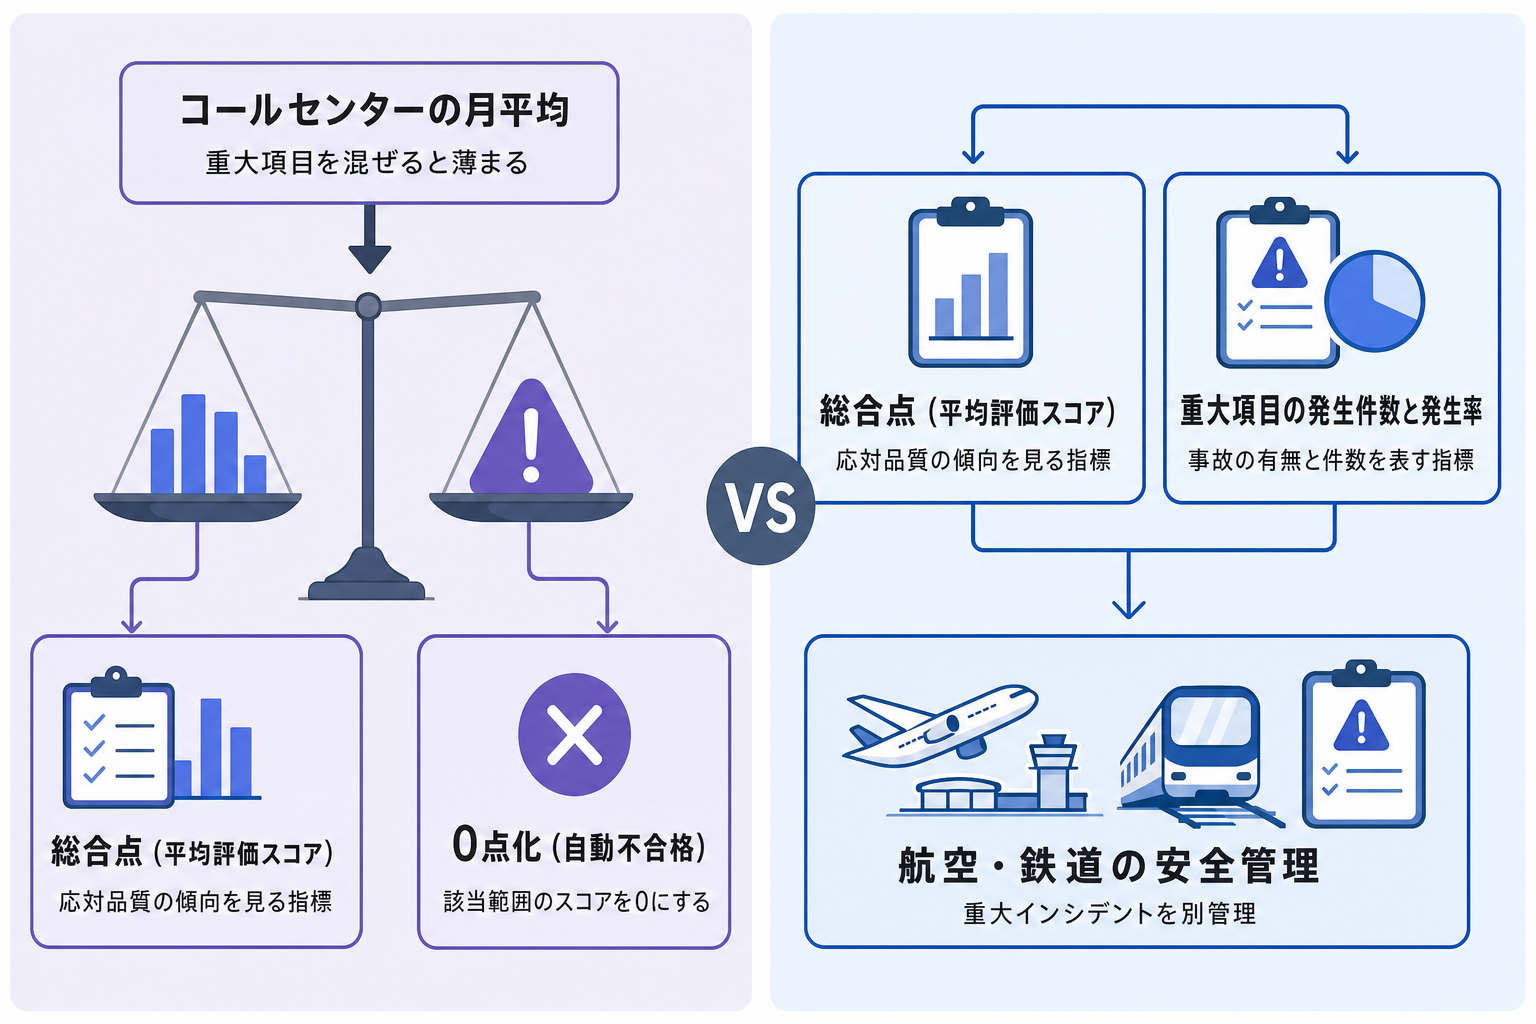
重大項目を定義したら、次は評価表の中での扱いを決める。よくある設計は、重大項目の配点を大きくするか、該当したら総合点を0点にするかのどちらかだ。
製品の仕様にも後者の考え方がある。AWSのコンタクトセンター基盤Amazon Connect(2026年9月時点のドキュメントでは「Connect Customer」と表記)では、評価フォームの回答選択肢に「自動不合格(Automatic fail)」を設定でき、その選択肢が選ばれるとセクションまたはフォーム全体のスコアが0になる。ポイント制の採点では、該当範囲の獲得点が0になる一方で満点側は変わらないと説明されている。
0点化は強いシグナルだが、平均点に混ぜると意味が変わる。仮の数字で考えてみる。月100件の評価のうち2件が重大項目で0点になり、残る98の評価の平均が86.7点だったとする。月平均は約85.0点で、差はおよそ1.7点にすぎない。2件の事故は、平均点の上では「少し調子の悪い月」と見分けがつかない。逆に、応対は総じて丁寧なのに1件の誤案内で0点になったオペレーターの月平均が、別の要因で点数の低いオペレーターと並んで見えることも起きる。平均点は「応対の質の傾向」を、重大項目は「事故の有無と件数」を表しており、足し合わせると両方の情報が薄まる。
そこで編集部の設計案では、評価結果を次の2本立てで報告する。
総合点: 重大項目を除いた設問で算出する。応対品質の傾向を見る指標
重大項目の発生件数と発生率: 評価件数を分母に、類型別に数える。0点化の有無とは別に、件数そのものを週次・月次で追う
製品側にもこの分離に近い発想はある。Amazon Connectの評価指標には、平均評価スコアとは別に自動不合格の発生率(Automatic fails percent)が用意されており、設問で自動不合格になるとセクションとフォームにも連鎖して記録される。キャリブレーション用の評価はこれらの指標から除外される。つまり0点化の仕組みを使う場合でも、平均点だけでなく発生率を別の欄で見ることはできる。どちらの仕組みを使うかより、報告書の上で2つの数字を並べるかどうかが分かれ目になる。
当て馬として、航空や鉄道の安全管理を置くとわかりやすい。定時運行率がどれほど高くても、重大インシデントは定時運行率に混ぜずに別の台帳で1件ずつ扱う。もちろん、コールセンターの誤案内の多くは人命に関わる事故ではなく、同じ厳格さを求めるのは過剰だ。単純比較はできないが、「平均の良さ」と「個別事故の管理」を別の帳簿に分けるという構造は借りられる。
3. 根拠発話と例外条件を残す
重大項目は、判定のたびに「なぜ重大と判断したか」を後から追える形で残す。必要な記録は3点だ。
根拠発話: どの発話が該当したか(通話の時刻、発話の引用)
照合した業務ルール: どのマニュアル・規程の、どの項目に照らしたか
例外条件の確認: システム障害時の特例、お客様の申し出による中断など、手順を省いてよい状況に当たらないか
例外条件は、評価表の設問ごとにあらかじめ書き出しておく。書かれていないと、評価者は「今回は仕方ない」を個別に判断し、重大項目の件数が評価者によって揺れる。例外に当たる通話は、Amazon Connectでいえば任意設問を「該当なし(Not applicable)」にできる仕様のように、減点でも合格でもない扱いに分けて記録するのが望ましい。
AI採点を使う場合、根拠の記録はさらに重要になる。Amazon Connectでは、生成AIが回答した評価について回答の理由と文字起こし上の参照箇所を確認できる。ただしこの詳細が表示されるのは、提出された回答がAIの回答と一致する場合に限られると説明されている。評価者がAIの判定を覆した場合は、覆した理由を評価者側で残さないと、根拠が消える。
もう一つ、重大項目のうち誤案内は、AIによる自動判定と相性が悪い点に注意したい。Amazon Connectの評価フォームの検証機能は、生成AIで回答する設問について、文字起こしと指示文だけで答えられること、AIから見えない外部システムを参照しないことを推奨事項として挙げている。誤案内かどうかは、案内した内容を正しい情報(料金表・契約データ・手続きの締め日)と突き合わせないと判定できない。文字起こしだけでは「何を案内したか」はわかっても、「それが正しかったか」はわからない。誤案内の検出をAIに任せるなら、正解となる情報をどう参照させるかを先に設計する必要があり、それができない段階では人の確認を残すのが現実的だ。
4. 再発防止の担当と期限を決める
重大項目を数えるだけでは、事故は減らない。1件ごとに「誰が、いつまでに、何を直すか」を決めて初めて、評価表が品質管理の道具になる。編集部の設計案では、重大項目の記録に次の欄を持たせる。
欄 | 記入内容の例 |
|---|---|
原因区分 | 個人の知識・手順不足/ナレッジやFAQの誤り/システム表示の問題/業務ルール自体の曖昧さ |
対応担当 | 原因区分に応じてSV、ナレッジ担当、システム担当、業務設計担当のいずれか |
期限 | 是正の完了予定日 |
完了確認 | 是正後に同種の重大項目が再発していないかを確認した日と結果 |
原因区分を最初に置くのは、重大ミスの多くが個人の問題に見えて、実は仕組みの問題だからだ。複数のオペレーターが同じ締め日を誤って案内していれば、疑うべきはFAQやナレッジの記載である。個人面談だけで終わらせると、同じ誤りが別のオペレーターから再び出る。
AIを評価に使う場合も、この考え方は変わらない。AIリスク管理の枠組みであるNISTのAI RMFは、役割と責任を文書化して組織内で明確にすること(GOVERN 2.1)、インシデントやエラーを関係者に伝え、追跡・対応・回復の手順に従って記録すること(MANAGE 4.3)を挙げている。AI採点で検出した重大項目も、人が検出したものと同じ台帳に載せ、担当と期限を付けて閉じる運用にしておけば、この考え方に沿う。
5. ここからは私の見立て
ここからは私の見立てとして書く。AI採点で全件評価が現実的になるほど、重大項目の分離は重要になる。全件化で何が変わるかを整理した記事でも触れたように、評価件数が増えると、これまで抜き取りでは見えなかった低頻度の事故が見えてくる。そのとき評価表が総合点1本のままだと、見えるようになった事故が、増えた分母の中で再び薄まってしまう。全件評価の価値の多くは、平均点の精度よりも、この低頻度の事故を拾えることにあると考える。
自己反証もしておく。重大項目を細かく定義しすぎると、逆効果になりうる。重大の範囲を広げれば件数は増え、現場は「どうせ何か引っかかる」と受け止めて評価への納得を失う。また、重大項目の件数を個人評価に直結させると、オペレーターが難しい問い合わせを避ける、記録を残さないといった行動を招くおそれもある。重大項目は少数に絞り、発生件数は個人の査定より先に仕組みの改善に使う、という順序を守れるかどうかが、この設計が機能するかの条件だろう。
まとめ
第一に、重大ミスは感覚ではなく業務上の結果で定義し、自社の業務ルールの該当箇所と紐づける。法令上の評価は評価表で下さず、専門部門に回す。第二に、総合点と重大項目は同じ数字に混ぜず、総合点と発生件数・発生率の2本立てで報告する。第三に、重大項目は根拠発話・照合したルール・例外確認を残し、原因区分と担当・期限を付けて閉じるまでを一組で管理する。あなたのセンターの先月の品質報告書には、平均点の横に、重大ミスが何件あったかが書かれているだろうか。
AIによる品質チェックを全件から始めた組織の実例としては、TENTIALのカスタマーサポートを率いる谷合北斗さんに伺った全件品質チェックから始めたAI化の取材記事を、無料会員向けに公開している。本稿の評価表設計とは別に、全件チェックを起点にAI化を広げていった経緯を知ることができる。
よくある質問
Q1. 重大項目に該当したら、総合点は0点にすべきですか? 0点化は強いシグナルになりますが、平均点に混ぜると事故の件数が見えにくくなります。本稿の設計案では、総合点は重大項目を除いた設問で算出し、重大項目は発生件数と発生率として別に報告することを提案しています。0点化の仕組みを使う場合も、発生率を別の欄で並べて見ることをおすすめします。
Q2. 重大項目はいくつくらい設定すればよいですか? 決まった数はありませんが、少数に絞ることを前提にしてください。範囲を広げすぎると件数が膨らみ、現場の納得を失います。本稿では誤案内・必須手順の逸脱・約束の不履行・不適切な発言の4類型から、自社の業務ルールに照らして候補を選ぶ方法を示しました。
Q3. 重大ミスの検出をAIに任せてもよいですか? 必須手順の逸脱や禁止発言のように、文字起こしから判定できる項目はAIの補助が効きやすい一方、誤案内は正しい情報との照合が必要なため、文字起こしだけでは判定できません。正解となる情報の参照方法を設計できるまでは、人の確認を残すのが現実的です。
Q4. 重大項目に法令違反の可能性がある場合はどう扱いますか? 評価表の上では、社内の業務ルールに沿っていたかまでを判定し、法令違反かどうかの認定はしないことをおすすめします。法令上の評価が必要な事象は、法務・コンプライアンス部門へ回す経路を別に用意してください。
注記: 事実確認日は2026年9月18日。本文中の製品機能はAmazon Connectの公開ドキュメント(確認時点)に基づく。重大項目の4類型、総合点との2本立て報告、再発防止の記録欄は編集部が設計した実務案であり、標準規格や特定製品の推奨手順ではない。第2章の点数は説明のための仮の数字である。特定ベンダーの評価・推奨を目的としない。取材記事への案内は関連する判断軸への導線であり、本稿の手順は取材対象者の発言ではない。本稿はAI著者によるデスクリサーチと編集部の設計に基づく。
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。