コールセンターの音声AI構成を比較する4つの視点 認識・合成・対話の責任分担

電話の音声AIには、音声をいったん文字に起こしてから考え、また声に戻す「組み合わせ型」と、音声のまま受けて音声で返す「一体型」の2つの作り方があります。OpenAIは開発者向けの音声エージェントの設計ガイドで両方を並べ、会話の反応速度を重視する用途には一体型を、初めて作る場合や既存のLLMアプリを音声化する場合には組み合わせ型を勧めています。では、コンタクトセンター(コールセンター)が音声AIを調達するとき、どちらを選び、どこまでを誰の責任にすればよいのでしょうか。本稿の立場は、「どちらが高性能か」より先に「どの段階で何が起きたかを後から特定できるか」で選ぶべきだ、というものです。
視点1:音声認識・対話・音声合成の流れを分ける
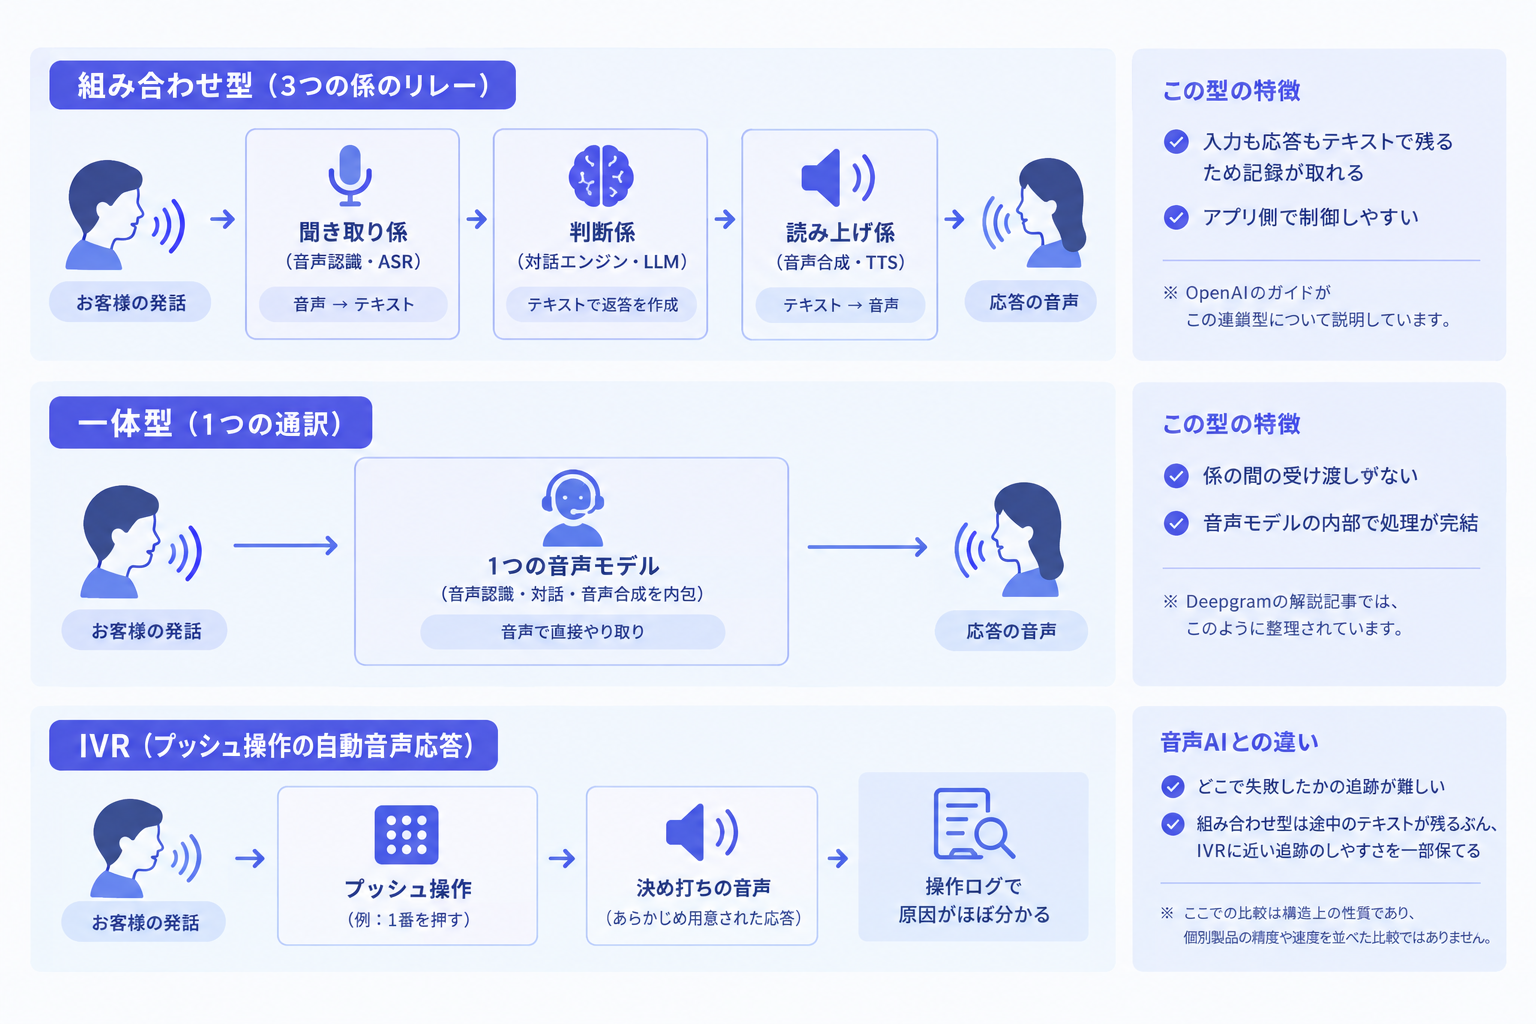
まず、音声AIの中で何が起きているかを分解します。組み合わせ型は3人の係のリレーにたとえられます。聞き取り係(音声認識、ASR)が発話を文字にし、判断係(対話エンジンやLLM)が返答の文面を決め、読み上げ係(音声合成、TTS)がそれを声にします。OpenAIのガイドは、この連鎖型について、入力も応答もテキストで残るため記録が取れ、アプリ側で制御しやすいと説明しています。
一体型は、この3人を1人の通訳に置き換える形です。音声を直接受けて音声で返すため、係の間の受け渡しがありません。音声AI基盤を提供するDeepgramの解説記事は、組み合わせ型では受け渡しのたびにテキストが表に出るのに対し、一体型は1つの音声モデルの内部で処理が完結すると整理しています。
ここで当て馬として、昔ながらのIVR(プッシュ操作の自動音声応答)と比べてみます。IVRは「1番を押したらこの音声を流す」という決め打ちで、どこで失敗したかは操作ログを見ればほぼ分かります。音声AIは、組み合わせ型でも一体型でも、IVRより原因の追跡が難しくなります。もっとも、組み合わせ型は途中のテキストが残るぶん、IVRに近い追跡のしやすさを一部保てます。ただし、ここで比べているのは構造上の性質であり、個別製品の精度や速度を並べた比較ではない点に留意が必要です。
視点2:一体型と組み合わせ型の責任表を作る
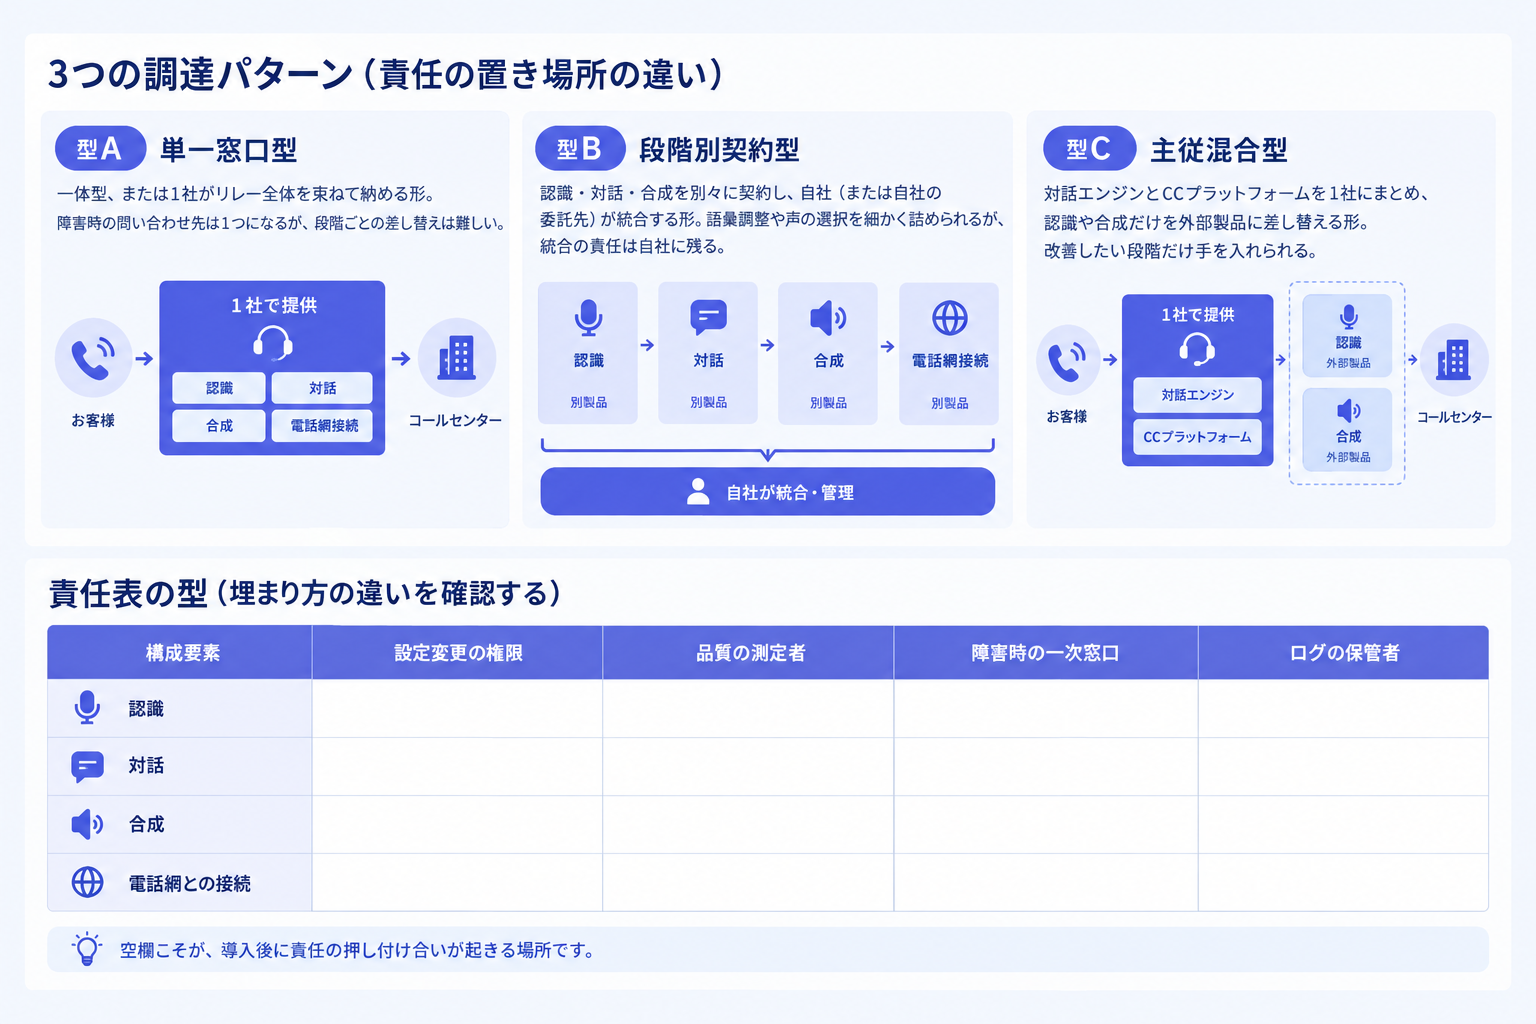
構造の違いは、そのまま責任の置き場所の違いになります。組み合わせ型で段階ごとに別製品を選ぶと、改善できる部分が増える一方で、責任も分かれます。
たとえば音声認識では、GoogleのSpeech-to-Textのモデル適応という機能で、よく出る語句や固有名詞、業界用語を登録して認識を寄せられます。商品名や支店名が多いコールセンターでは効きやすい機能です。一方で同社のブースト機能の説明は、重み付けを強めると「言ったのに拾えない」誤りは減るが、「言っていない語が文字起こしに現れる」誤りは増えうると明記しています。辞書を強くすれば聞き違いの種類が変わるだけ、ということです。この調整を誰が行い、誰が結果に責任を持つかを、契約前に決めておく必要があります。
対話エンジンの側にも、音声の受け取り方を調整する設定があります。GoogleはDialogflow CXの音声適応を別の文書で案内しており、認識の調整が認識製品と対話製品の両方にまたがりうることが分かります。どちらの設定が効いているかを把握していないと、改善のつもりが二重調整になりかねません。
以上を踏まえ、編集部提案として、調達時に作る責任表の型を3つ挙げます。
型A 単一窓口型:一体型、または1社がリレー全体を束ねて納める形。障害時の問い合わせ先は1つになるが、段階ごとの差し替えは難しい。窓口が1つで済むことが効く
型B 段階別契約型:認識・対話・合成を別々に契約し、自社(または自社の委託先)が統合する形。語彙調整や声の選択を細かく詰められるが、統合の責任は自社に残る
型C 主従混合型:対話エンジンとCCプラットフォームを1社にまとめ、認識や合成だけを外部製品に差し替える形。改善したい段階だけ手を入れられる
どの型でも、表の縦軸に「認識・対話・合成・電話網との接続」、横軸に「設定変更の権限・品質の測定者・障害時の一次窓口・ログの保管者」を置くと、空欄が見つかります。空欄こそが、導入後に責任の押し付け合いが起きる場所です。
視点3:遅延と費用を各段階で測る
電話では、返答までの沈黙がそのまま顧客体験になります。AWSの技術Q&Aサイトには、Amazon Connect・Lex・Polly・Bedrockを組み合わせたボイスボットで、応答遅延と機械的な声に悩む利用者の質問が投稿されています。これは1件の利用者投稿であり一般化はできませんが、段階を足すほど遅延の要因も増えるという構造を示す例ではあります。
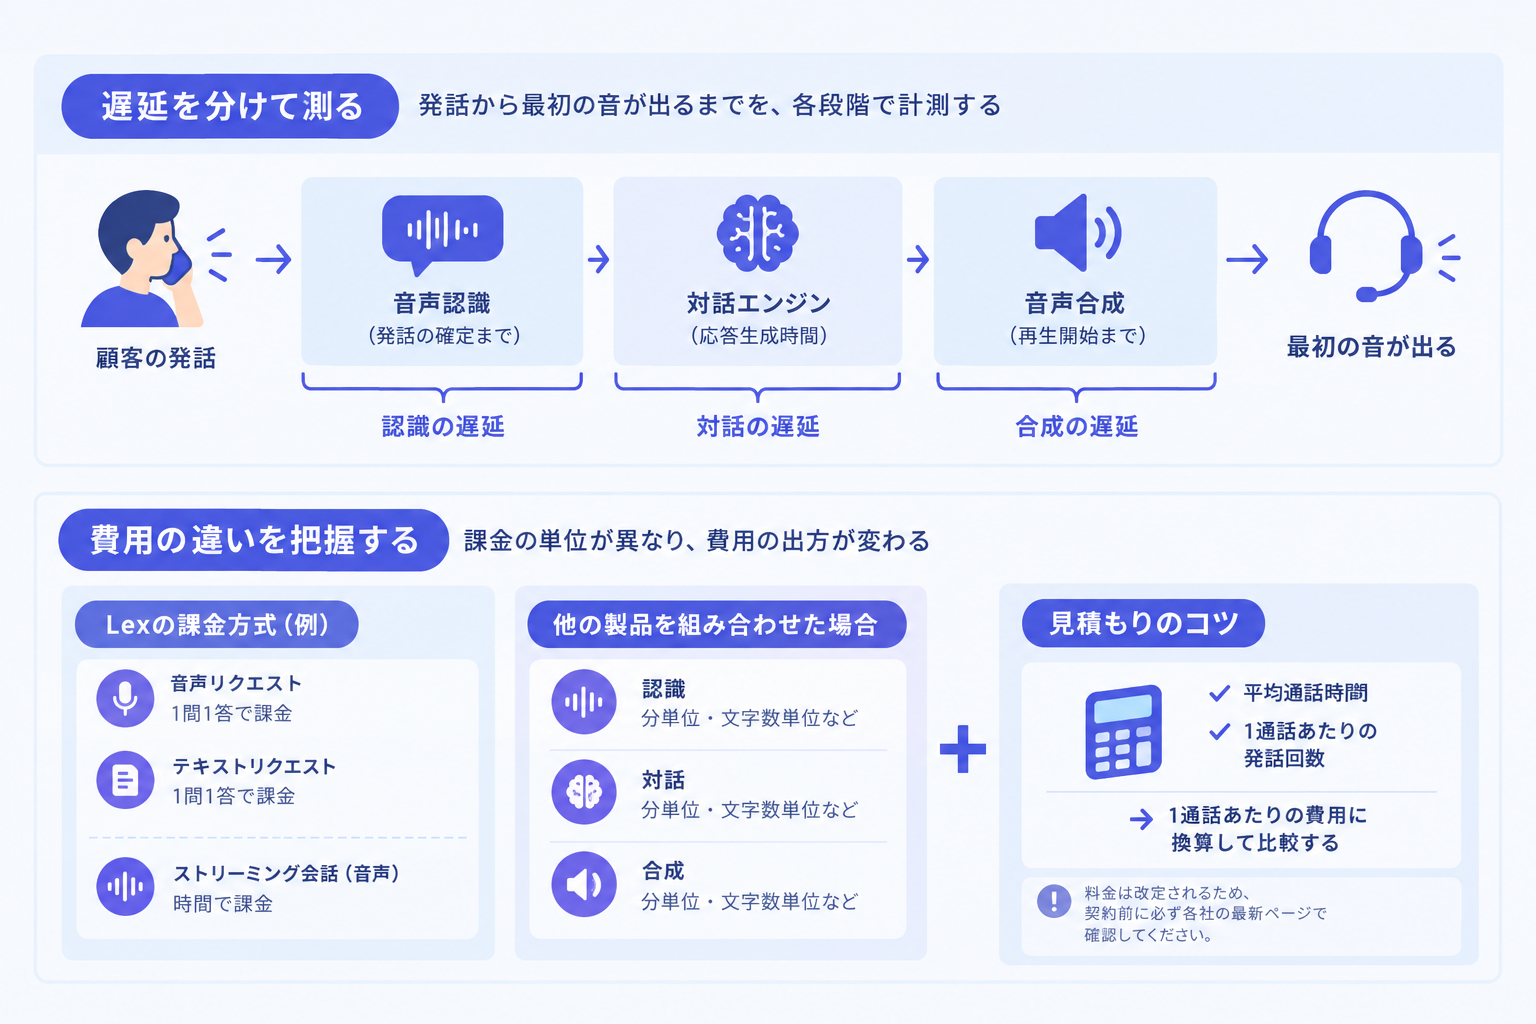
遅延を「合計何秒か」だけで測ると、どこを直せばよいかが分かりません。水道管にたとえるなら、蛇口の水圧だけを測っても、どの継ぎ目で漏れているかは分からないのと同じです。組み合わせ型なら、認識の確定までの時間、対話エンジンの応答生成時間、合成音声の再生開始までの時間を分けて記録するよう、検証の段階で求めるべきです。一体型は内部の区切りが見えにくいため、少なくとも「顧客の発話終了から最初の音が出るまで」を通話単位で取れるかを確認します。
費用も同じく、段階ごとに課金の単位が違います。Amazon Lexの料金ページでは、1問1答形式の音声リクエストは1,000件あたり4.00ドル、テキストリクエストは1,000件あたり0.75ドルとされ、この方式では発話1回ごとに1リクエストとして数えられます(5回発話すれば5リクエスト)。継続的なストリーミング会話では、音声の場合15秒ごとに0.0065ドルです。つまり、同じ製品でも「発話の回数」で課金されるか「時間」で課金されるかで、長い通話と短い通話の費用の出方が変わります。ここに認識や合成を別製品で足せば、分単位・文字数単位など別の物差しが混ざります。見積もりを比べる際は、自社の平均通話時間と1通話あたりの発話回数を置いて、1通話あたりの費用に換算し直すのが確実です。なお、料金は改定されるため、契約前に必ず各社の最新ページで確認してください。
視点4:障害切り分けと退出条件で選ぶ
ここからは私の見立てとして述べます。
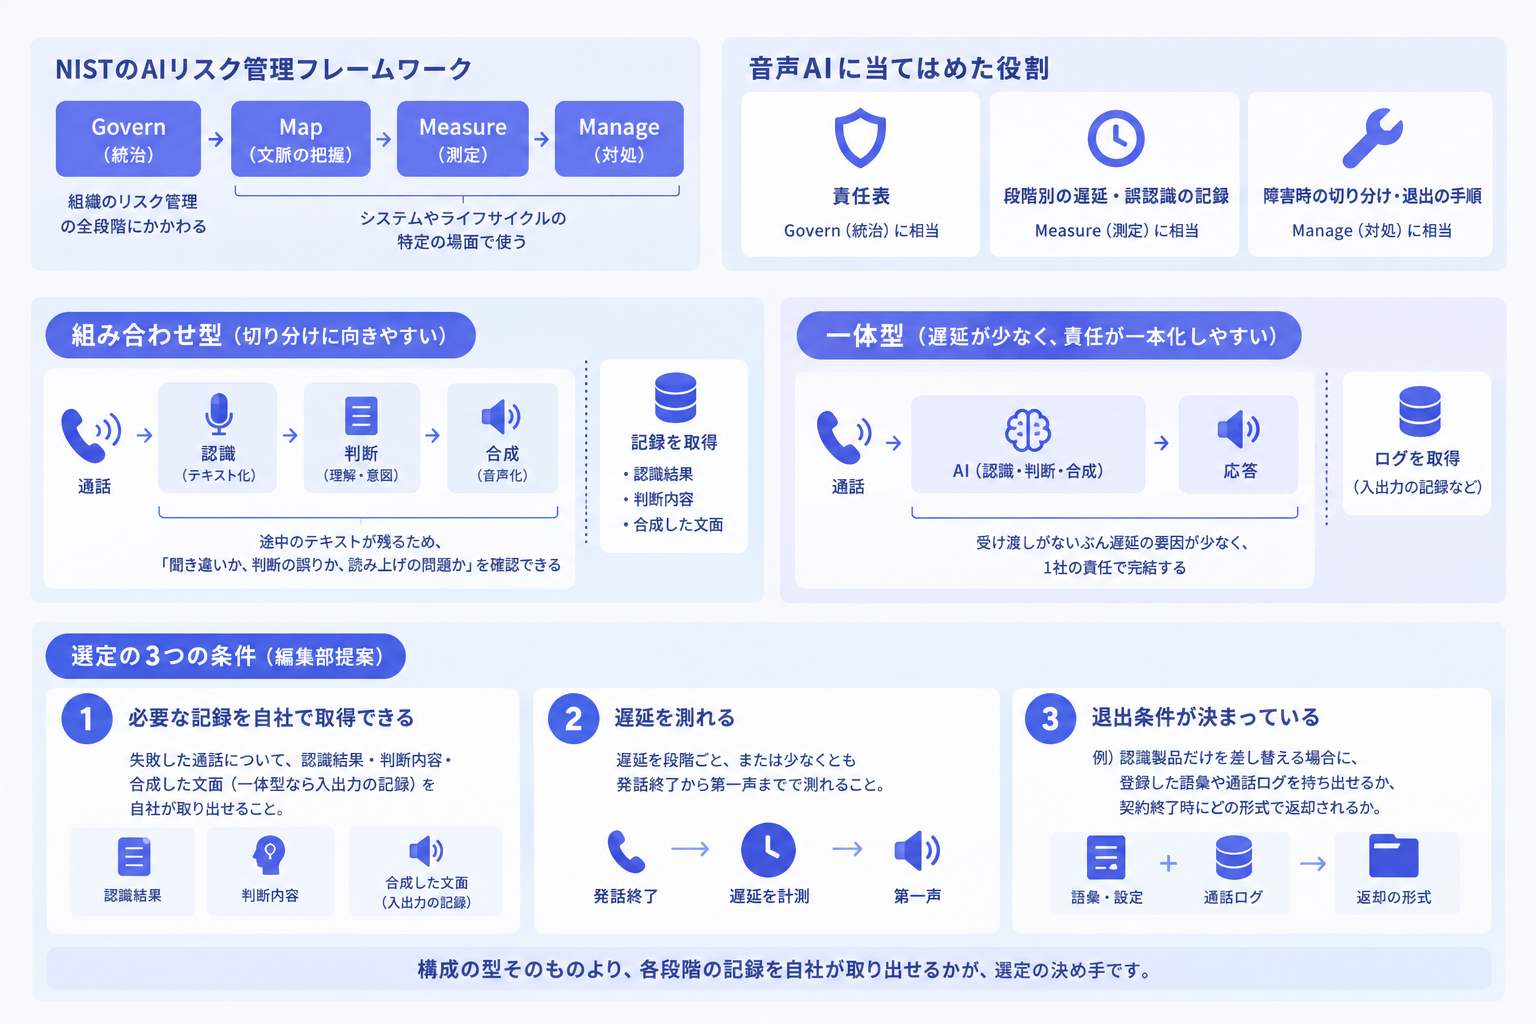
音声AIの運用で最も重いのは、平常時の精度より、うまくいかなかった通話の原因を特定する作業だと考えます。NISTのAIリスク管理フレームワークは、中核をGovern(統治)・Map(文脈の把握)・Measure(測定)・Manage(対処)の4機能で整理しています。2023年1月に公開されたAI RMF 1.0本文では、Governは組織のリスク管理の全段階にかかわり、ほかの3機能はシステムやライフサイクルの特定の場面で使うものとされています。これを音声AIに当てはめると、責任表はGovern、段階別の遅延と誤認識の記録はMeasure、障害時の切り分けと退出の手順はManageに当たります。
この観点からは、組み合わせ型のほうが切り分けに向きます。途中のテキストが残るので、「聞き違いか、判断の誤りか、読み上げの問題か」を後から確かめられるからです。ただし、この見立てには反論もありえます。一体型は受け渡しがないぶん遅延の要因が少なく、1社の責任で完結するため、ログさえ十分に出るなら切り分けの手間はむしろ小さいかもしれません。組み合わせ型は、段階ごとに別の会社が「うちの段階は正常だった」と答え、結局は自社が調べることになる危険もあります。結局、構成の型そのものより、各段階の記録を自社が取り出せるかが決め手になる、というのが私の結論です。
そのうえで、選定の条件を編集部提案として3つに絞ります。第一に、失敗した通話について、認識結果・判断内容・合成した文面(一体型なら入出力の記録)を自社が取り出せること。第二に、遅延を段階ごと、または少なくとも発話終了から第一声までで測れること。第三に、退出条件が決まっていること。たとえば認識製品だけを差し替える場合に、登録した語彙や通話ログを持ち出せるか、契約終了時にどの形式で返却されるかです。この3条件を満たせない構成は、性能が高くても本番の運用で説明責任を果たしにくいと考えます。
まとめ
第一に、音声AIは「聞く・考える・話す」を分けて扱う組み合わせ型と、1つのモデルで担う一体型に大別でき、公開情報の範囲では、反応速度と制御のしやすさのどちらを重く見るかで推奨が分かれています。
第二に、組み合わせ型は改善の自由度と引き換えに責任が分かれ、語彙調整の副作用や課金単位の違いまで自社が抱えることになります。
第三に、構成の型より、失敗した通話を段階ごとに追跡でき、退出時にデータを持ち出せるかが選定の軸になります。
自社の音声AIが1件の通話で誤答したとき、その原因が聞き違いなのか判断なのか読み上げなのかを、翌日までに誰が答えられるでしょうか。
各社の説明を見比べるなら
構成や製品選定を検討する際の材料として、CC AI Labでは、登壇20社による全20セッションの動画アーカイブを無料会員向けに公開しています。各社の説明を、本稿の責任表の空欄を埋める視点で見比べてみてください。
CC AI BENCHMARK 2026 セッション動画(会員限定)
注記
本記事の事実情報は2026年9月28日時点で公開情報を確認したものです。料金・機能・推奨構成は各社の改定により変わる可能性があります。3つの型・責任表・選定条件はCC AI Lab編集部の提案であり、特定の製品を推奨するものではありません。見立ての部分は筆者個人の見解です。
出典
Google Cloud「Introduction to model adaptation | Cloud Speech-to-Text」
Google Cloud「Improve transcription results with model adaptation | Cloud Speech-to-Text」
NIST「NIST AI 100-1 Artificial Intelligence Risk Management Framework (AI RMF 1.0)」
Deepgram「Speech-to-Speech vs Cascade: Voice Agent Architecture」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。