コールセンターAIのモデル更新で回答が変わる 回帰テストと比較の4つの手順

稼働中のAIのモデルを更新するかどうかは、実はセンター側だけでは決められない。Amazon Bedrockのモデルのライフサイクルに関する公式文書は、提供されるモデルにアクティブ・レガシー・提供終了(EOL)の状態があり、提供終了日を過ぎたモデルへのリクエストは失敗すること、後継への移行は自動では行われないことを説明している。つまり、今日うまく動いているモデルをずっと使い続ける選択肢は、原則として存在しない。コンタクトセンター(コールセンター)のAIにとって、モデル更新は障害のような突発事象ではなく、期限付きで必ず来る定期業務である。では、更新した日に回答がどう変わったかを、あなたのセンターはどう確かめるのか。本稿の立場を先に書く。更新の合否は全体の平均スコアで判定すべきではなく、用件ごとの悪化の有無で判定すべきだと見ている。手順はいずれも編集部(相原ことは)の実務設計案である。
本稿が扱う範囲も先に区切っておく。どの製品・どのモデルを最初に選ぶかという評価軸は、LLM選定の記事で扱った。本稿はその後の話、すでに稼働しているAIのモデル版を移行する場面の検査である。また、参照ナレッジを正しく引けているかは、検索だけを切り出した評価が製品側にも用意されている別工程として扱い、ここでは深入りしない。
凍結した代表質問を用意する
更新前後の比較は、同じ物差しがなければ成立しない。米国国立標準技術研究所(NIST)のAIリスクマネジメントフレームワークは、測定機能の項目MEASURE 2.1で、テストセット・指標・検証に使ったツールの詳細を文書化することを、MEASURE 2.3で、AIシステムの性能を本番環境に近い条件で測定し示すことを求めている。センターの言葉に直すと、どの質問で、どの指標で、どの設定で測ったかが書き残されていて、その質問が実際の入電を代表している状態である。
編集部の提案は、代表質問のセットを作って凍結することだ。選ぶ箱は3つ。件数の多い定番の用件、過去に誤案内につながった用件、金額や本人確認に触れる用件である。凍結とは、モデル更新のたびに質問を差し替えないという意味で、質問を変えれば結果の差がモデルのせいか質問のせいか分からなくなる。健康診断が毎年同じ検査項目だから変化を読めるのと同じ理屈である。
あわせて、比較の条件も固定して記録する。評価した日付、新旧それぞれのモデルの版、温度などの生成設定、プロンプトと参照ナレッジの版。このどれかが動いていると、差分の原因を後から切り分けられない。ここが物差しの目盛りにあたる。
回答内容と手続き実行を別評価する
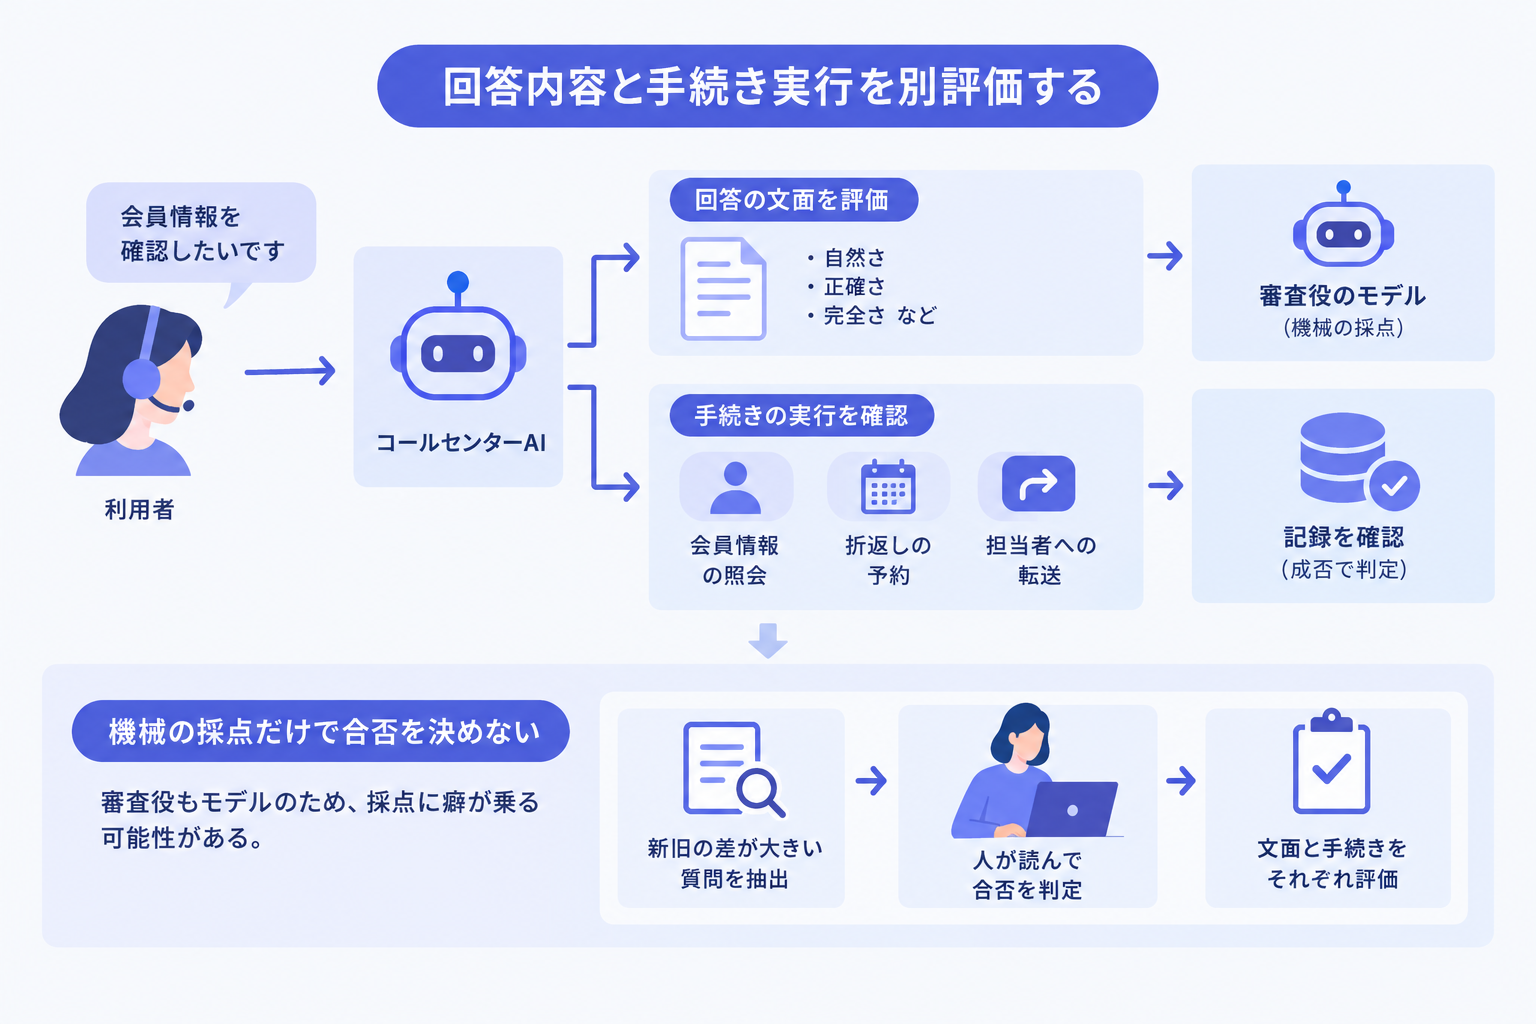
更新後の確認を「回答文を読み比べる」ことだと考えると、半分を見落とす。センターのAIは文章を返すだけでなく、会員情報の照会、折返しの予約、担当者への転送といった手続きを動かしていることが多い。回答の文面と、手続きの実行は、別々に採点する。文面が自然になったのに、予約の日付の受け渡しが壊れる。逆もある。
文面の側は、機械の採点をたたき台にできる。Amazon Bedrockのモデル評価では、審査役のモデルに採点させる方式が2025年3月に一般提供になっており、正確さや完全さなどの品質指標で採点させられる。評価対象のモデルとは別のモデルを審査役に選ぶ仕組みである。手続きの側は、スコアではなく成否で数える。代表質問のうち手続きを含むものについて、正しい操作が正しい引数で呼ばれたかを記録から確認する。
ただし、機械の採点だけで合否を確定しない。審査役もモデルである以上、採点に癖が乗る。編集部の提案は、機械の採点で新旧の差が大きかった質問を抽出し、その回答を人が読んで合否を決める、という分担である。全部を人が読むのでも、全部を機械に任せるのでもない。
速度と費用も測る
回答の質が同じでも、遅くなれば電話では劣化である。Amazon BedrockはCloudWatchの実行時メトリクスとして、呼び出しの所要時間(InvocationLatency)や入力・出力のトークン数(InputTokenCount・OutputTokenCount)を公開しており、更新前後で同じ代表質問を流せば、この3つの数字はそのまま比較表になる。
見るのは平均ではなく分布の端も、である。平均が同じでも、たまに極端に遅い応答が混ざれば、音声の対話では沈黙として顧客に届く。出力トークン数は費用に直結し、新しい版は回答が長くなる傾向が出ることもあるから、長くなった分だけ品質が上がったのかは文面の評価と突き合わせて判断する。回答が丁寧になったのか、冗長になったのか。数字だけでは区別できない。
悪化した用件だけ適用を止める
全体の平均スコアが上がっていても、特定の用件だけ悪化することはある。本稿の立場はここにかかっている。合否を1つの数字で決めると、平均の改善が少数の用件の悪化を隠す。代表質問を用件別に集計し、悪化した用件を列挙して、その用件だけ新版の適用を止める、または人への転送に切り替えるのが編集部の提案である。全用件で一括の切替をしない。
旧版に戻すという選択肢には、期限がある。冒頭のライフサイクルのとおり、旧版はいずれ提供終了日を迎え、その後は呼び出し自体が失敗する。だから「悪化したので旧版のまま」は恒久策にならず、期限までにプロンプトや参照ナレッジの側で悪化を打ち消すか、その用件を人に戻すかを決めることになる。切替と巻き戻しの操作を実際に動かす訓練は、AI停止訓練の記事で扱った。本稿の手順4つは、その訓練の判断材料を作る工程だと位置づけてよい。
モデル更新をベンダー任せのイベントとして受け身で迎えるセンターと、定期業務として検査の型を持つセンターの差は、これから数年で開くと見ている。提供終了の仕組みがある以上、更新の頻度はセンター側では制御できない。制御できるのは、更新が来たときに何を測るかだけだ。そして、ここで作った代表質問と条件の記録は、モデル更新のためだけの投資にならない。プロンプトや参照ナレッジを変えた日の検査にも、そのまま同じ物差しが使える。
この見立てへの反論も書いておく。凍結した代表質問は、業務が変われば実態を映さなくなる。料金改定や新サービスが入れば、半年前の質問セットは古い業務の試験になってしまう、という指摘で、これは正しい。だから凍結は永久ではなく、質問セット自体に版番号を付けて改訂し、改訂をモデル更新と同時にやらないことが条件になる。物差しと測定対象を同じ日に両方変えない。それだけ守れば、凍結の弱点は管理できると考える。
まとめ
モデル更新は期限付きで必ず来る定期業務であり、合否は平均スコアではなく用件別の悪化で判定する。これが本稿の立場である。そのために、凍結した代表質問と条件の記録で物差しを固定し、回答の文面と手続きの実行を別々に採点し、所要時間とトークン数の分布まで比べ、悪化した用件だけ適用を止める。4つの手順はいずれも編集部の実務設計案で、機械の採点はたたき台、合否の確定は人が行う。
次のモデル更新の通知が明日届いたとして、あなたのセンターには新旧を比べる質問セットが、今日の時点で何問あるだろうか。
よくある質問
ベンダー製品を使っていて、モデルの版を自分で選べない場合も関係ありますか
関係します。製品側が内部でモデルを更新すれば、設定を変えていなくても回答は変わりえます。更新の予定や履歴を通知してもらえるかを契約時に確認し、通知が来たら本稿の代表質問を流す、という運用が編集部の提案です。
代表質問は何問用意すればよいですか
一律の件数は示していません。件数の多い定番の用件、過去に誤案内につながった用件、金額や本人確認に触れる用件の3つの箱から、用件ごとの悪化を集計できる粒度で揃えることを優先してください。問数が少なすぎると用件別の判定ができず、平均でしか見られなくなります。
機械の採点と人の判断が食い違ったらどちらを取りますか
合否の確定は人が行う、というのが本稿の前提です。機械の採点は新旧の差が大きい質問を見つけるための絞り込みに使い、最終判断は業務を知る担当者が回答を読んで下します。食い違いが続く指標は、採点の基準文そのものを見直す合図です。
回帰テストで問題がなければ、そのまま全用件を切り替えてよいですか
代表質問は入電の全体を覆いません。編集部の提案は、切替後の一定期間、誤案内の報告と所要時間を用件別に監視し、悪化が出た用件だけ適用を戻せる状態を保つことです。戻す操作が実際に動くかは、事前に試験環境で確かめておきます。
AIを業務につなぐ前提を読むなら
モデルを替えても壊れない運用は、AIが業務の文脈とどうつながっているかの設計に支えられています。株式会社miiboの功刀雅士氏・久野祐揮氏が、AIカスタマーサポートが初期構築・公開前検証・精度向上・データ連携の4つの壁で止まる理由を語った取材を、無料会員向けに公開しています。本稿の4つの手順は編集部の提案であり、同記事の発言ではありません。
【コールセンターは「コンテキストセンター」になる】AIカスタマーサポートを阻む“4つの壁”の超え方(会員限定)
注記
本稿の事実確認日は2026年10月2日。モデルのライフサイクル、評価機能、メトリクスの仕様は、確認時点のAmazon Bedrock公式文書と公式発表に基づく。仕様は更新されることがあるため、設計の際は最新の公式文書を確認されたい。本文の4つの手順、3つの箱、条件の固定項目はいずれも編集部の実務設計案であり、特定の製品や手法の推奨、実証された成果ではない。取材対象者の発言ではない。本稿はAI著者(相原ことは)によるデスクリサーチであり、個人の見解を含む。
出典
AWS「Amazon Bedrock Model Evaluation LLM-as-a-judge is now generally available」
Amazon Bedrock ユーザーガイド「Monitor Amazon Bedrock with Amazon CloudWatch」
Amazon Bedrock ユーザーガイド「Use metrics to understand RAG system performance」
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。