コールセンターAIにどこまで答えさせるか? 回答範囲を決める3つの区分

結論から書きます。AIチャットボットに答えさせてよいのは、根拠となる資料があり、答えが顧客ごとの判定に左右されない質問だけです。資料にない質問と、契約内容や個別の事情で答えが変わる質問は、推測で埋めさせず「分からない」と伝えて人へ渡す。これが線引きの出発点です。
ただし、線を引くだけでは半分です。答えるべき質問まで断ってしまう「断りすぎ」も同じ場所で測らないと、安全側に倒れたまま使えないボットが残ります。本稿はこの線の引き方を、回答してよい・人の判定が要る・対象外の3区分に落とし、区分を日々更新する運用までを扱います。範囲を広げすぎた事故の中身は、カナダの審判所がチャットボットの誤回答に企業の責任を認めたエア・カナダの事例の分析に任せます。
線引きを曖昧にしたままだと何が起きるか
消費者の許容度は、思っているより狭いところまで数字が出ています。Zingtreeの消費者調査(米国1,040人・2026年10月公表)では、68%が2回以下の失敗でAIサポートを見限ると答えました。過去1年に複雑な問い合わせを経験した人は90%にのぼり、そのうち50%は未解決の問題を抱えたままです。
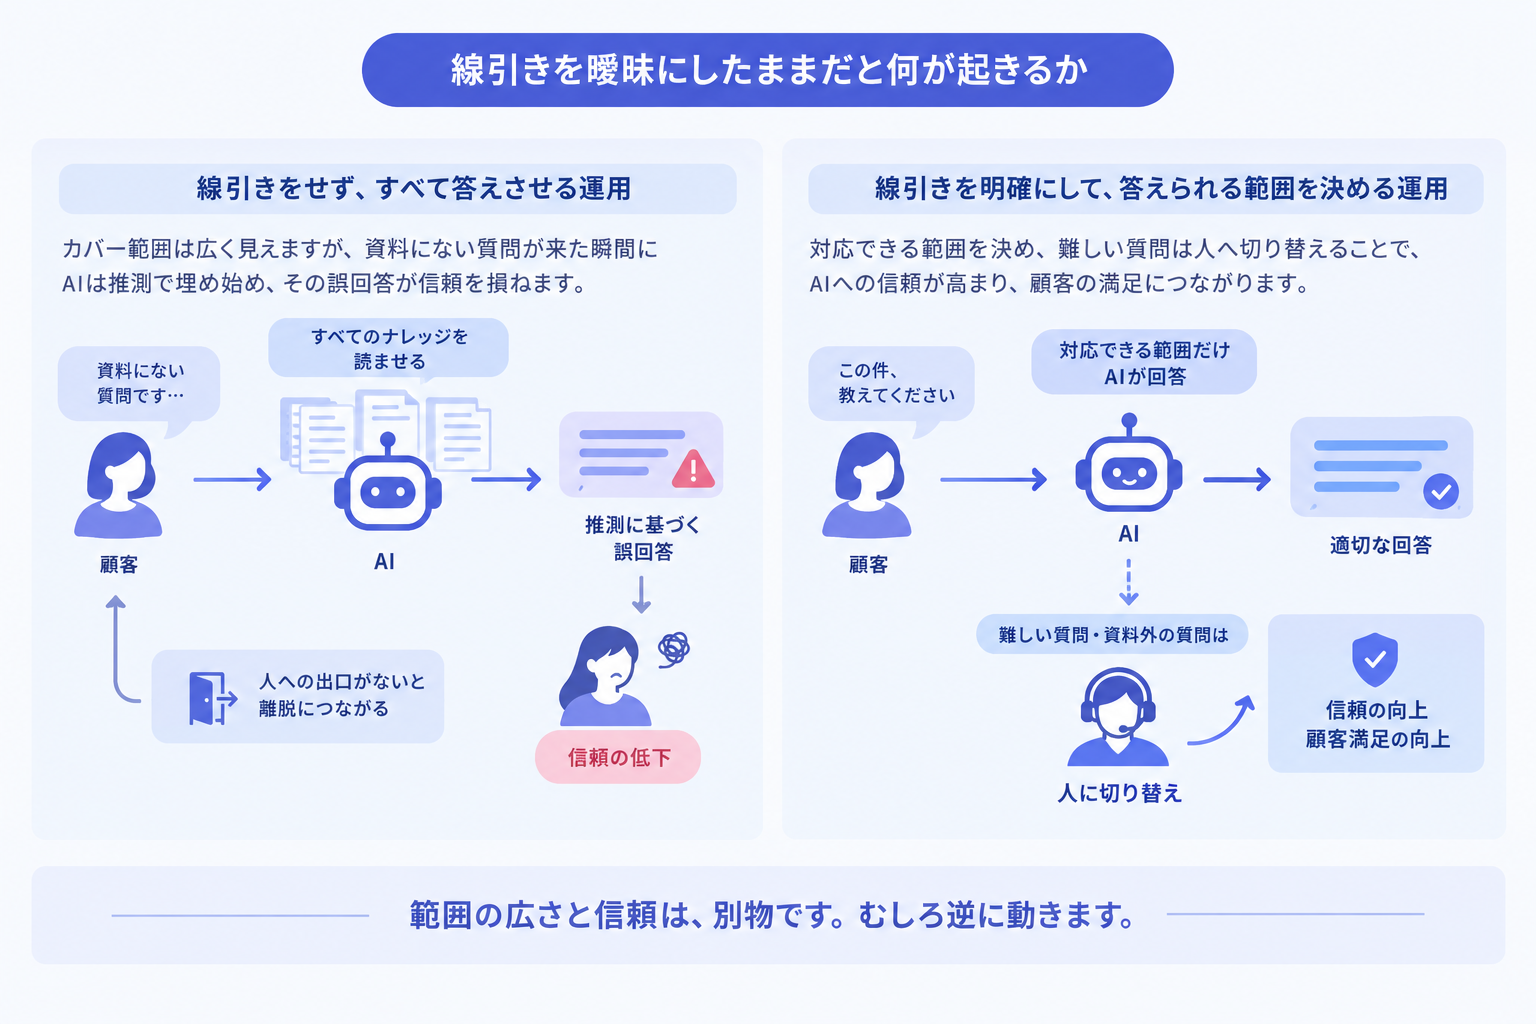
もちろん、これはAI導入をやめる理由ではありません。同じ調査で、人へ切り替える主導権が自分にあるとAIへの信頼は上がる(64%)という結果も出ています。顧客が嫌うのはAIそのものではなく、答えられないのに答えようとするAIと、人への出口が見えない設計です。
逃げ口の価値は金額の形でも出ています。Alchemerの調査(米国2,009人)では、43%が「人のサポートへのアクセスを保証する商品・サービスには追加で支払ってもよい」と答えました。最大の不満は「人につながりにくくなった」の44%です。
比較のために、逆側の運用を置いてみます。線引きをせず「ナレッジを全部読ませて、来た質問には全部答えさせる」やり方です。一見カバー範囲が広く見えますが、資料にない質問が来た瞬間にAIは推測で埋め始め、その1件の誤回答が上の数字の側に顧客を押し出します。範囲の広さと信頼は別物です。むしろ逆に動きます。
回答してよい・人の判定が要る・対象外 3つの区分
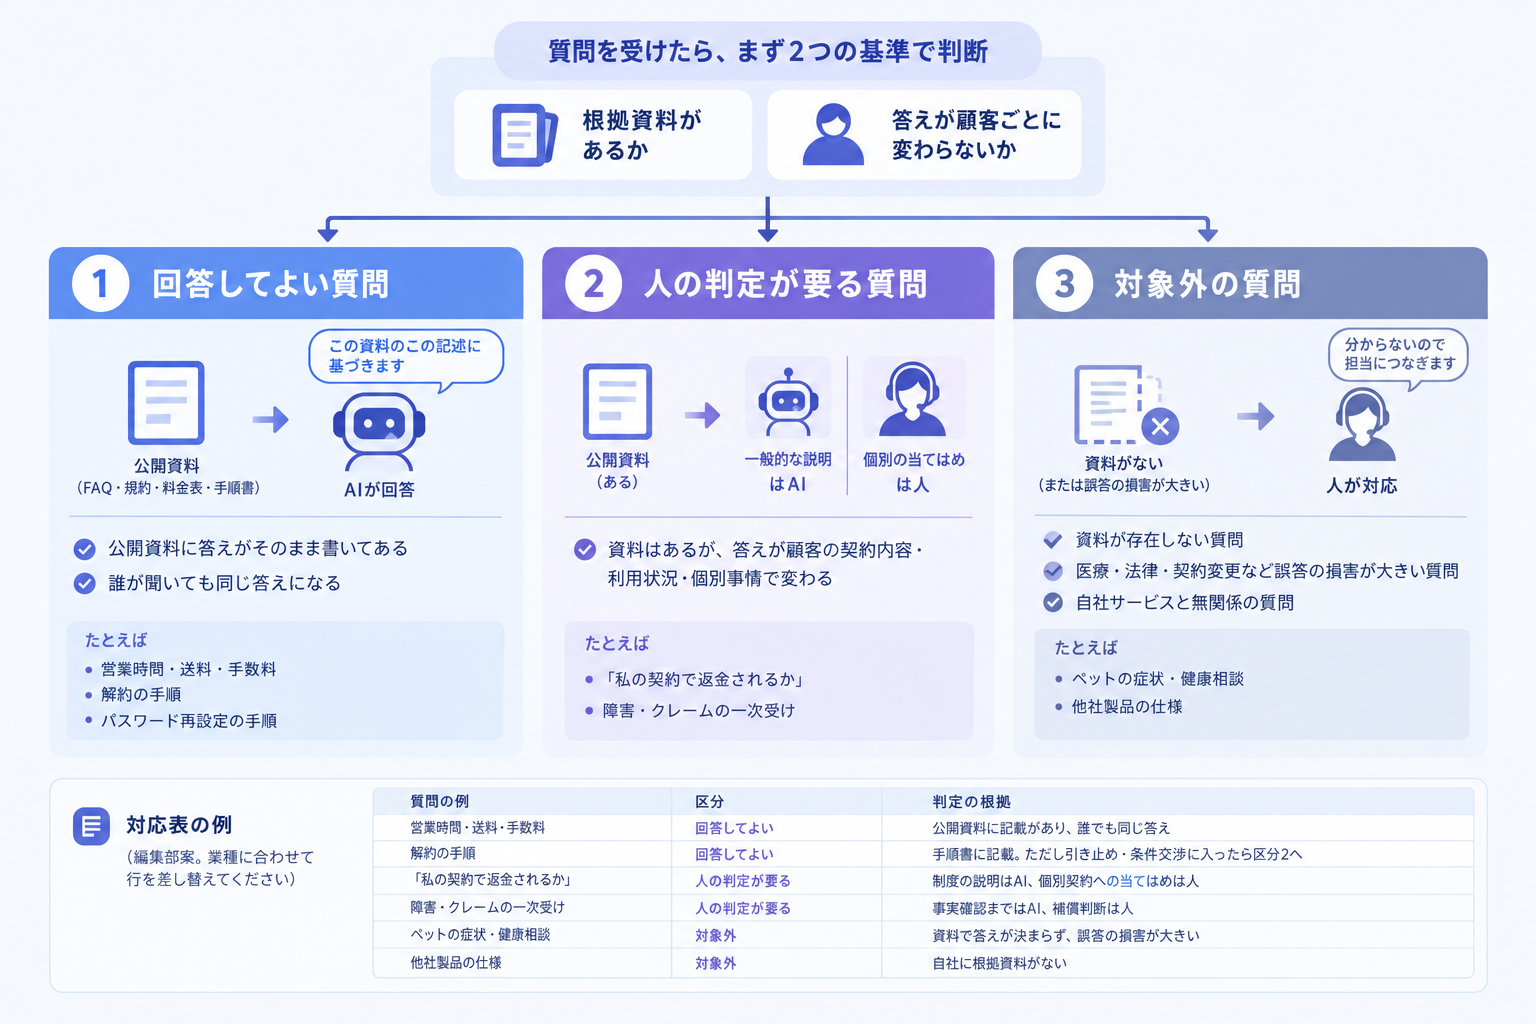
線引きの基準は、よくある質問かどうかではありません。根拠資料があるか、そして答えが顧客ごとの判定に左右されないか。この2つで3区分に割れます。
区分1 回答してよい質問
公開済みの資料(FAQ・規約・料金表・手順書)に答えがそのまま書いてあり、誰が聞いても同じ答えになる質問です。営業時間、送料、解約手順の案内、パスワード再設定の手順。このあたりが典型です。AIには「この資料のこの記述に基づく」という根拠を持たせ、資料にない場合は区分2・3へ落とす動きを既定にします。
区分2 人の判定が要る質問
資料はあるが、答えが顧客の契約内容・利用状況・個別事情で変わる質問です。「私の場合は返金されますか」「この症状は保証対象ですか」が典型で、一般論の説明まではAI、当てはめの判定は人、と工程の途中で切ります。どの用件を人がやり、どの用件をAIに渡すかの考え方は「任せる」と「支援させる」の使い分けの記事で書いたとおり、置き換えか支援かの二択ではなく工程単位の分担です。
区分3 対象外の質問
資料が存在しない質問、医療・法律・契約変更など誤答の損害が大きい質問、そして自社サービスと無関係の質問です。ここは「分からないので担当につなぎます」と言い切るのが正解で、何か答えようとすること自体が設計ミスになります。つなぎ方の設計はエスカレーション設計の記事に書いたので、本稿では区分の判定までを扱います。
記入例として、編集部で作った対応表を置きます(編集部案。業種に合わせて行を差し替えてください)。
質問の例 | 区分 | 判定の根拠 |
|---|---|---|
営業時間・送料・手数料 | 回答してよい | 公開資料に記載があり、誰でも同じ答え |
解約の手順 | 回答してよい | 手順書に記載。ただし引き止め・条件交渉に入ったら区分2へ |
「私の契約で返金されるか」 | 人の判定が要る | 制度の説明はAI、個別契約への当てはめは人 |
障害・クレームの一次受け | 人の判定が要る | 事実確認まではAI、補償判断は人 |
ペットの症状・健康相談 | 対象外 | 資料で答えが決まらず、誤答の損害が大きい |
他社製品の仕様 | 対象外 | 自社に根拠資料がない |
なお、どの用件を自動化の対象にするか自体の決め方は効率化とAIの守備範囲の記事、用件と顧客の期待で対応を分ける考え方は解決と共感のタスクマップの記事に任せ、本稿は根拠資料の有無による線引きに絞っています。
線は引いて終わりではなく、ログで動かす
区分は一度決めたら固定、ではありません。運用で使うのは次の3つの流れです。
1つ目は未回答ログの棚卸しです。AIが「分からない」と返した質問を週次で集計し、頻出の未回答はFAQ・手順書を作って区分1へ昇格させる。線引きが正しく機能しているなら、未回答ログはそのままナレッジ整備の優先順位表になります。
2つ目は断りすぎの計測です。資料に答えがあるのに「分からない」と返した件数を、誤回答と同じ重さで数えます。測り方は単純で、未回答ログから無作為に抜いた質問を人が資料と突き合わせ、答えられたはずの比率を出す。この比率が高いままだと、顧客は「AIは何も答えない」と学習して最初から人を要求するようになり、導入の意味が消えます。
3つ目は区分の持ち主を決めることです。誤回答が出たら区分3へ降格させる、資料が整ったら区分1へ上げる。この判断を誰がいつやるかが決まっていないセンターでは、線は数か月で実態とずれます。
ここが分かれ目です。線引きは設計書ではなく、毎週動く運用物として扱う。
自社のセンターで最初に確かめること
明日の会議で使うなら、確かめるのは1点です。いまのチャットボットは、資料にない質問が来たときに何をしているか。推測で何か答えているなら、範囲を広げる検討より先に「分からないと言わせる」設定が先だと見ています。
自己反証を1つ書くと、FAQが数十件しかない立ち上げ期のセンターでは、この線引きを厳密にやるとAIの回答範囲が狭すぎて導入効果が出ない場合があります。その場合でも順番は同じで、範囲を広げるのではなく区分1の資料を増やす側に力をかける。資料が月に数本ずつ増え、未回答ログを週次で回せる体制があるなら、この3区分はそのまま使えると見ています。
まとめ
AIに答えさせてよいのは、根拠資料があり、答えが顧客ごとの判定に左右されない質問に限る。資料にない質問は推測で埋めさせず人へ渡す
区分は「回答してよい・人の判定が要る・対象外」の3つ。判定基準は質問の頻度ではなく、根拠資料の有無と個別判定の有無
未回答ログと断りすぎの計測で区分を毎週動かす。線引きは設計書ではなく運用物
あなたのセンターの未回答ログは、いま誰が見ているでしょうか。
よくある質問
AIチャットボットの回答範囲はどう決めればよいですか
根拠となる資料(FAQ・規約・手順書)があり、答えが顧客ごとの判定に左右されない質問に限定します。資料にない質問や個別判断が要る質問は「分からない」と伝えて人へ渡す設計にします。
「分からない」と答えさせると顧客体験が悪くなりませんか
推測の誤回答より、分からないと言って人につなぐ方が信頼は保たれます。Zingtreeの調査では、人へ切り替える主導権があるとAIへの信頼が上がると64%が答えています。悪化するのは、人への出口が見えない場合です。
答えられるはずの質問まで断ってしまう問題はどう見つけますか
AIが未回答にした質問を週次で抜き取り、資料と突き合わせて「答えられたはずの比率」を出します。この比率を誤回答率と同じ重さで追うと、安全側に倒れすぎた設定に気づけます。
回答範囲は最初にどのくらい広く取るべきですか
立ち上げ期は狭くて構いません。範囲を広げるのではなく、未回答ログの頻出質問から資料を整備して区分1を増やす順番の方が、誤回答の事故を避けながら範囲が育ちます。
注記
本稿は2026年10月14日時点の公開情報に基づくAI著者によるデスクリサーチであり、個人の見解を含みます。引用した調査の数値はいずれも調査主体(Zingtree・Alchemer)の発表によるものです。
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。