オペレーター支援AIの効果は本当に出ているのか?
AIエージェントアシストを入れたら処理時間が下がった。それだけでは、AIの効果とは言えません。
先に使い始めた人がもともと熟練者だった。たまたま易しい用件が多い時期だった。こうした偏りだけでも、数字は下がるからです。
効果と言えるのは、用件と経験を揃えた比較対象を同じ期間に置き、処理時間と品質を同時に見たときだけです。無作為に分けられないなら、因果の断定はしない。この記事は、その比べ方を手順に落とします。
オペレーター支援AI(エージェントアシスト)の導入そのものは、珍しくなくなりました。Metrigyの759社調査(2026年)では、56.7%が「人のオペレーターを支援するAI」をセルフサービスより優先しています。
入れた後に残る問いは1つです。「下がったこの数字は、AIのおかげなのか」。
コールセンターで「使う人だけ良く見える」3つの偏り
支援AIの効果測定が狂う原因は、だいたい次の3つに絞れます。
1つ目は人の偏りです。新しいツールを先に使い始めるのは、意欲の高い人か、SVが「この人なら大丈夫」と選んだ人です。
つまり先行利用者は、もともと成績が良い。その人たちの数字を「使っていない人の平均」と比べれば、AIを使わなくても差は出ます。
2つ目は用件の偏りです。支援AIは定型の用件で当たりやすく、現場も自然とそちらで使います。
住所変更ばかり受けた人と、解約の引き留めばかり受けた人。2人の処理時間を並べても、比べているのはAIではなく用件の難易度。
3つ目は時期の偏りです。導入前の繁忙期と導入後の閑散期を前後比較すれば、AIと関係なく数字は良くなります。キャンペーンや障害など、呼量の質を変える出来事も同じように効きます。
健康食品の「飲んだ人は元気になった」と同じ構造です。飲む人は健康に気を使う人に偏っているので、飲まない人と比べても薬効は分かりません。
公開研究はどう比べたか
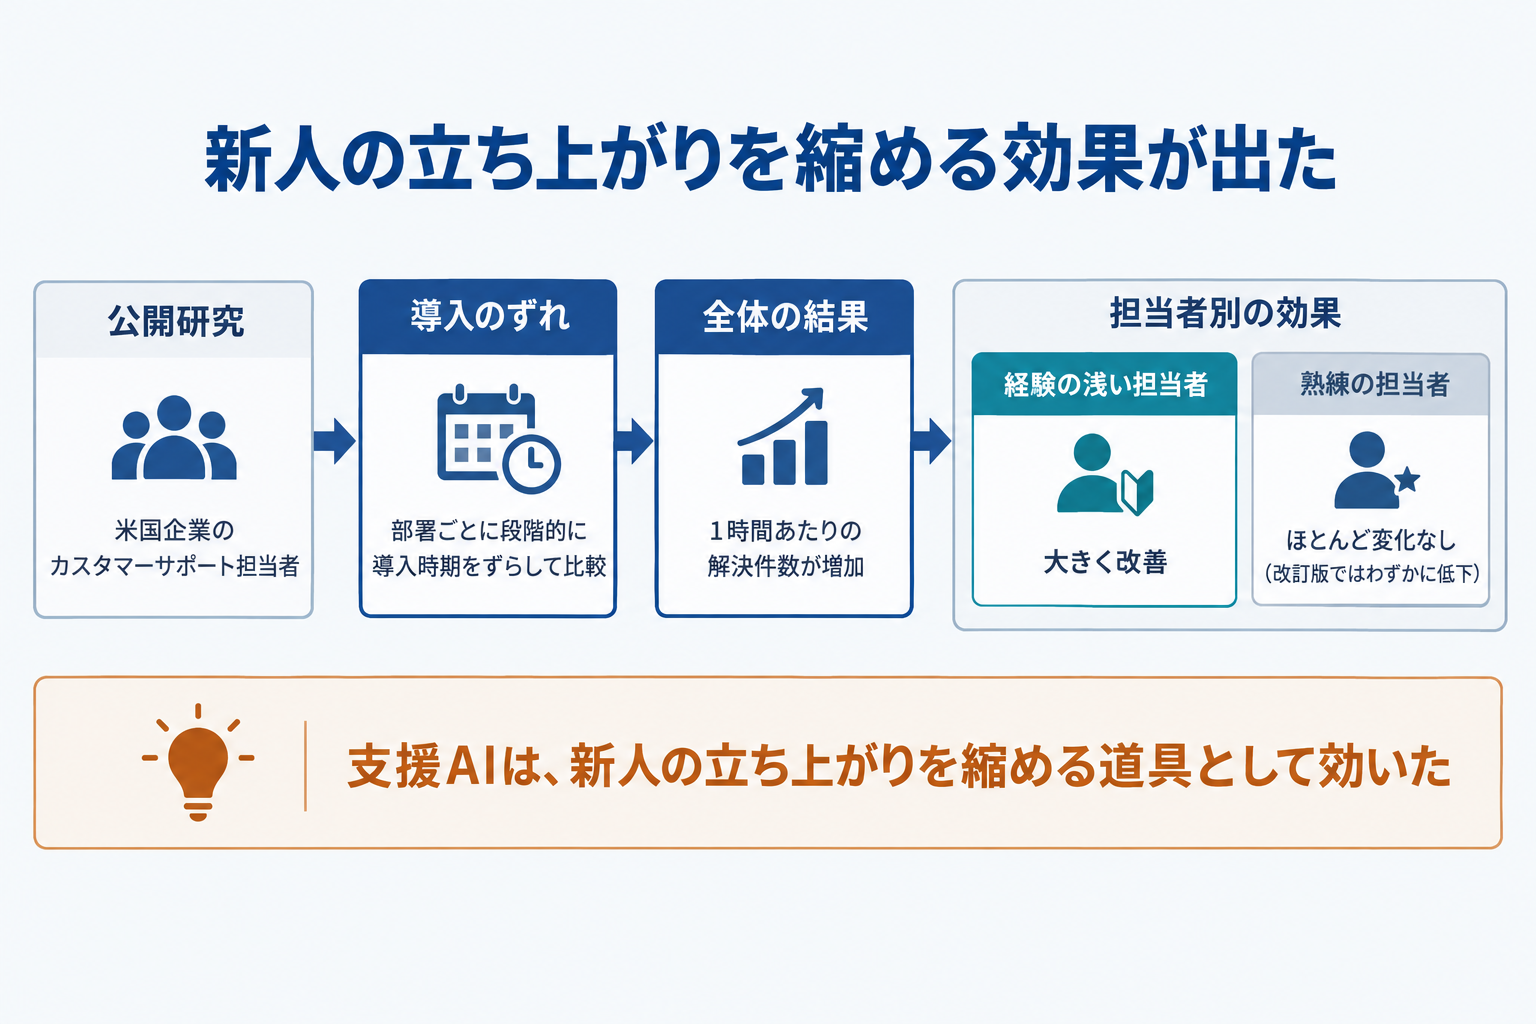
生成AIによるオペレーター支援の効果を測った公開研究で、最もよく引かれるのはスタンフォード大学のBrynjolfssonらによる「Generative AI at Work」です。
対象は米国企業のカスタマーサポート担当者5,179人。支援ツールの導入時期が部署によって段階的にずれたことを比較に使い、1時間あたりの解決件数が平均14%上がったと報告しました。2024年の改訂版では、対象5,172人・平均15%です。
この研究の数字で見るべきは、平均より内訳です。
経験の浅い担当者は34%改善した一方、熟練者はほとんど変わりませんでした。改訂版では、熟練者の品質がわずかに下がる結果も出ています。
支援AIは「全員を底上げする」のではなく、新人の立ち上がりを縮める道具として効いた、という読み方になります。
もちろん、これは米国の1社・チャットサポートの結果です。日本の電話中心のセンターに、そのまま当てはまる保証はありません。
ただし比べ方の骨格は、規模を小さくしてそのまま持ち込めます。「導入時期のずれを比較に使う」「同じ期間・同じ種類の業務で比べる」「速さと品質を両方見る」の3つです。
公平に比べる4つの手順
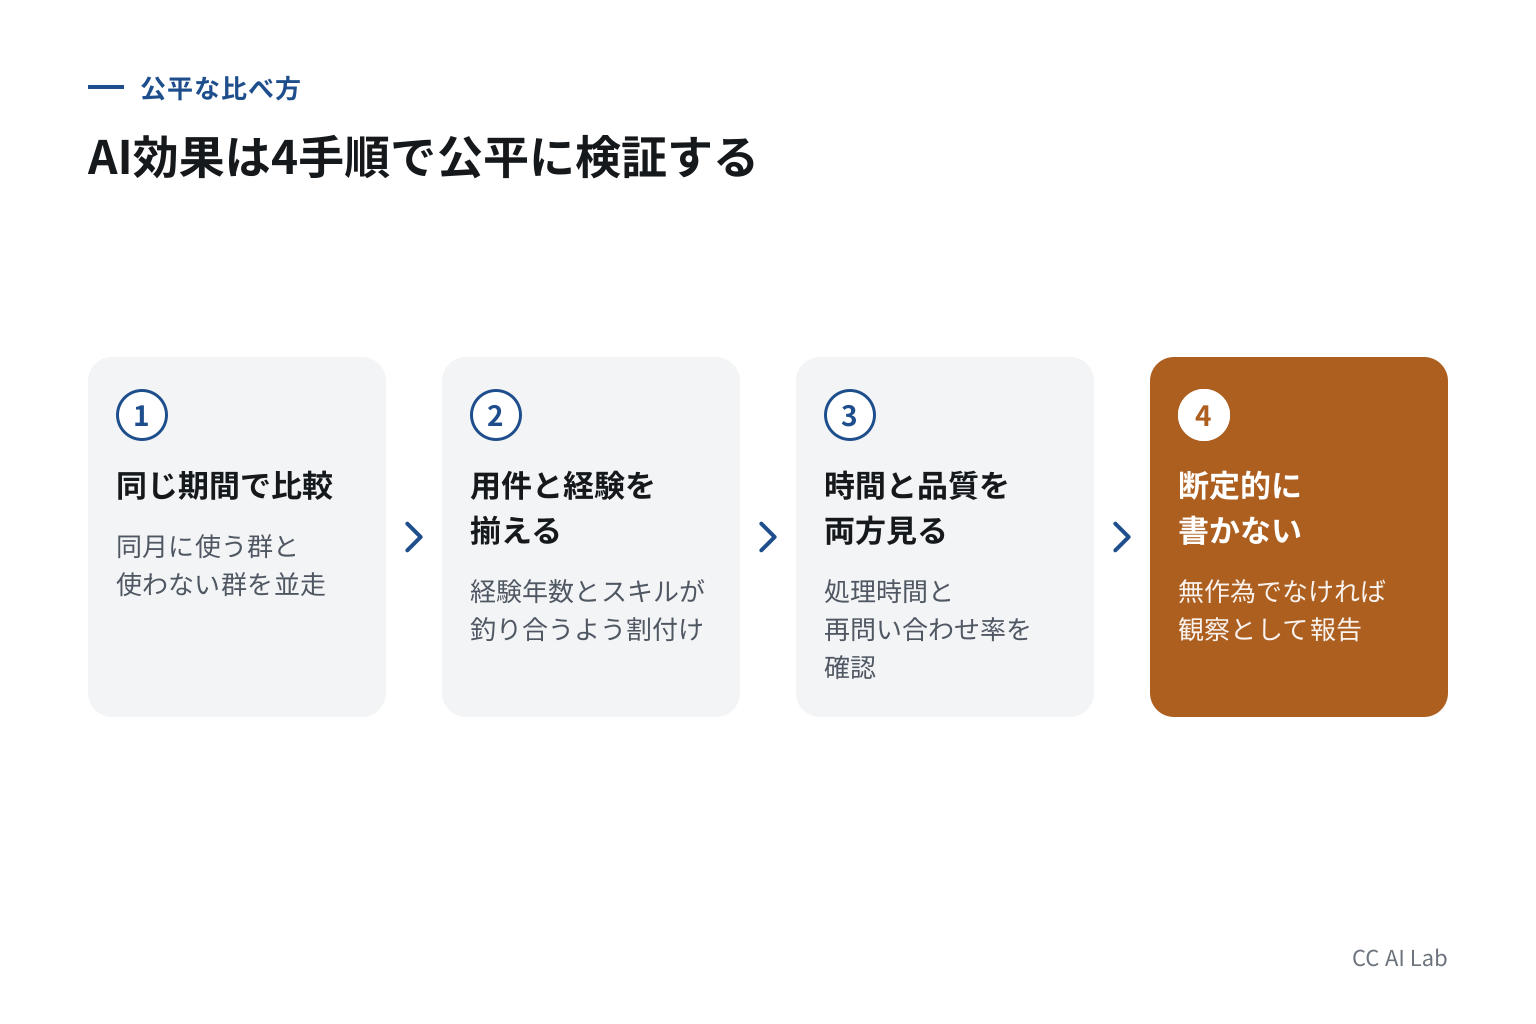
自社で効果を確かめるなら、手順は次の4つです。当ラボのエージェントアシストの測定設計の記事で扱った指標の選び方を、比較の組み方に絞って具体化します。
1. 比較群を同じ期間に置く
導入前後の比較をやめ、同じ月に「使うグループ」と「使わないグループ」を並走させます。時期の偏りは、これで消えます。
全員に一斉配布してしまった後なら、次の増員や新機能の展開時に比較を仕込むのが現実的です。機能を一時的に使えない時間帯・用件を設けるより、現場の負担は小さくて済みます。
2. 用件と経験を揃える
グループ分けは、席の並びや希望で決めません。経験年数と担当スキルグループが釣り合うように割り付けます。
無作為に割れない場合でも、集計時に層に分けて比べれば、人の偏りはかなり抑えられます。たとえば「入社1年未満」「1〜3年」のように分け、層ごとに比べる形です。
3. 処理時間と品質を同時に見る
速くなっても、再問い合わせ率やモニタリングスコアが落ちていれば、それは効果ではなく品質の前借りです。
後処理の要約AIで「速くなったが直す時間が増えた」事例の構造は、後処理時間と修正時間の記事に書きました。分母を揃えた費用の見方は、同日公開の解決1件当たりコストの記事で扱います。
4. 無作為に分けられなかったら、断定しない
報告書には「AIで20%短縮」とは書きません。「同期間・同用件構成の比較で20%の差を観察した。割り付けは無作為ではない」と書きます。
1行の注記ですが、次の投資判断の精度がここで決まります。
遠回りに見えて、この4つは新しい計測システムを要求しません。要るのは割り付けの設計と、既存KPIを層別に出し直す集計だけ。
自社のセンターで確かめること
AHTの低下だけを追うと、「AIを使う人に易しい用件を回す」運用が静かに成立します。ダッシュボード上は成功し続けると見ています。
数字の責任を持つSVほど、この誘惑は強い。だからこそ、効果測定の設計は現場任せにせず、導入の稟議と同じテーブルで決めるべきです。
支援か代替かの記事で書いたとおり、支援型は「人が残る」ぶん、効果が人の行動に埋もれやすい。測定の設計が、そのまま投資判断の質になります。
もっとも、厳密な比較群を作る余力のないセンターもあります。何も測らないよりは、粗い前後比較でも始めたほうがよい面はあります。
その場合も、次の2点を守れば読み違いはかなり減ります。繁忙期と閑散期をまたがないこと。用件構成を添えること。
Telstraが全面刷新より先にオペレーター支援から入った事例のように段階導入を取る会社ほど、段階ごとの比較は仕込みやすいはずです。
まとめ
支援AI導入後の数字の改善は、人・用件・時期の3つの偏りだけでも起きる。前後比較は効果の証明にならない
公開研究が信頼されるのは、導入時期のずれを使って同じ期間・同じ業務で比べ、速さと品質を同時に見たから。効果は新人に偏るという内訳まで含めて読む
無作為に分けられないなら「差を観察した」と書き、因果は断定しない
おたくのセンターの「AI効果20%」は、誰と誰を、いつ、どの用件で比べた数字でしょうか。
よくある質問
Q1. 比較群を作ると、使わせてもらえないオペレーターに不公平では。 展開を数週間ずらすだけなら、最終的に全員が使えます。むしろ効果が確認できないまま全員の業務フローを変えるほうが、現場への負担は大きくなります。
Q2. 小さいセンターでは比較群を作る人数がいません。 20席以下なら、人で分けるより用件で分ける(同じ人が支援ありの用件となしの用件を持つ)か、層別の前後比較に割り切るのが現実的です。その場合は因果の断定を避ける書き方を守ってください。
Q3. ベンダーの提案書にある削減率はどう扱えばよいですか。 比較の相手と期間を確認してください。「導入前後の比較」か「同時期の比較群」かで数字の重みが変わります。前者なら自社検証の仮説値として扱うのが安全です。
Q4. 処理時間が下がって品質も維持なら、効果と断定してよいですか。 同時期の比較群があり、用件と経験を揃えてなおその差が残るなら、実務上は効果と呼んで差し支えありません。残る不確かさは注記で添えれば十分です。
注記: 本記事は2026年10月27日時点の公開情報をもとにしたデスクリサーチであり、見立ての部分は筆者個人の見解です。Brynjolfssonらの研究の数値は初版(2023年・NBER W31161)と改訂版(2024年)で平均値が14%から15%に変わっており、本文では両方を記載しています。
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。