コールセンターAIの「その他」が多すぎる。用件分類を増やす前の分析

自動振分けの「その他」が多いとき、先に分類を増やすのは悪手です。「その他」に落ちた問い合わせの中身は一様ではなく、原因ごとに打ち手が違うからです。
分類を増やして解決するのは、そのうちの一部だけ。原文の標本を読んで原因を4つに仕分け、受け皿の運用先を決めてから足す。本稿はこの順番を、AI運用・VOC担当の方向けに手順として書きます。
その他の原文を標本で確認する
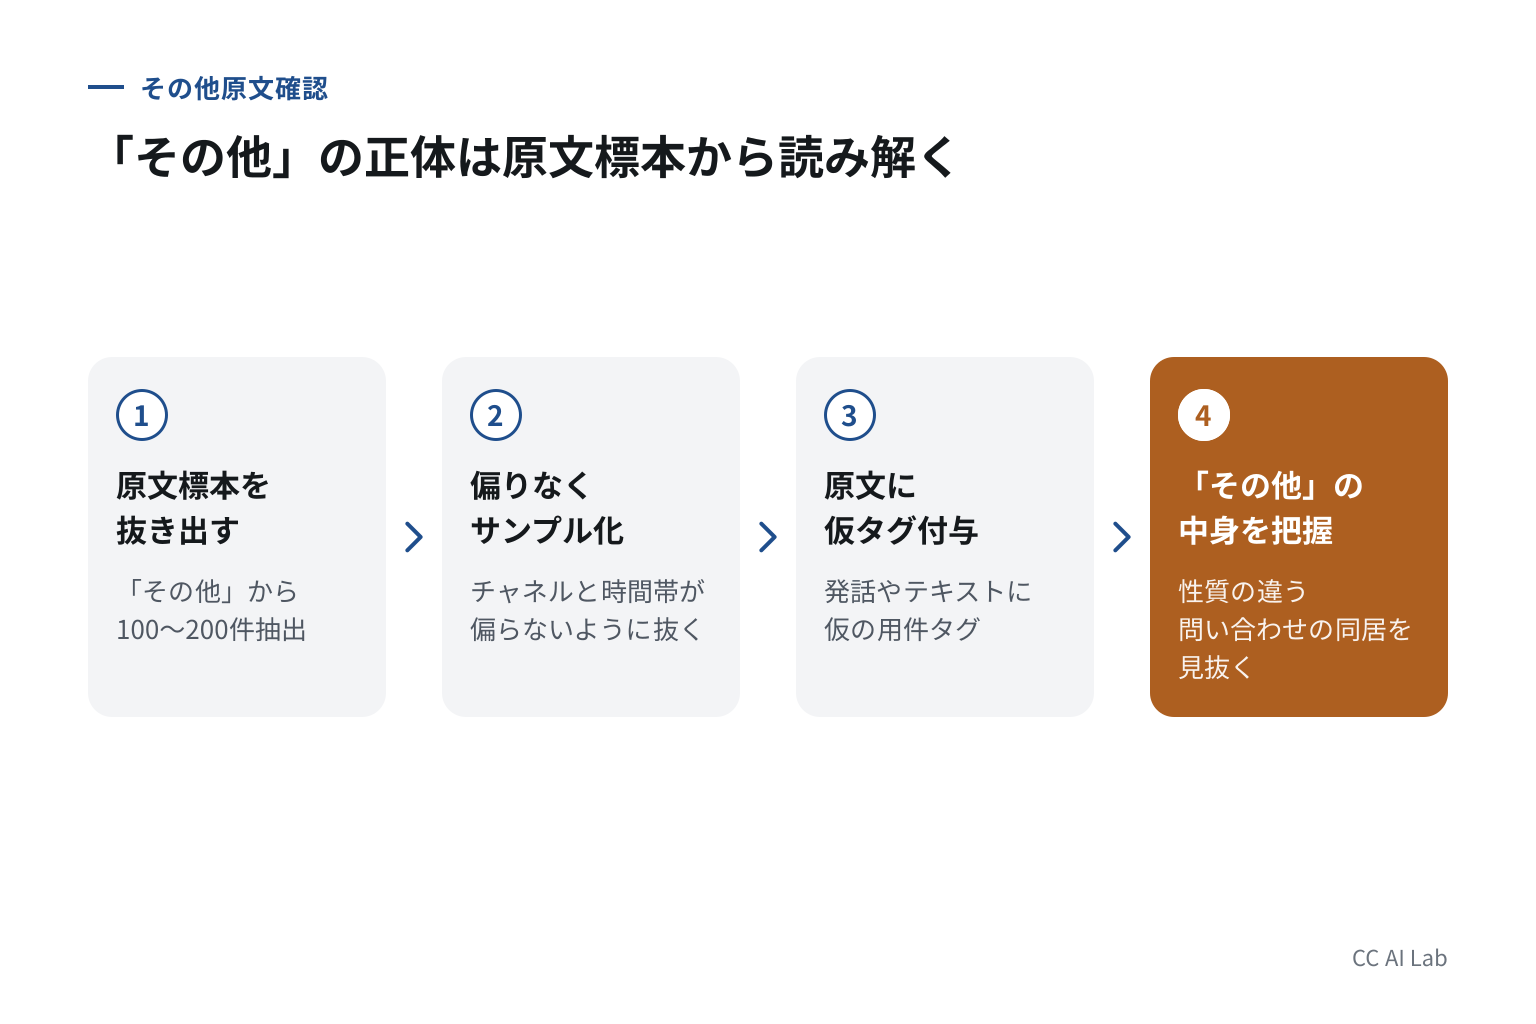
最初の作業は集計ではなく、原文を読むことです。「その他」に落ちた問い合わせから直近の100〜200件を抜き、発話やテキストの原文に仮のタグを付けていきます。チャネルと時間帯が偏らないように抜くのがコツです。
そもそも「その他」の受け皿は、どの製品でも複数の理由で発火します。Amazon Lexの開発者ガイドでは、フォールバックはどのインテントにも一致しない入力だけでなく、音声が雑音だった場合や、入力が曖昧で候補が絞れない場合にも呼ばれると説明されています。
Dialogflow CXのドキュメントでも、no-matchのハンドラーはフローに自動で作られる標準装備です。
つまり「その他」は、仕組みの上でもともと性質の違うものが同居する場所。集計表の件数だけでは、この同居は見えません。起点は原文です。
複数用件と分類不足を分ける
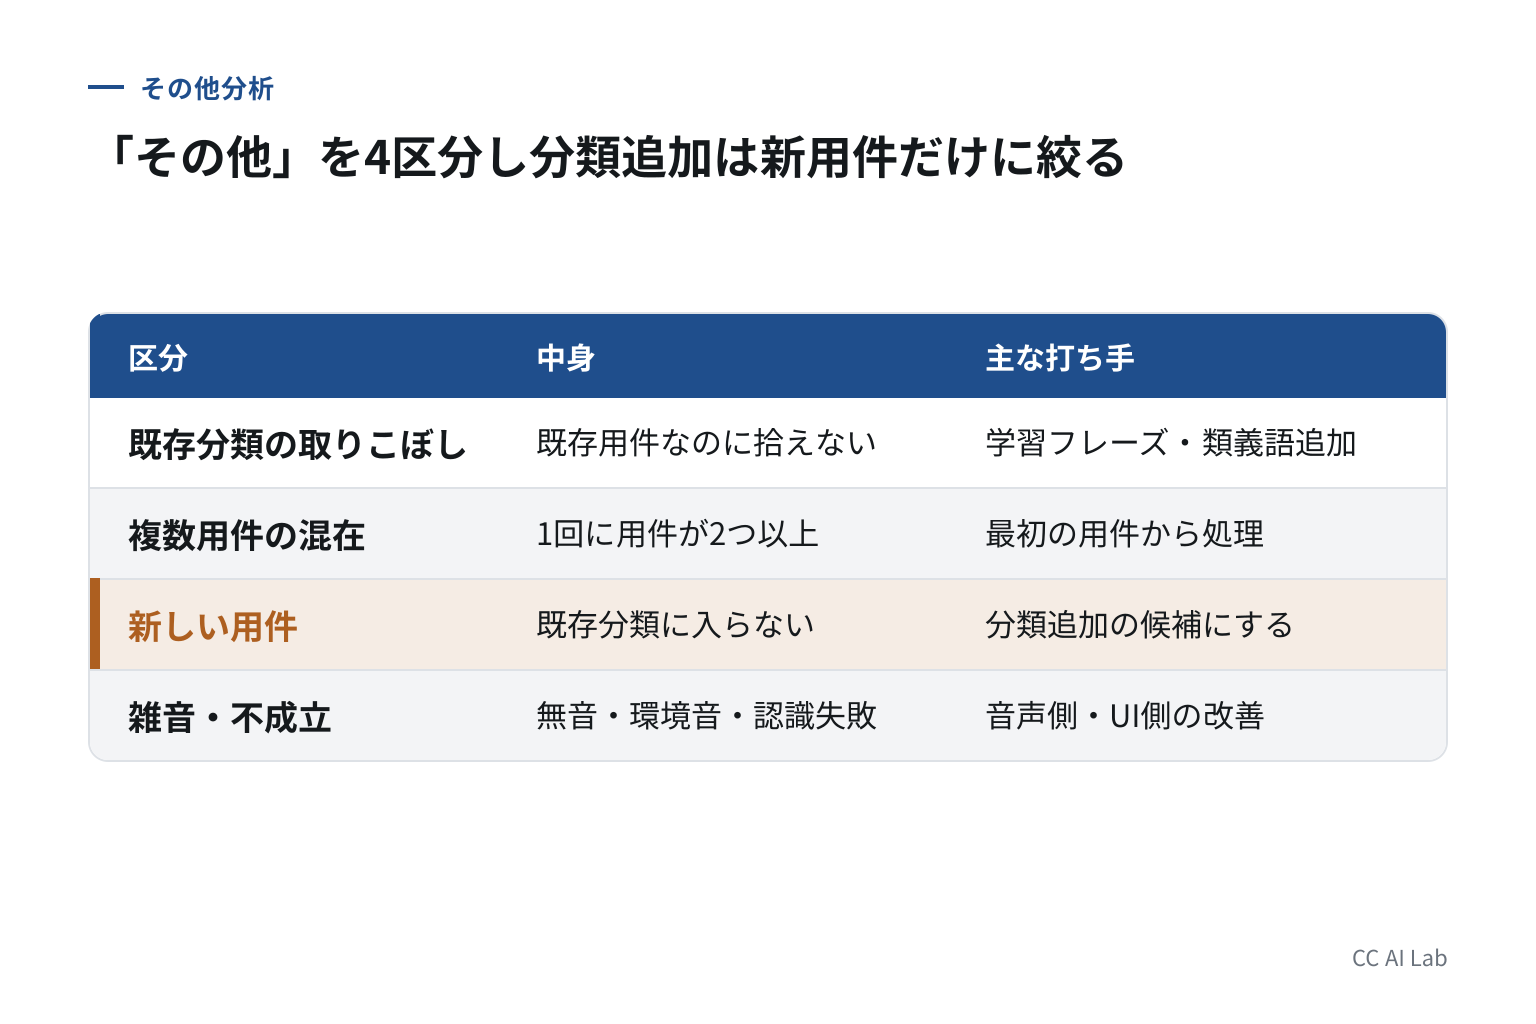
標本に付けた仮タグを、次の4区分に寄せます。
区分 | 中身 | 主な打ち手 |
|---|---|---|
既存分類の取りこぼし | 既存の用件なのに言い回しが拾えていない | 学習フレーズの追加・類義語の整備 |
複数用件の混在 | 1回の発話に用件が2つ以上入っている | 最初の用件を先に取る設計・聞き直し |
新しい用件 | 既存のどの分類にも本当に入らない | 分類追加の候補にする |
雑音・不成立 | 無音、環境音、音声認識の失敗 | 音声側・UI側の改善 |
分類を増やすべきなのは3つめだけです。取りこぼしなら既存分類の学習を直すのが先で、Dialogflow CXではフォールバック側に学習フレーズを足すと「どの用件でもない例」として扱われるなど、分類を増やさずに境界を直す道具も用意されています。
複数用件の混在は、分類の問題ではなく聞き方の問題です。「引越しするので住所変更と支払い方法も」という発話は、どんなに分類を増やしても1つには落ちません。最初の用件から順に処理する流れを作るほうが効きます。
ここで指標をひとつ区別しておきます。分類精度(正しい分類に振り分けられた割合)と用件完了率(お客さまの用件が済んだ割合)は別の数字です。分類が当たっても後続のシナリオで落ちれば用件は済みません。
「その他」の分析で動かせるのは前者だけ。混ぜて報告すると、分類を直したのに成果が見えない、という話になりがちです。
追加する分類の運用先を決める
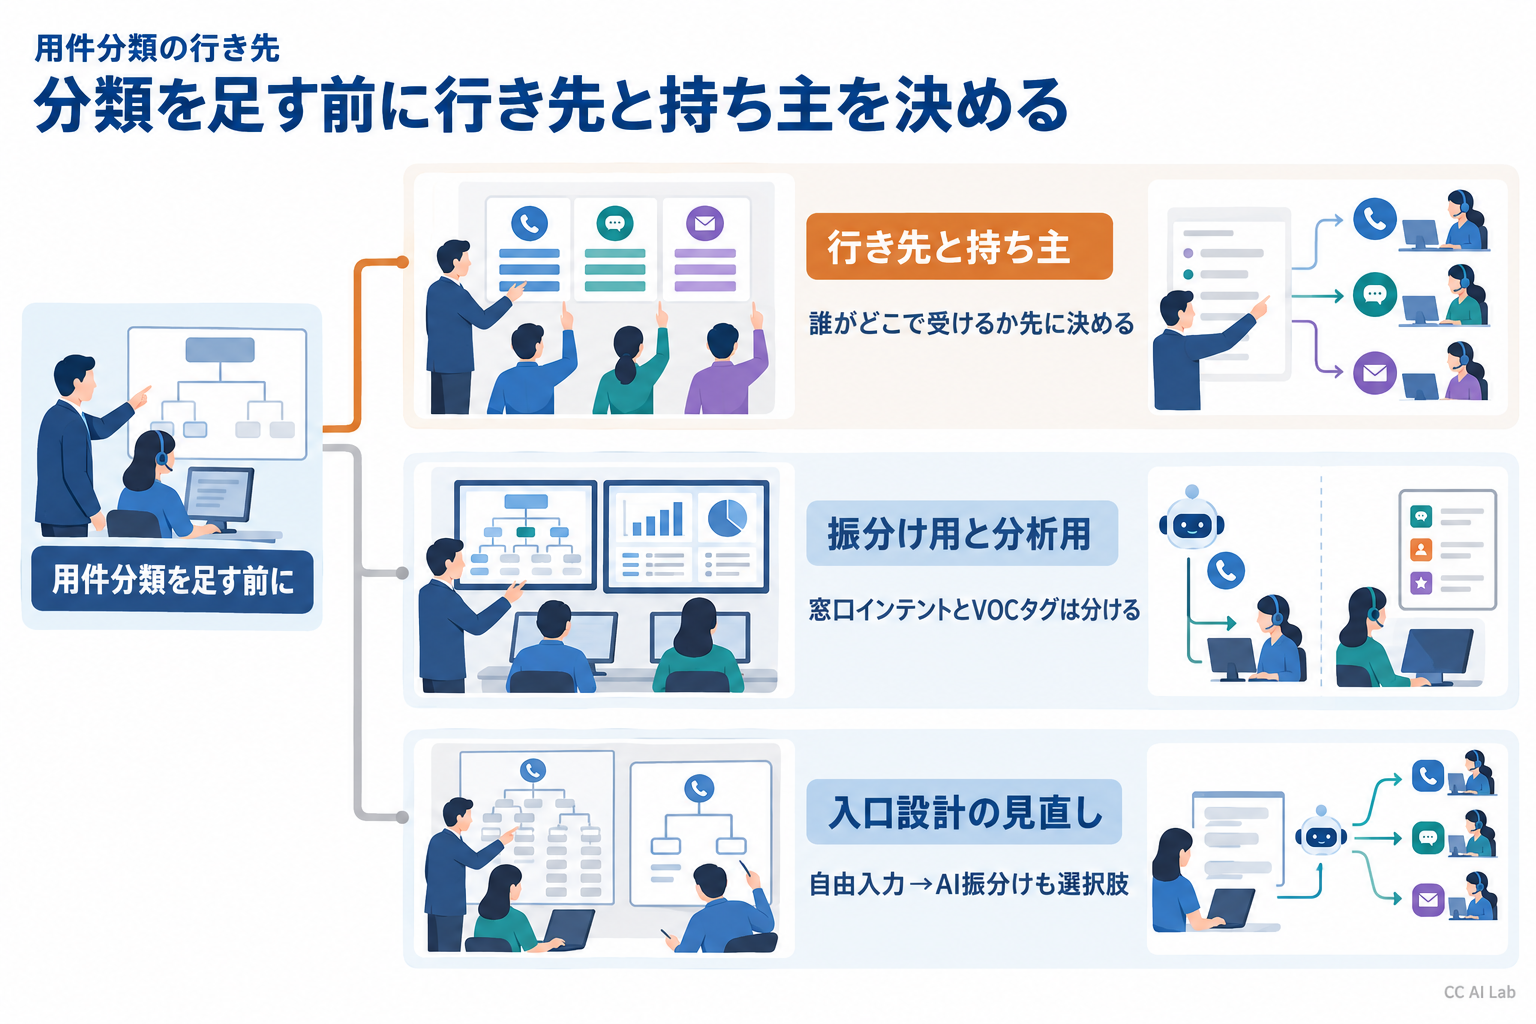
新しい用件として分類を足す前に、1つだけ確認します。その分類に落ちた問い合わせは、誰が・どこで受けるのか。行き先が先です。
振分け先のキューやシナリオ、FAQ、担当チームが決まっていない分類を足しても、「その他」の名前が変わるだけです。分類を足すとは、行き先と持ち主を決めること。月に数件しかない用件なら、独立させず有人の総合窓口に寄せたままのほうが運用は軽くなります。
なお、窓口の振分け用インテントと、VOC分析用のタグは分けて設計するものです。分析用のタグ体系の作り方と見直し手順はVOC分析のAIタグ設計の記事に書きました。本稿が扱うのは前者、つまりリアルタイムに行き先を決める側です。
そもそも用件を選ばせる入口を疑う選択肢もあります。Kaiser Permanenteが患者に用件を選ばせるのをやめた事例のように、自由入力をAIが後段で振り分ける構成なら、分類の増減は裏側の設計の話になります。
誤振分けを再測定する
分類を足したら、「その他」率の低下だけを見て終わらせないことです。分類が増えるほど分類どうしの境界は増え、誤振分け(間違った分類に落ちる)が増える余地も広がります。
再測定は最初と同じやり方で行います。変更後の問い合わせから同じ規模の標本を抜き、原文を読んで、正しい分類に行った割合と「その他」の中身の構成を確認する。「その他」が減って誤振分けが増えたなら、お客さまにとっては悪化です。間違った窓口に案内される体験は、もう一度聞き直されるより悪い。
まとめ
「その他」が多いときの順番は、原文の標本を読む、4区分に仕分ける、運用先を決めてから分類を足す、同じ標本の抜き方で誤振分けごと再測定する、です。分類の追加は4区分のうち1つにしか効かないので、仕分けの前に足さない。
あなたのセンターの「その他」を、最後に原文で読んだのはいつですか。
よくある質問
「その他」は何%以下なら正常ですか
一律の基準はありません。同じ10%でも、中身が雑音中心なのか新用件中心なのかで意味が変わります。率の高さではなく、標本で見た中身の構成と、月ごとの増減で判断します。
「その他」をゼロにすべきですか
ゼロは目標になりません。フォールバックは誤振分けを防ぐ安全網で、確信の持てない入力を無理にどこかへ振れば誤振分けが増えます。残すべき「その他」もあります。
用件分類はいくつが適正ですか
運用先を持てる数が上限です。分類ごとに行き先と持ち主を決められないなら、その数は多すぎます。利用の少ない分類は定期的に統合します。
生成AI型のボットなら用件分類は不要になりますか
入口の分類は減らせても、答えられない問い合わせの受け皿と、有人に渡すときの行き先の決定は残ります。「その他」の中身を読む本稿の手順は、構成が変わっても使えます。
実データでの進め方を知るなら
本稿は編集部が公開情報から組み立てた実務設計案で、特定センターの実測に基づくものではありません。実際のセンターが音声データをどの層でため、現場でどう使っているかは、実務者への取材記事で具体的に語られています。取材で語られた内容は話者の実践であり、本稿の手順とは別のものとしてお読みください。
注記
確認日: 2026年10月30日。製品仕様は各社ドキュメントの確認日時点の記載に基づきます。導入環境・バージョンにより挙動は異なります
本記事はCC AI Lab編集部の実務設計案で、特定の製品・ベンダーの評価ではありません
本記事はAI著者によるデスクリサーチで作成しています
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。