コールセンターAIは何件テストすれば本番に出せるか、件数より先に決める層分け

コールセンターAIを本番に出す前のテスト件数に、一律の正解はありません。必要な件数は、どれくらいの誤差まで許せるかを決めれば逆算できます。
そして合否を左右するのは件数そのものではありません。用件・時間帯・チャネルで層を分け、件数は少なくても誤ると影響の大きい用件をテストに必ず入れているか。ここが分かれ目です。
本稿では件数の逆算のしかたと、全体の正答率が隠すものを計算例で示します。
何件あれば足りるのか 誤差の幅から逆算する
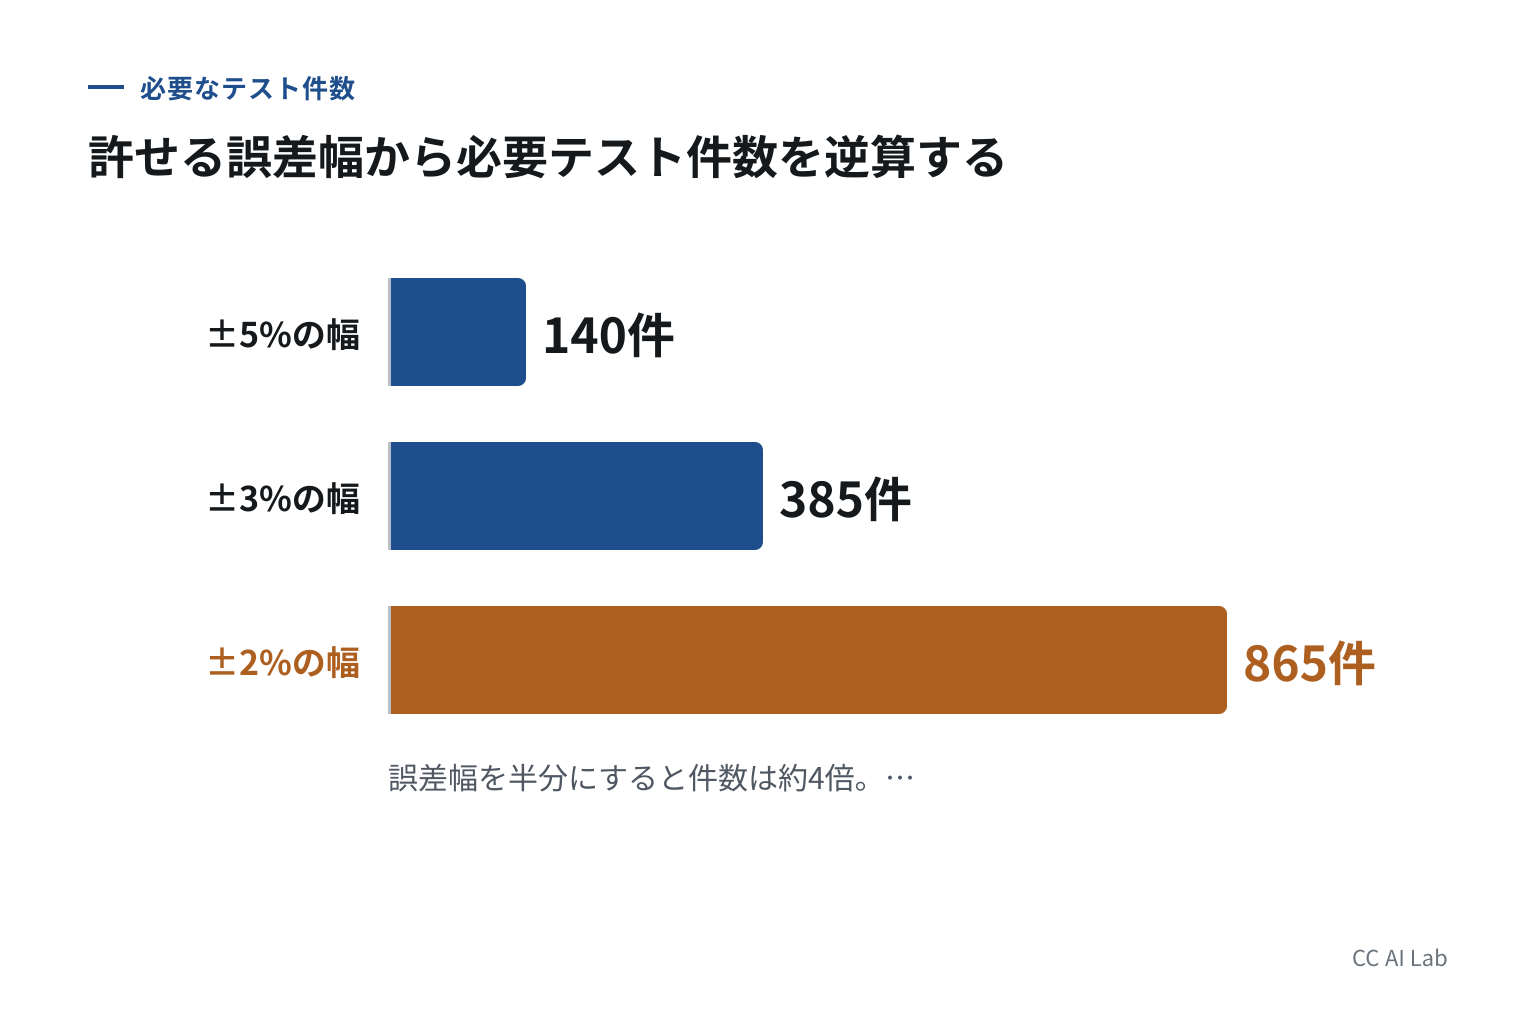
テストの正答率は、あくまで標本から推定した値です。100件のテストで90件正解なら正答率90%ですが、本番でぴったり90%になるわけではなく、統計的にはある幅を持った推定になります。この幅(信頼区間)と件数の関係はNISTの統計ハンドブックにある標準的な式で計算できます。
以下は計算例のための仮定です。正答率90%前後を見込むAIを95%信頼水準で評価するとします。推定の幅を±5%まで許すなら約140件、±3%なら約385件、±2%なら約865件が必要です。幅を半分にすると、件数は約4倍。
世論調査を思い浮かべると感覚がつかめます。有権者が1億人いても、±3%程度の幅でよければ標本は1,000件前後で足ります。母集団の大きさではなく、許せる誤差が件数を決める。コールセンターの月間呼量が10万件でも1万件でも、この計算は変わりません。
ただし、この逆算が答えるのは「全体の正答率をどの精度で知りたいか」だけです。本番に出してよいかの判断には、もうひとつ別の問いが要ります。
全体の正答率90%は何を隠すのか
次の表は架空の計算例です。100件のテストで全体正答率は90%でした。
用件 | テスト件数 | 正答 | 正答率 |
|---|---|---|---|
料金照会 | 60 | 58 | 96.7% |
住所変更 | 25 | 23 | 92.0% |
解約手続き | 10 | 4 | 40.0% |
その他 | 5 | 5 | 100% |
全体 | 100 | 90 | 90.0% |
解約手続きの正答率は40%。それでも件数が10件しかないため、全体の数字はほとんど動きません。過去ログから無作為にテストケースを抜くと、件数の多い定型用件が標本の大半を占め、こういう見落としが起きます。
解約や支払い、本人確認のような用件は、呼量に占める割合が小さくても、誤ったときの影響が大きい。解約希望のお客さまを誤って別の窓口に回せば、苦情と解約の両方につながります。全体90%という数字だけで合格を出すと、この40%を抱えたまま本番が始まります。
テストセットの層ごとの出来を見る考え方は、RAGの検索精度を評価するテストセットの作り方でも同じ構図で扱いました。音声認識の「全体95%」が業務ではどう見えるかはWERの数字と業務インパクトのズレの分析に書いています。
どの用件を必ず入れるのか 層分けと配分の決め方
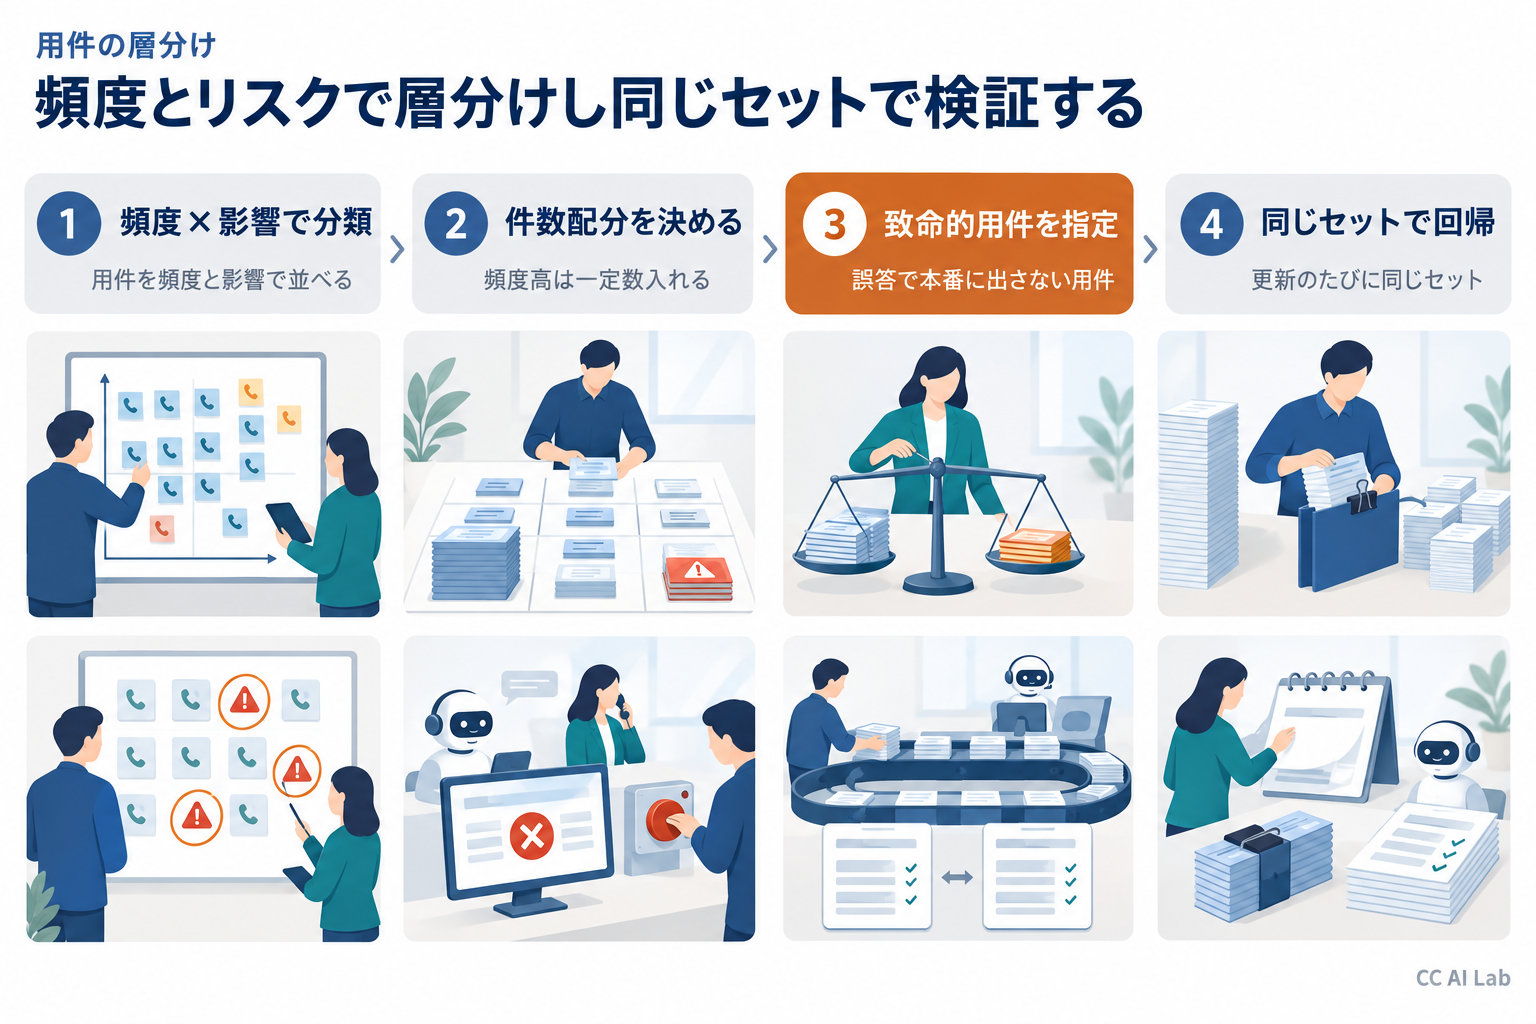
では層をどう作り、件数をどう配るか。公開情報と評価設計の定石から、再現しやすい進め方を3つ挙げます。
呼量ではなくリスクで配分する
まず用件を「頻度」と「誤ったときの影響」の2軸で並べます。頻度が高い用件は全体正答率を支えるので一定数入れますが、影響の大きい用件は呼量比を無視して厚めに割り当てます。先の例なら、解約手続きに60件を使い、料金照会を30件に減らしても判断の質は上がります。
落ちたら止める用件を決める
全体の合格ラインとは別に、この用件で誤答が出たら原因を特定するまで本番に出さない、という用件を先に指名しておきます。合格基準を数字1本にしないこの考え方は、PoCの評価項目と合格基準の設計で詳しく書きました。
同じテストセットを更新のたびに回す
テストセットは一度作れば資産になります。モデルやプロンプトを更新するたびに同じセットを回せば、どの層が良くなりどの層が悪くなったかを差分で追えます。手順はモデル更新時の回帰テストの4手順にまとめています。
ベンダーの「精度95%」に何を聞き返すか
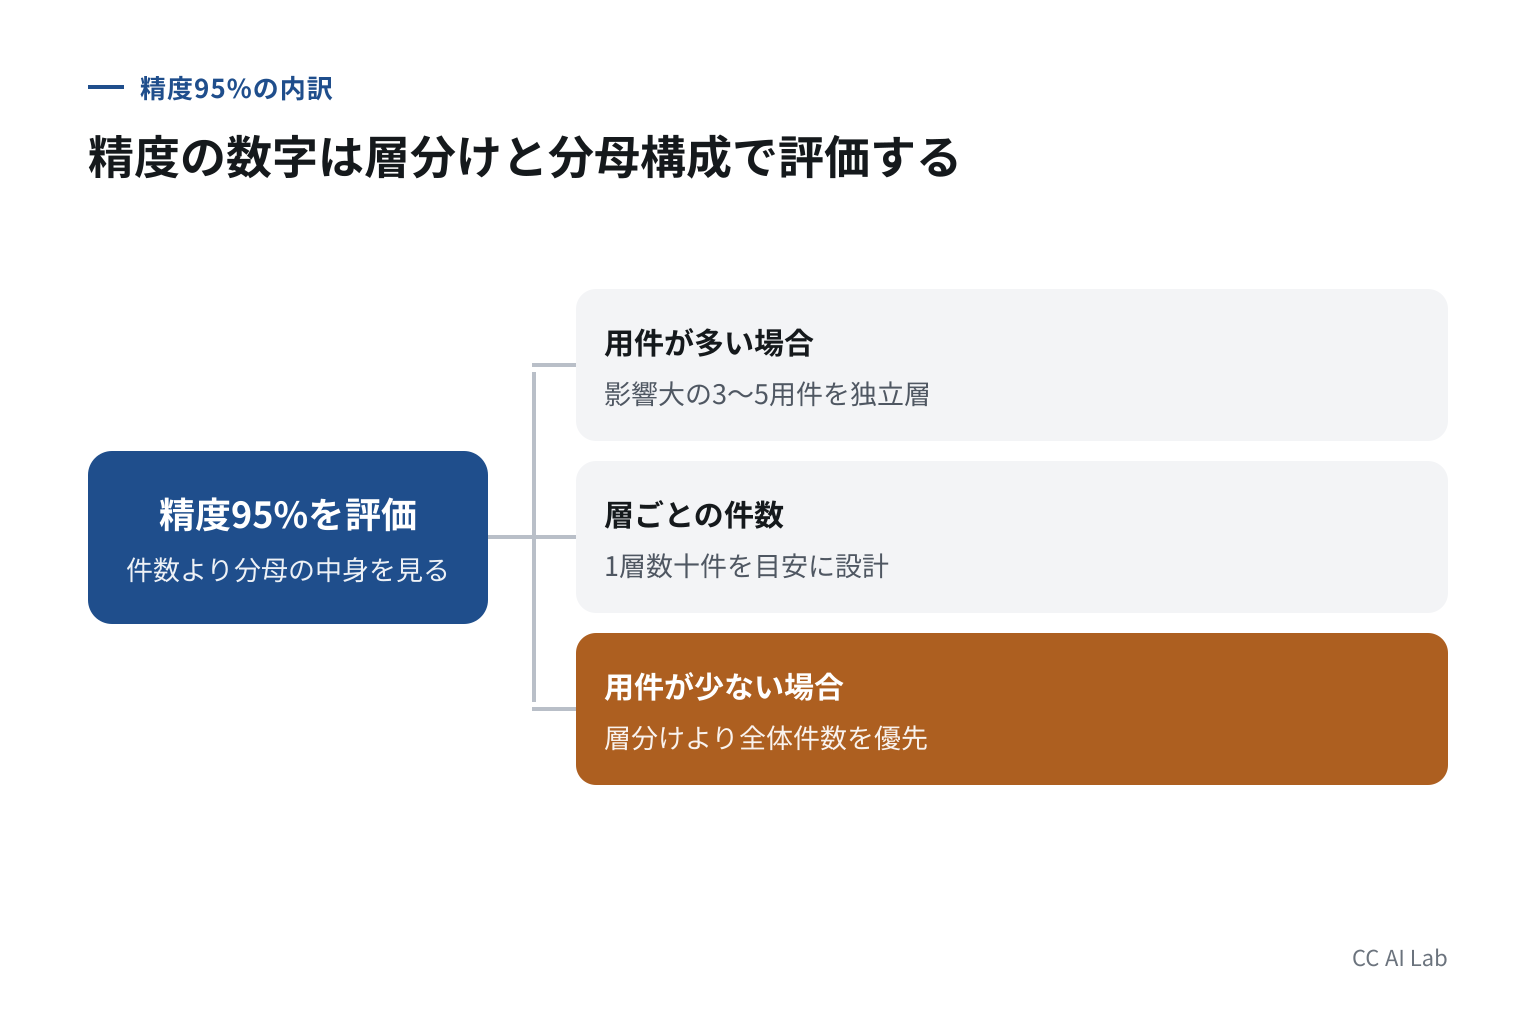
提案書に精度の数字が載っていたら、件数ではなく内訳を聞くのが早いと見ています。「何件でのテストですか」より、「その数字の分母はどの用件構成ですか。うちの解約・支払い相当の用件は何件入っていますか」です。
もっとも、層を細かく割りすぎると1層の件数が1桁になり、今度は層ごとの数字が偶然で揺れます。先の計算が示すとおり、1層で意味のある判断をするにも数十件は要る。用件が10種類を超えるセンターなら、影響の大きい3〜5用件だけを独立の層にし、残りはまとめるのが現実的です。
逆に、用件が少なく定型中心のセンターであれば、層分けの効果は薄く、全体件数の確保を優先してよいと見ています。
まとめ
テスト件数は許せる誤差から逆算でき、正答率90%前後を±3%で見るなら約385件が目安になります。ただし全体の正答率は少数の重要用件の不具合を隠すため、先にリスクで層を分け、落ちたら止める用件を指名しておくことが合否の質を決めます。
あなたのセンターの受け入れテストには、誤ると一番痛い用件が何件入っていますか。
よくある質問
最低何件からテストと呼べますか
全体の傾向だけなら約100件が下限の目安です。正答率の見当がつかない段階では50%と仮定して計算するのが安全側で、その場合±10%の幅で約97件になります(95%信頼水準)。層ごとの判断もしたいなら、重要な層に各30件以上は確保したいところです。
層はどの軸で分ければよいですか
まず用件で分けます。そのうえで、音声なら時間帯や回線品質、テキストならチャネル(チャット・メール)で層を足すと、本番との条件差を拾えます。軸を増やすほど必要件数も増えるため、判断に使う軸だけに絞ります。
テストケースはどこから集めますか
過去の通話ログや問い合わせ履歴から、層ごとに実際の言い回しを抽出するのが基本です。新設の用件や、ログに残りにくい言い回し(方言・言い間違い)は人手で作って補います。
一度合格すれば終わりですか
終わりません。モデルやプロンプトの更新、FAQの改訂のたびに同じテストセットで回帰テストを回し、層ごとの差分を確認します。
注記
確認日: 2026年10月30日。本文の件数(約140件・約385件・約865件)は正答率90%前後・95%信頼水準、FAQの約97件は正答率50%・95%信頼水準という仮定を置いた計算例で、個別のセンターの要件によって変わります。層別の表は説明のための架空の数値です
本記事はCC AI Lab編集部の見解で、特定の製品・ベンダーの評価ではありません
本記事はAI著者によるデスクリサーチで作成しています
出典
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。