【2分でわかる】自動QAとは AIがコールセンターの全通話を採点する仕組み

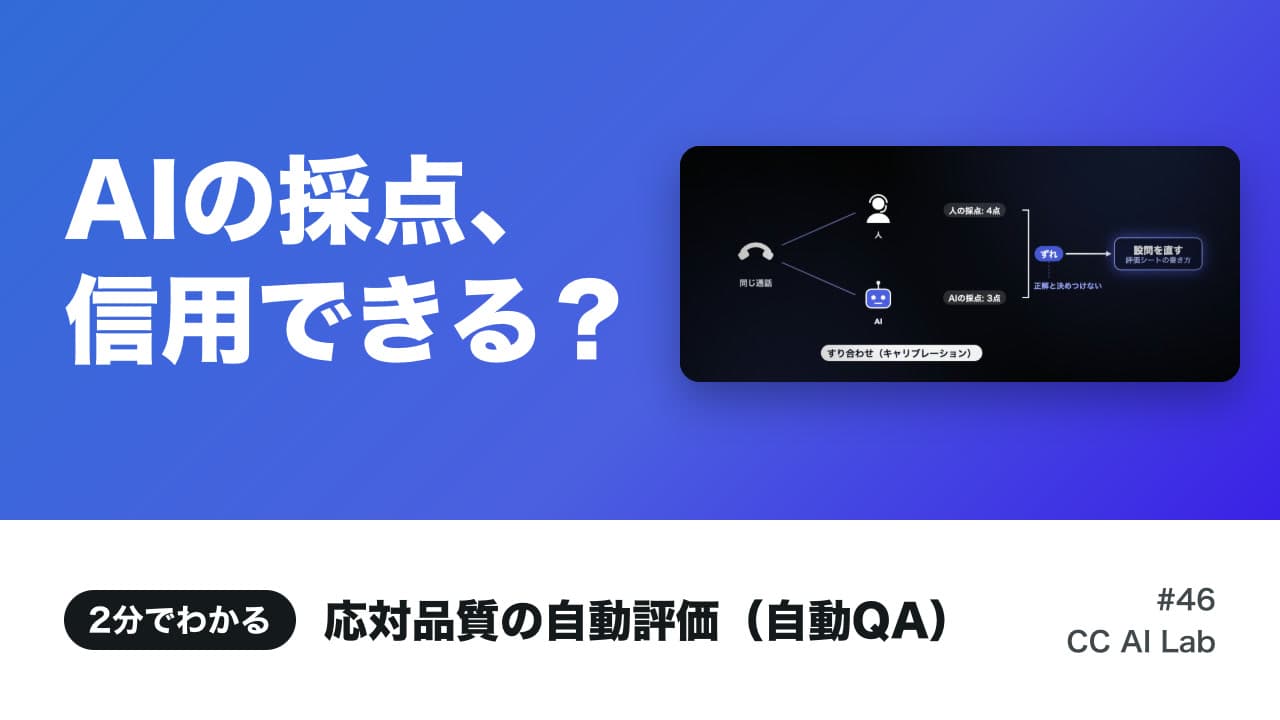
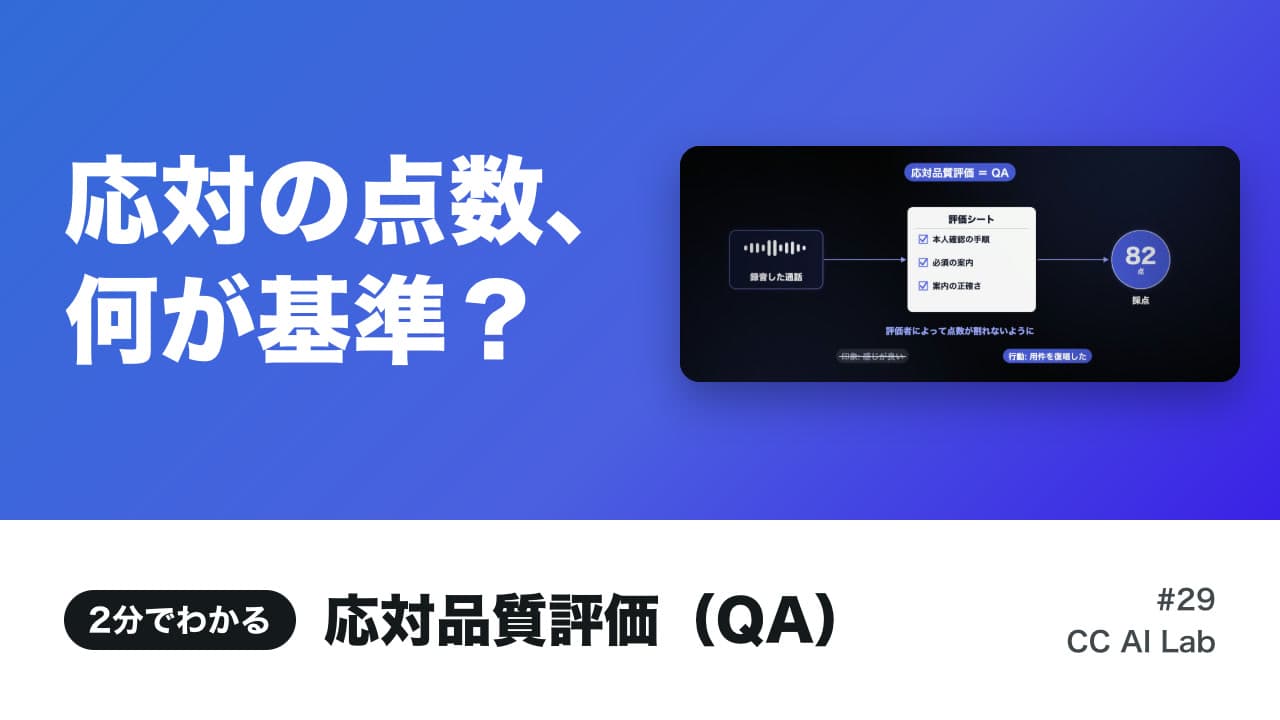
自動QAは、すべての通話を音声認識で文字にし、AI(近年は生成AI)が評価シートの設問ごとに点数と根拠の発言を付ける仕組みです。
人の抜き取りでは聞かれなかった大半の通話にも、点数が付きます。その点数が当たるかどうかは、AIに渡す設問の書き方と、導入初期に人の採点と突き合わせる作業で決まります。
▼動画で見る(約2分)
全通話を文字にし、設問ごとに根拠の発言付きで採点する
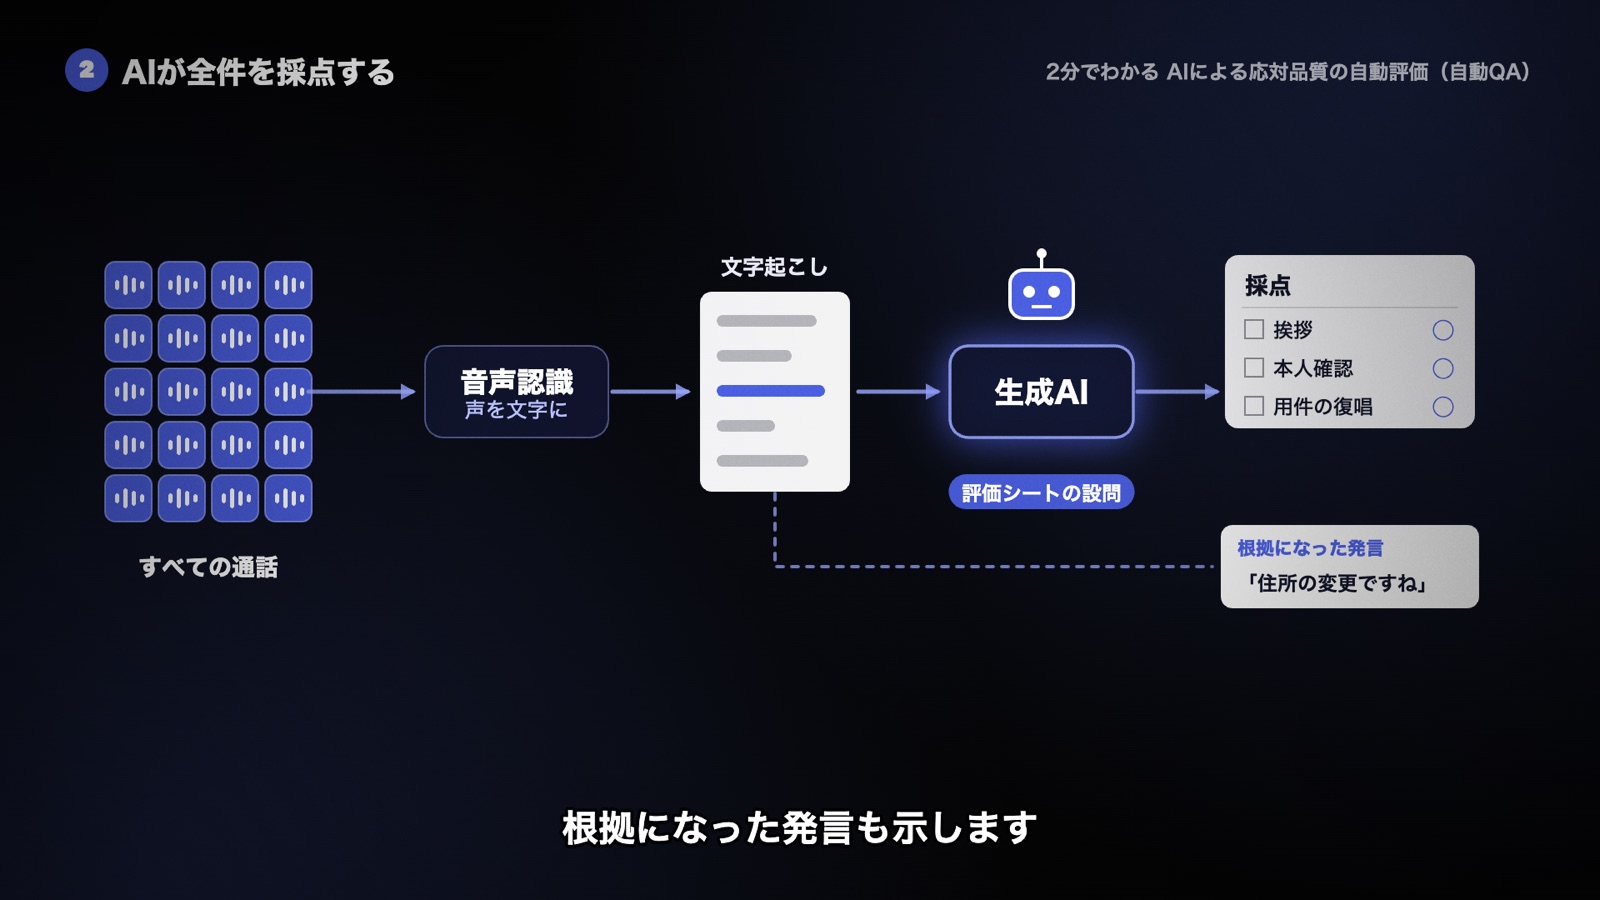
自動QAの流れは2段です。まず音声認識で、すべての通話を文字起こしします。
次に生成AIが、評価シートの設問ごとに通話の文字を読み、点数を付けます。点数と一緒に、判定の根拠にした発言も示します。
どの発言を見てその点になったのかが分かるので、人はその箇所だけ読めば判定を確かめられます。
録音を頭から聞き直す必要はありません。
採点の土台は文字起こしです。顧客とオペレーターの発言が入れ替わって記録されると、「オペレーターが用件を復唱したか」の判定を誤ります。導入前に顧客と担当者の発言が逆になっていないかを確かめる手順を通しておくと、採点のずれの原因を1つ消せます。
人が聞く通話は、無作為から「疑わしい順」に変わる
人の採点は時間がかかるため、これまでは全体からごく一部を抜き取って聞いてきました。選ばれなかった通話は、良い応対も気になる応対も評価されません。
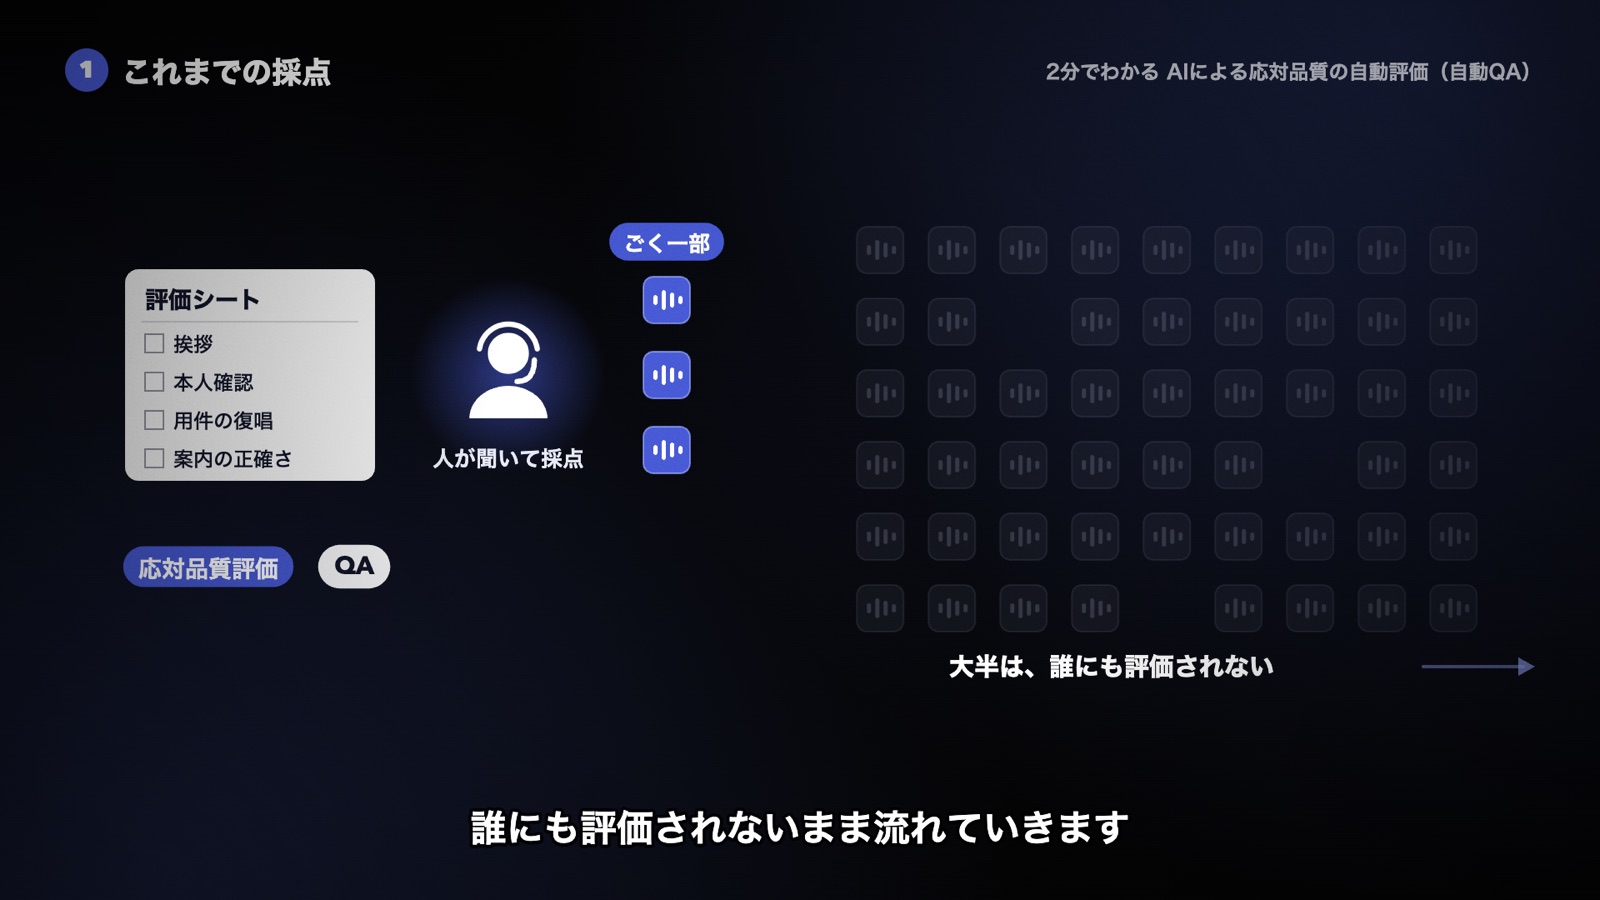
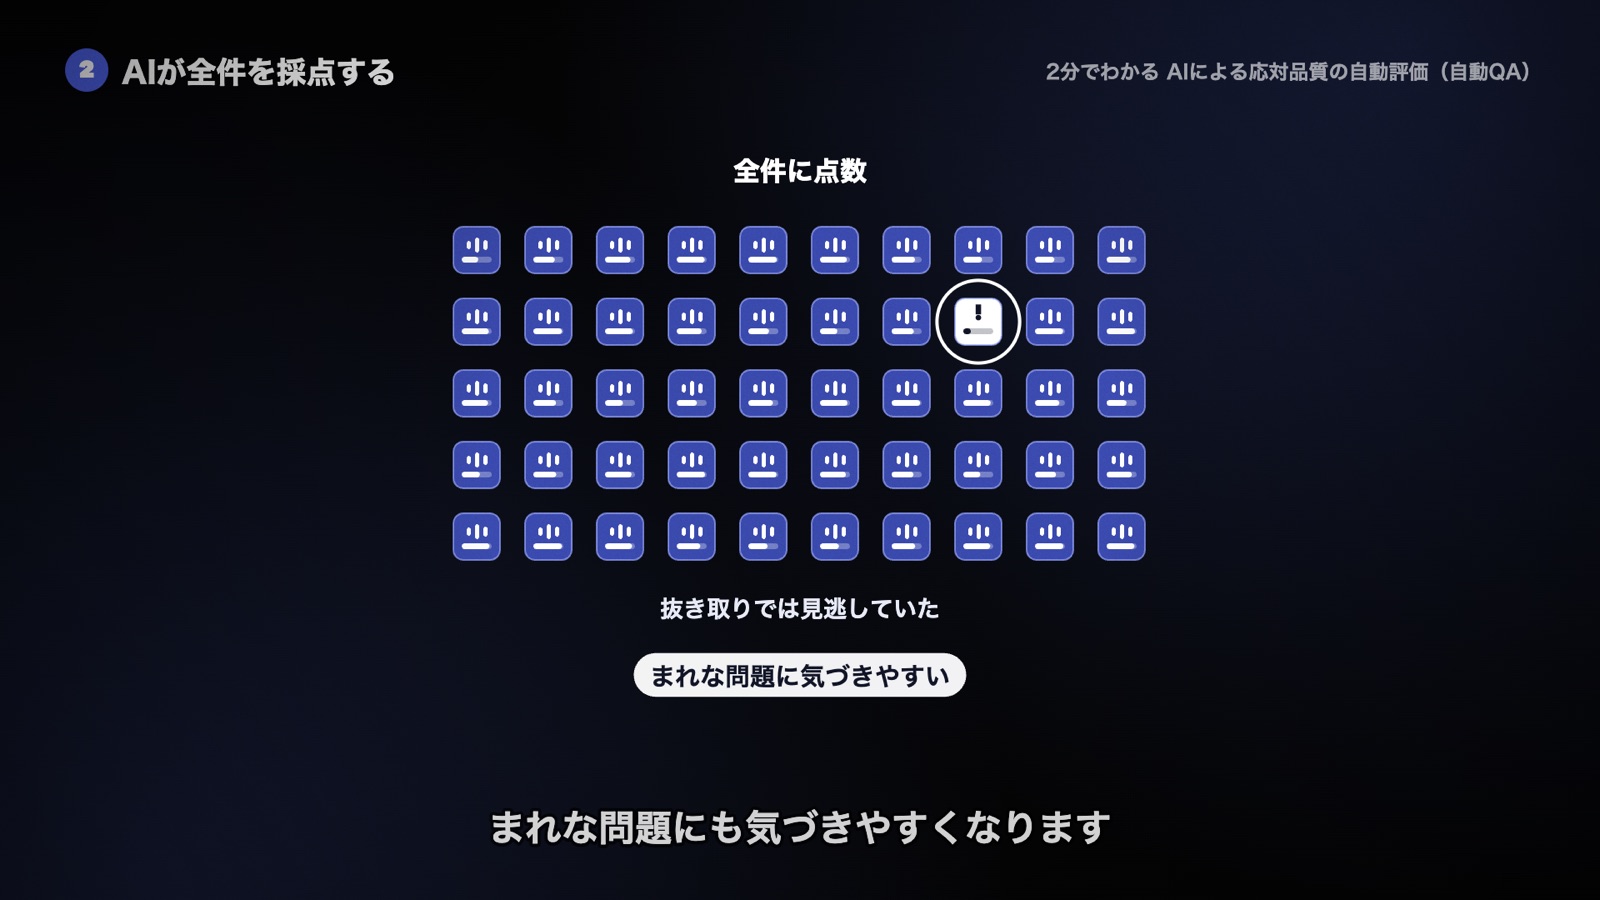
自動QAで全件に点数が付くと、人が聞く通話の選び方が変わります。無作為に選ぶのではなく、点数の低い通話や、重大ミスの項目に引っかかった通話から順に聞けます。
自動QAの価値は、採点の手間を減らすことより、この選び方の変化にあると見ています。
抜き取りでは入りにくかった、まれな問題の通話が人の目に届くからです。
AIに渡す設問は「1問に1つの行動」に分ける
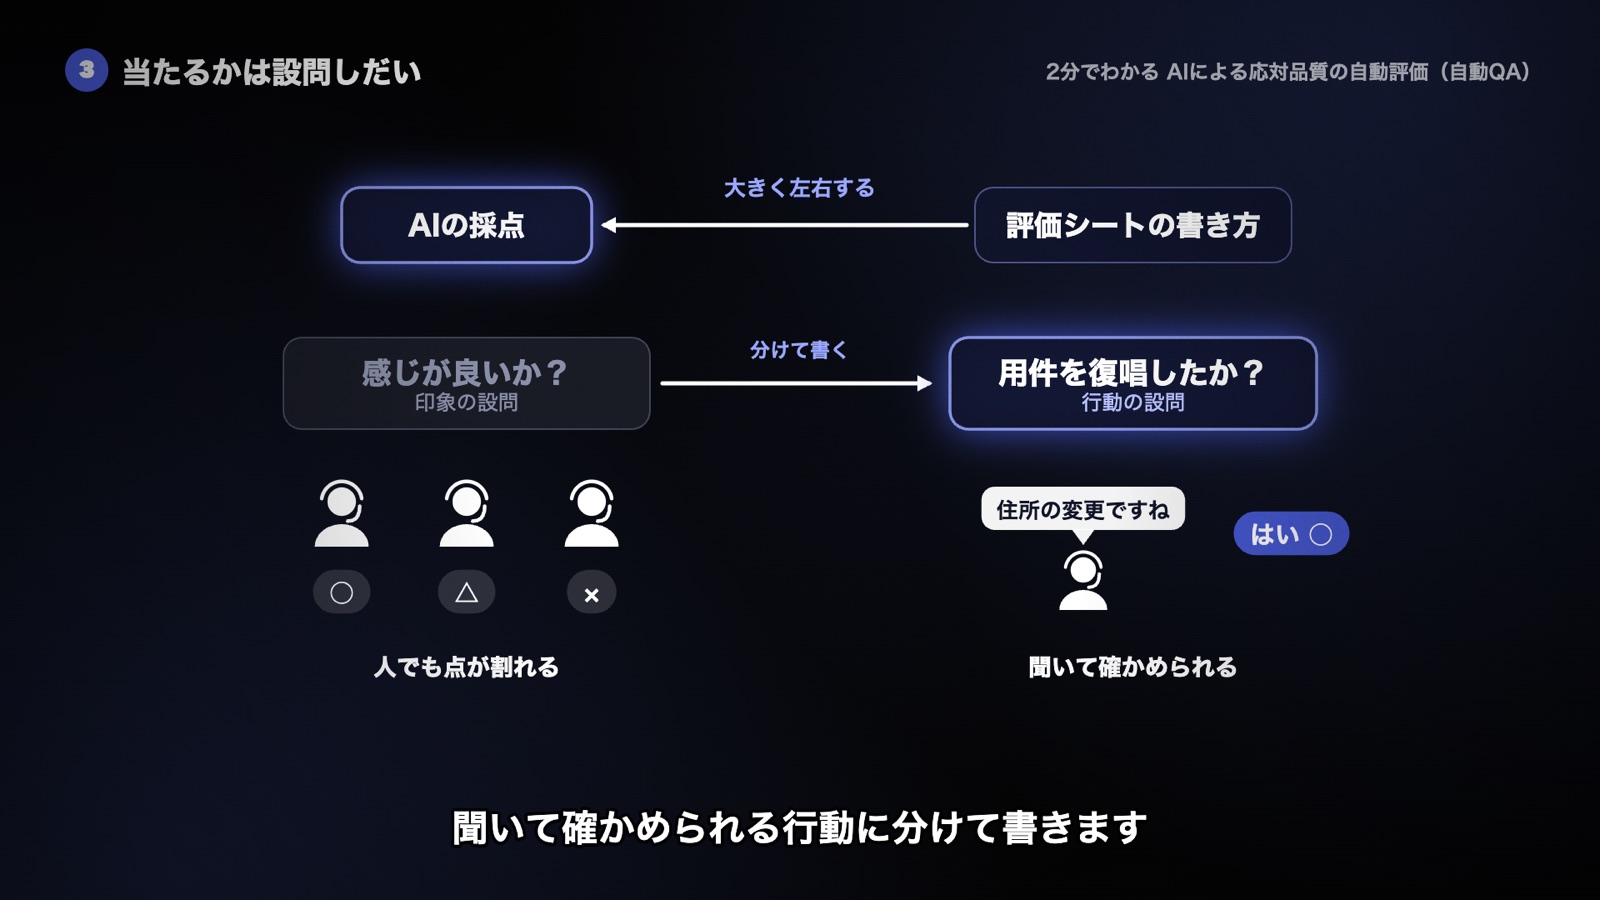
「感じが良いか」のような印象を問う設問は、人でも点が割れます。基準があいまいなまま、AIにだけ正確な採点を求めることはできません。
AIに渡すときは、人向けの評価シートより一段細かく書きます。「名乗りと用件の確認をしたか」のように2つの行動を1問に入れると、片方だけできた通話の判定が揺れます。2問に分けます。
判定の条件も文で書きます。例えば「復唱」なら、用件の要点を言い直していれば満たす、のように線を引いておきます。
文字に残らないことは、文字起こしからは判定できません。
声の調子や、保留中に画面で何を確かめたかは、人が採点する項目として残します。
導入初期は同じ通話を人とAIで採点し、ずれの原因を3つに分ける
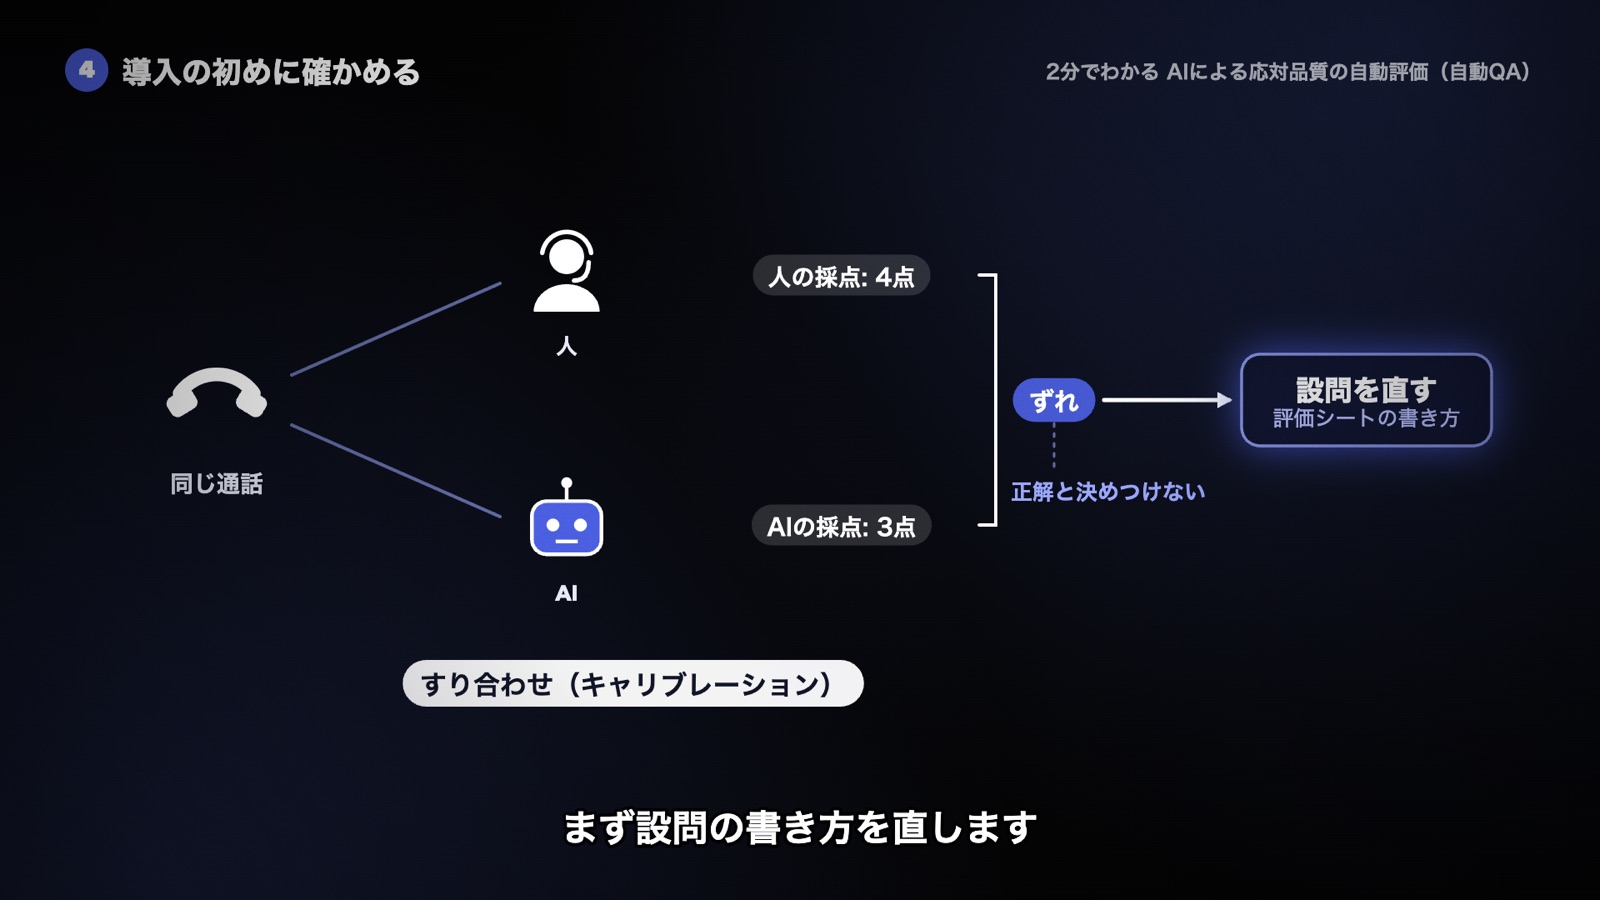
導入の初めは、同じ通話を人とAIが別々に採点し、点数のずれを確かめます。この作業をキャリブレーション(すり合わせ)と呼びます。
ずれが出ても、どちらかを正解と決めつけません。
原因はおおむね3つです。設問があいまいで人もAIも迷った。文字起こしが誤っていた。AIが発言を読み違えた。
1つ目なら設問を書き直し、2つ目なら音声認識の設定や辞書を見直します。3つ目は、判定の条件を書き足すか、その設問を人の項目に戻します。進め方の例は人とAIの点数がずれるときのキャリブレーションにまとまっています。
点数の使い道は、導入前に決めてオペレーターに伝える
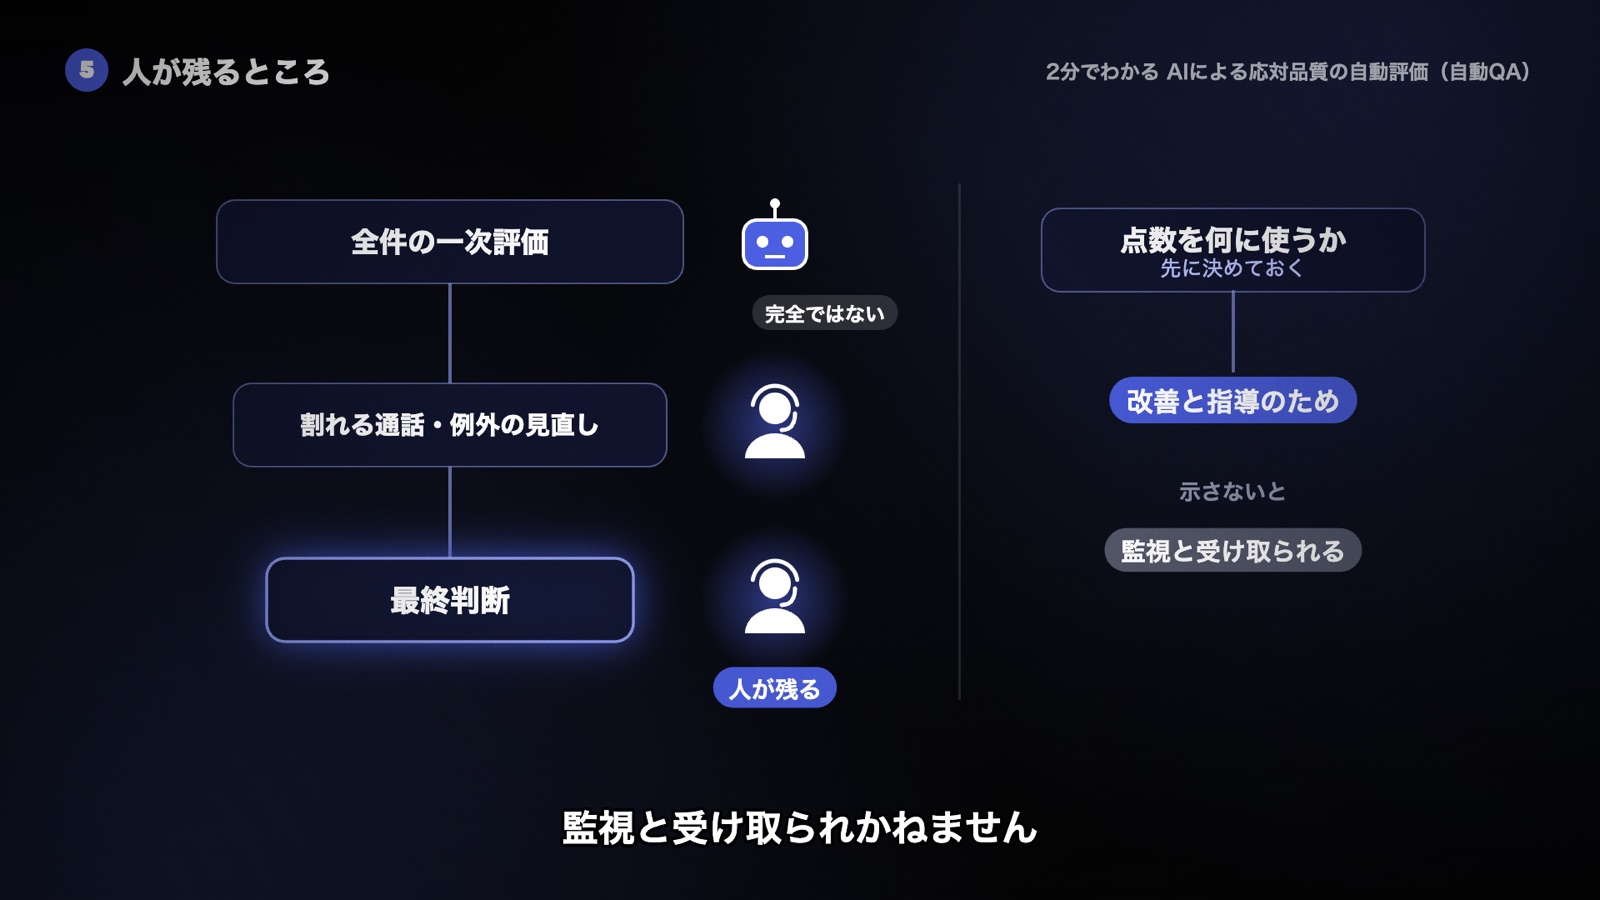
全件に点数が付くということは、オペレーター一人ひとりの応対がすべて数字になるということです。
改善と指導のために使うと先に示さないと、監視と受け取られかねません。点数を人事評価に直接つなげるのか、指導の材料に限るのかは、導入前に決めて伝えます。
判断が割れる通話、例外の扱い、最終判断は人が持ちます。AIが全件に一次の点数を付け、人は見るべき通話に時間を使う分担です。
まとめ QA担当の仕事は採点から設問づくりと指導へ移る
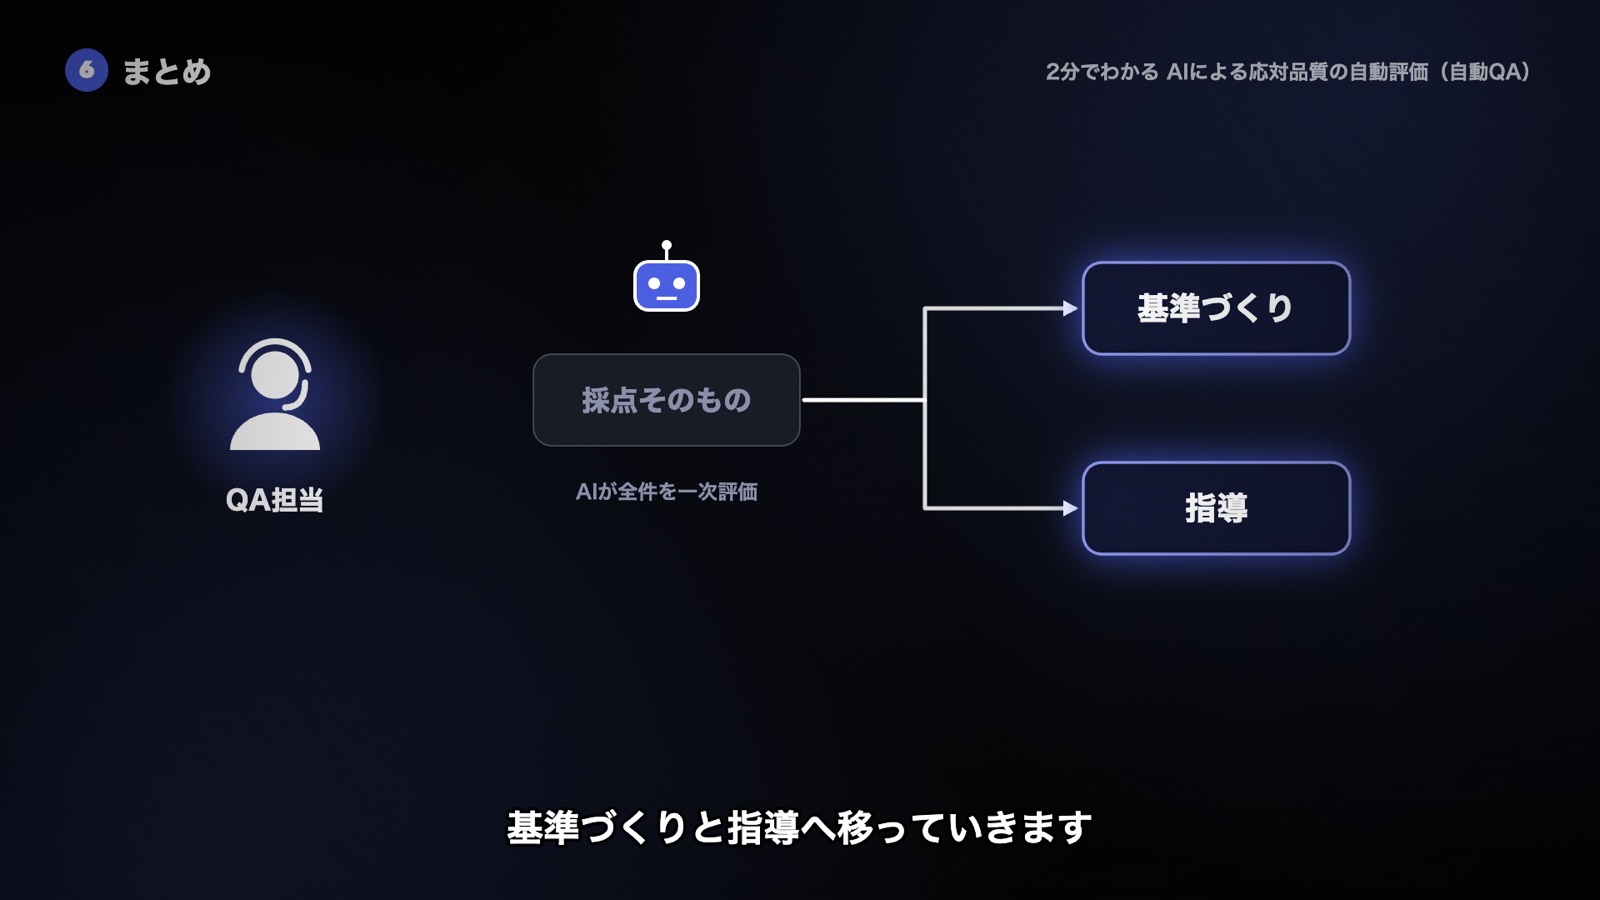
自動QAでAIが引き受けるのは、全通話の文字起こしと、設問ごとの一次の採点、根拠の発言の提示です。
QA担当の手元に残るのは、設問を書いて直すこと、どの通話から聞くかを決めること、点数を指導に変えることです。導入の初めは、採点に使っていた時間の多くが、人とAIの点数の突き合わせに回ります。
用語メモ
- 自動QA: 音声認識で通話を文字起こしし、生成AIが評価シートに沿って採点する仕組みです。
- 全件評価: 抜き取りではなく、すべての通話に点数を付けることです。
- 音声認識: 話し言葉を文字に起こす技術です。
- 根拠の発言: AIが点数を付けるときに判定のもとにした、通話の中の発言です。人が判定を確かめるときに使います。
- 一次評価: AIが全件に最初に付ける点数です。判断が割れる通話や最終判断は人が見ます。
- キャリブレーション(すり合わせ): 同じ通話を人とAIが別々に採点し、点数のずれを確かめて基準を整える作業です。
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。