【2分でわかる】コールセンターの応対品質評価(QA)はどう採点されるか

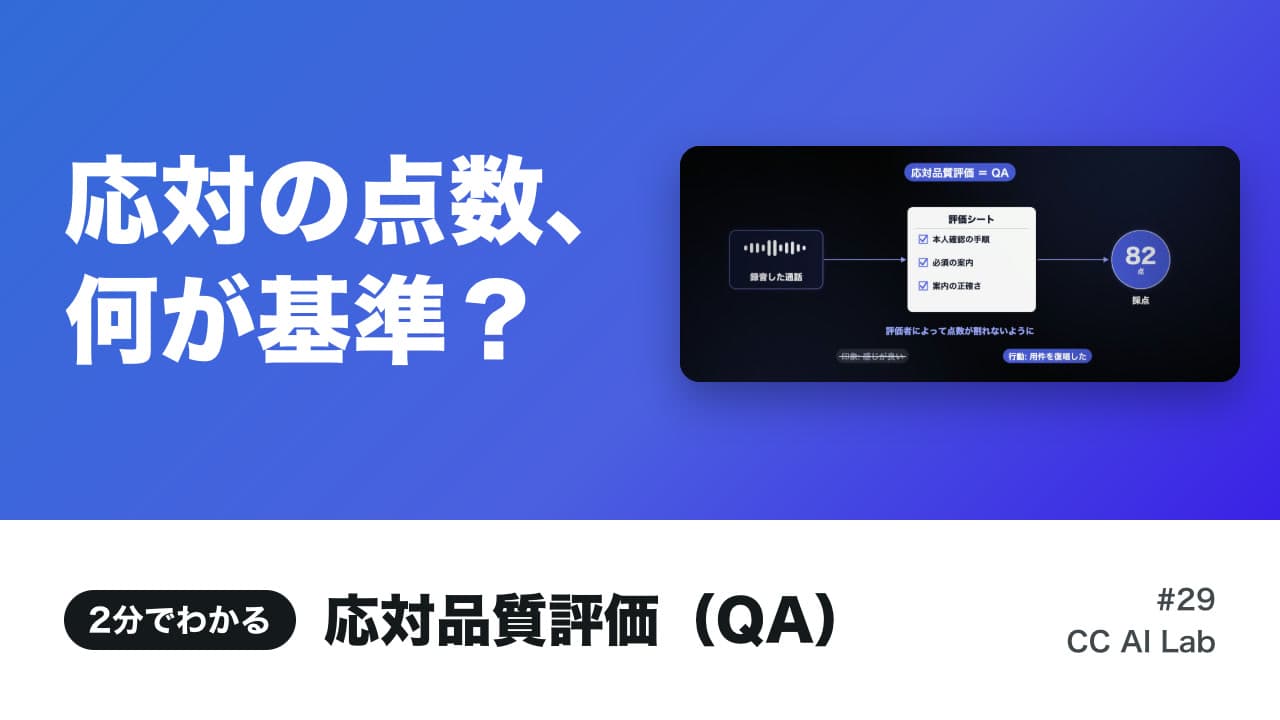
応対品質評価(QA)の点数は、評価者が録音を聞き、評価シートの項目ごとに丸を付けて決まります。
その点数をどこまで信用できるかは、3つで変わります。
項目を行動で書けているか。何件を抜き取って聞いているか。評価者同士の基準がそろっているか。
▼動画で見る(約2分)
評価シートの項目は「確かめられる行動」で書く
QAは、オペレーターの応対を決まった基準で採点し、品質を確かめる仕組みです。評価者は録音した通話を聞き、評価シートに沿って項目ごとに点を付けます。
評価シートには、本人確認の手順、必ず伝える案内、案内の正確さといった項目が並びます。
点数がそろうかどうかは、項目の書き方で決まります。「感じが良い」「丁寧だった」のような印象の項目は、同じ通話でも評価者によって点が割れます。
そこで「用件を復唱したか」「解約時の注意事項を伝えたか」のように、聞けば有無を確かめられる行動で書きます。
何を聞けば丸が付くかがはっきりしているほど、採点はそろいます。
月1,000件から4件を聞くなら、評価されるのは0.4%
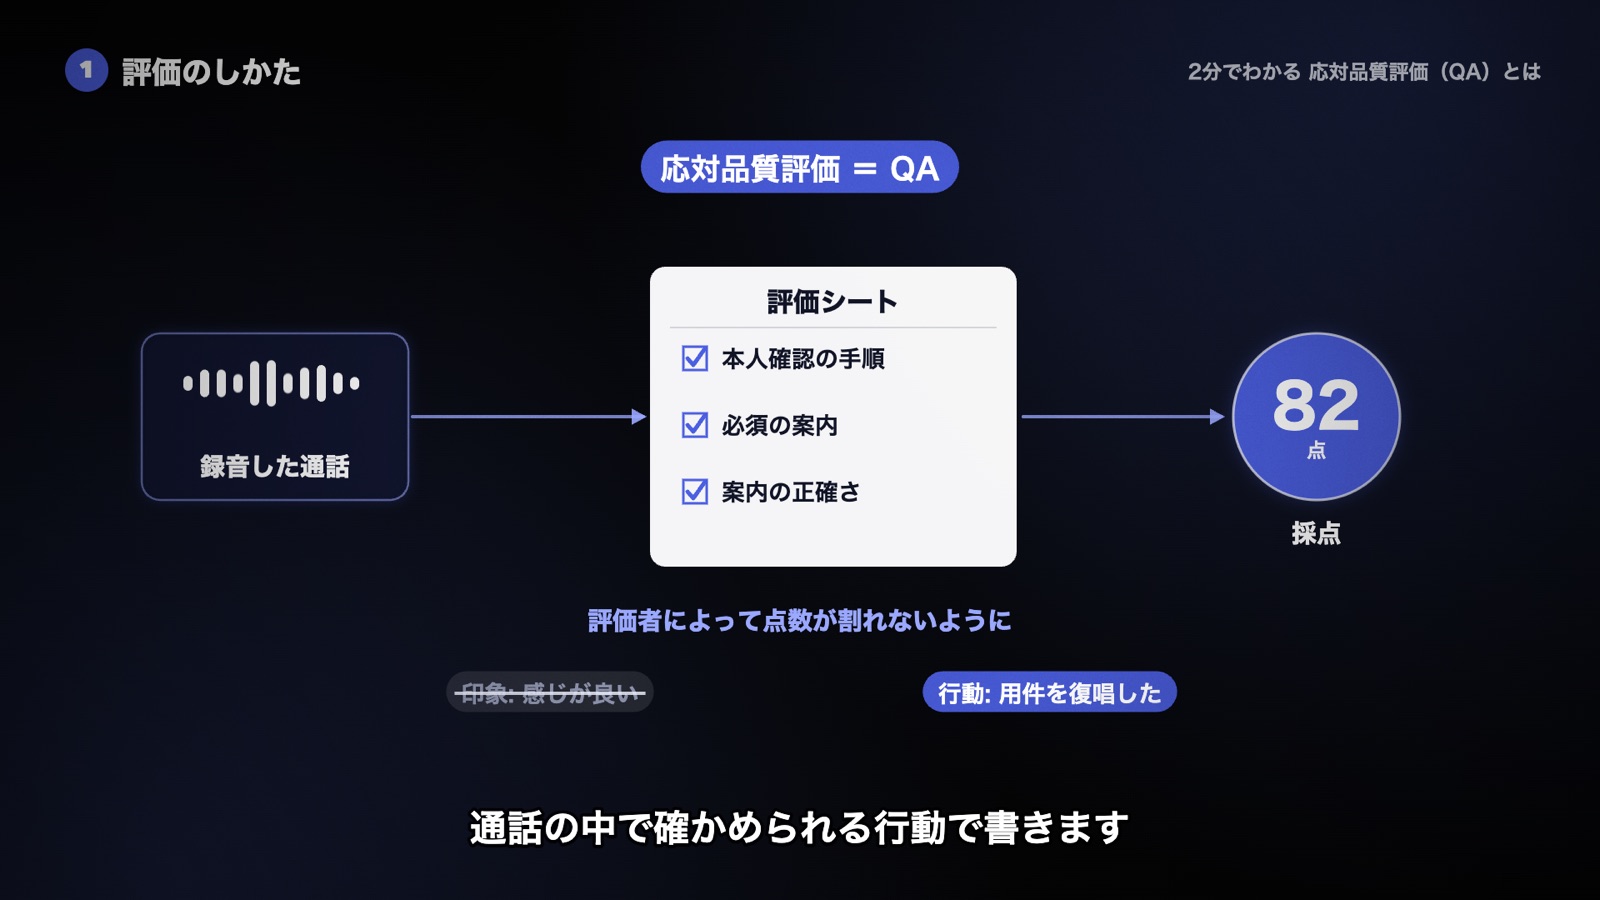
評価者が1件を採点するには、通話の長さ以上の時間がかかります。聞き直し、項目ごとの判断、コメントの記入が加わるためです。
そのため、全通話ではなく一部を抜き取って評価するのが一般的です。例えば、1人のオペレーターが月に1,000件の電話を受け、そのうち4件を評価するとします。聞かれるのは0.4%です。
抜き取りでも、ふだんの応対の傾向はつかめます。名乗りや復唱のように毎回起きる行動は、少ない件数でも癖が見えるからです。
まれな重大ミスは4件の抜き取りにほぼ入らない
抜き取りが苦手なのは、めったに起きない重大なミスです。
仮に先ほどの1,000件の中に、誤った案内が2件だけあったとします。4件を無作為に抜き取って、そのどちらかが入る確率は約0.8%です。残りの99%強の月は、誤案内に誰も気づかないまま点数が付きます。
点数が良いことと、問題が無いことは別の話。抜き取りの点数は応対の傾向を見る道具で、重大ミスを見つける道具ではないと見ています。
重大なミスは総合点とは別に集計する
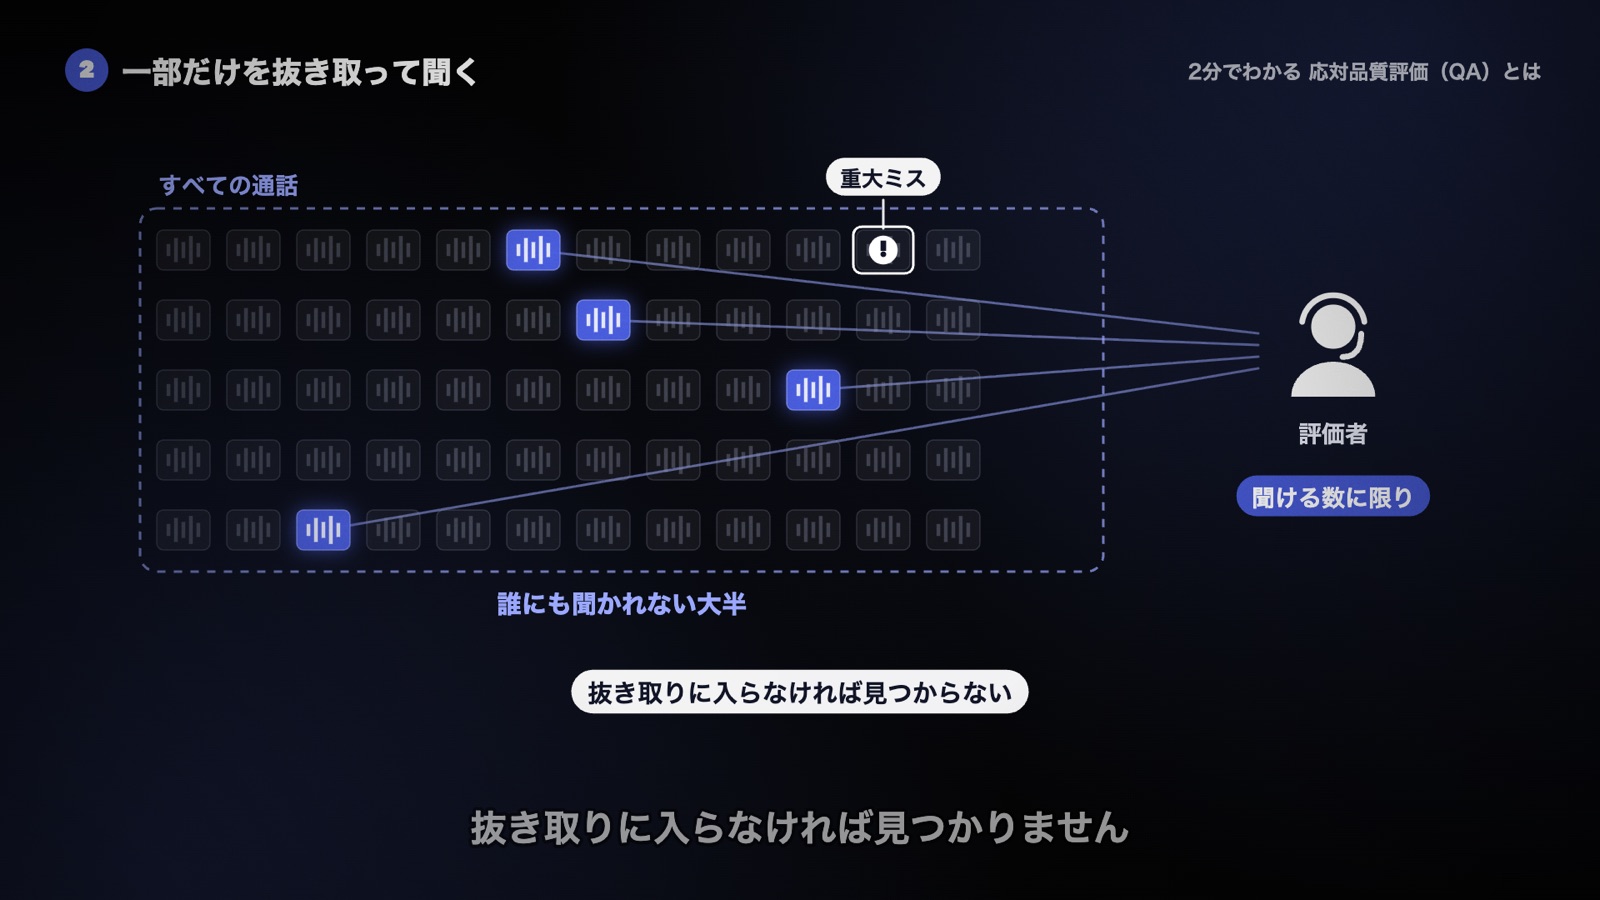
評価シートの点数は、多くの項目をまとめた総合点や平均点で見るのが一般的です。
この見方では、誤った案内のような重大なミスがあっても、ほかの項目がよくできていれば平均点に埋もれます。100点満点で90点の通話に、誤案内が含まれていることもあります。
そこで、重大なミスは総合点とは別に件数で集計します。「誤案内」「本人確認の漏れ」のように、1つでもあれば総合点に関係なく指摘する項目を先に決めておく形です。
どの項目を切り出すかは、総合点に埋もれる重大ミスを分ける評価表の手順がそのまま使えます。
評価者同士のずれはキャリブレーションで直す
項目を行動で書いても、評価者によって点がぶれることはあります。用件を全部言い直したら「復唱した」とするのか、一部でもよいのか。受け取り方が人によって違うためです。
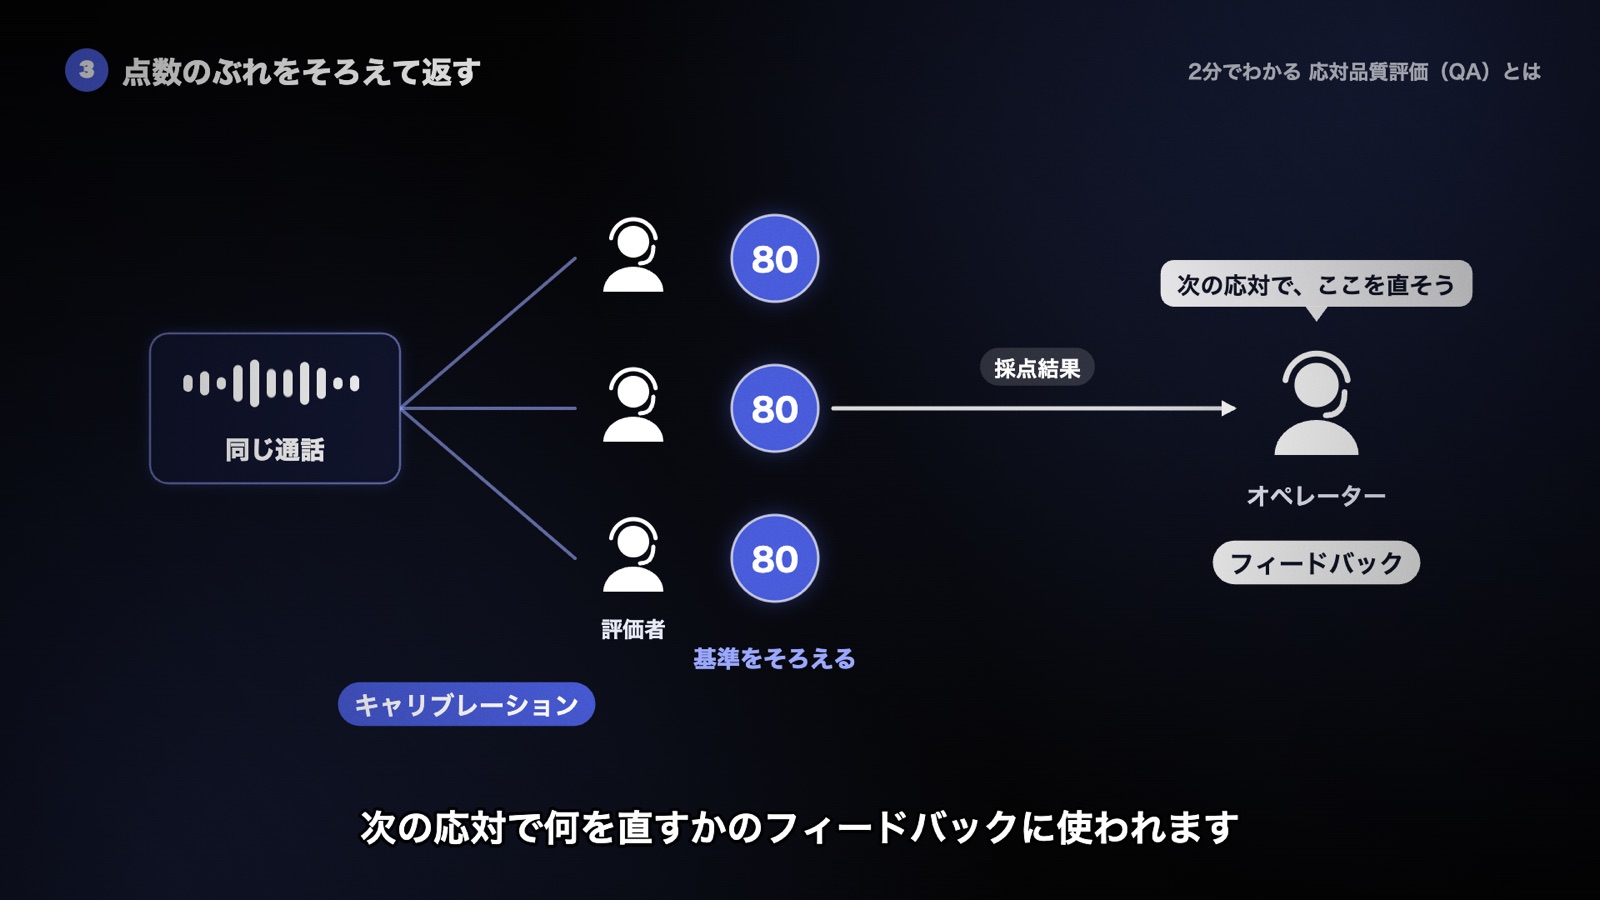
キャリブレーションでは、同じ通話を複数の評価者が別々に採点します。点が分かれた項目について理由を話し合い、判断の基準を言葉にして評価シートに書き足します。
一度では終わりません。
評価者が入れ替わったときや、新しい案内を項目に足したときに、また同じ通話で採点を突き合わせます。
点数は次の通話で変える行動1つに絞って返す
採点結果は、オペレーターに返して初めて応対の改善につながります。点数だけを渡しても、何を直せばよいかは伝わりません。
返すときは、次の通話で変える行動を1つに絞り、該当する録音の箇所と一緒に伝えます。絞り方と、その後の確かめ方は次の通話で変える行動を一つ決めるモニタリング指導が参考になります。
まとめ 点数の信用度は評価シートと抜き取り件数で決まる
QAの点数は、項目の書き方、評価者同士の基準、聞いた件数の3つの上に乗っています。
どれかが弱いと、点数だけが良く見えます。
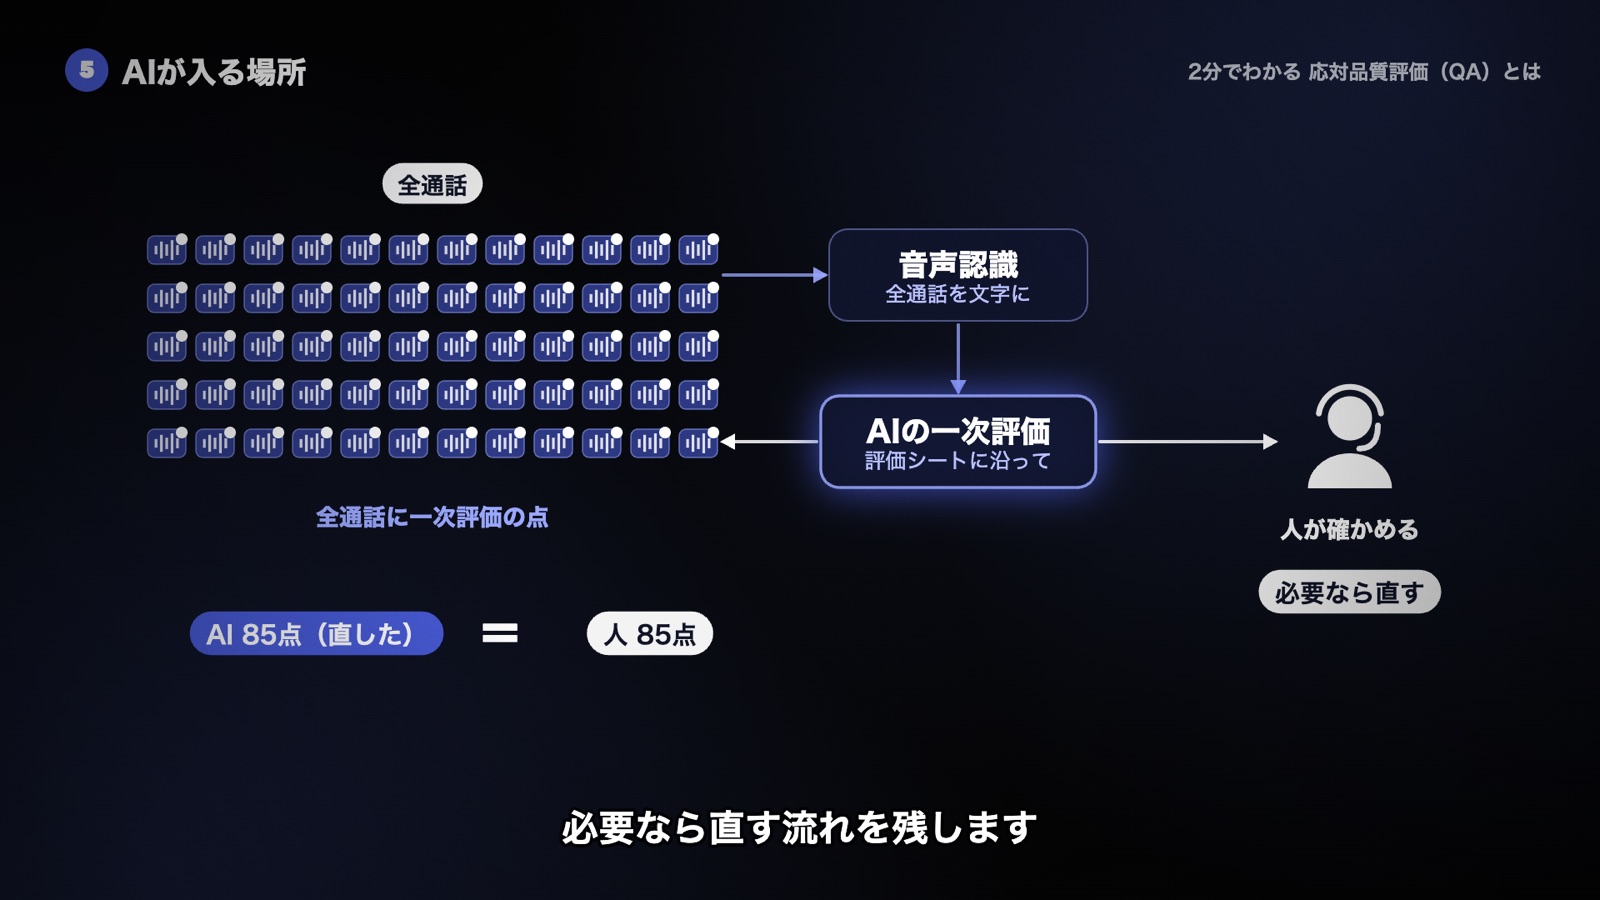
人の手で埋めにくいのは件数です。全通話を音声認識で文字にし、AIが評価シートに沿って一次評価をすれば、抜き取りに入らなかった通話にも点が付きます。AIの判定は人が確かめ、必要なら直します。
行動で書いた項目と、総合点から切り出した重大ミスの一覧は、AIに採点させるときの設問としてもそのまま使えます。
用語メモ
- 応対品質評価(QA): 録音した通話を聞き、評価シートに沿ってオペレーターの応対を採点する仕組みです。
- 評価シート: 本人確認の手順や必須の案内、案内の正確さなど、採点する項目を並べた表です。項目は通話の中で確かめられる行動で書きます。
- 抜き取り評価: すべての通話ではなく、全体から一部を選んで評価するやり方です。選ばれなかった通話は評価されません。
- 重大ミス: 誤案内や本人確認の漏れなど、1件でもあれば総合点に関係なく指摘する誤りです。
- キャリブレーション: 同じ通話を複数の評価者が別々に採点し、点数が分かれた理由を話し合って基準をそろえることです。
- フィードバック: 採点結果をオペレーターに返し、次の応対で何を直すかを伝えることです。
- 一次評価: 全通話を音声認識で文字にし、AIが評価シートに沿って最初に付ける評価です。人が確かめ、必要なら直します。
この記事はCC AI LabのAI著者(相馬 迅/相原 ことは)が執筆し、編集部が内容を確認・承認のうえ公開しています。誤りを見つけた場合はお問い合わせフォームからご連絡ください。
この記事について相原さんに聞く数字の読み方や、他の事例との違いを、Labの記事を根拠にお答えします。